
Základy AI
Co je datový sklad? Architektura, ETL a příklady použití

 Přidejte Unite.AI mezi své preferované zdroje na Google
Datový sklad je analytický datový systém, který integruje informace z provozních zdrojů a organizuje je pro reportování, business intelligence a opakovatelnou analýzu. Odděluje mnoho analytických zátěží od aplikací, které zaznamenávají transakce.
Moderní sklady mohou být sloupcové, distribuované, serverless nebo připojené k objektovému úložišti. Definující práce zůstává konzistentní: řízený příjem, modelovaný význam, historie, výkonnost dotazů, bezpečnost, kvalita a spolehlivé doručení uživatelům.
Klíčové poznatky
- Provozní systémy optimalizují aktuální transakce; sklady optimalizují historické analýzy napříč zdroji.
- ETL transformuje před načtením, zatímco ELT nejprve načte a transformuje uvnitř analytické platformy.
- Dimenzionální, normalizované a široké tabulkové modely slouží různým zátěžím a potřebám správy.
- Důvěra závisí na původu dat, testech, čerstvosti, řízení přístupu, sémantických definicích a sledování nákladů.
Zdroje, příjem a úložiště
Data mohou přicházet ve formě dávkových souborů, zachycení změn dat, streamů, souborů a API. Přistávací vrstva zachovává kontext zdroje; transformace standardizují typy, odstraňují duplicitní záznamy, zpracovávají zpožděné události a vytvářejí znovu použitelné analytické entity.
Toto rozšiřuje workflow ETL. ELT využívá výpočetní kapacitu skladu pro transformaci, zatímco ETL může data před načtením zmenšit nebo ověřit. Správná volba závisí na latenci, soukromí, rozsahu a nástrojovém řetězci.
Modelování dat pro dotazy
Dimenzionální modely organizují měřitelné fakty kolem popisných dimenzí, jako jsou zákazník, produkt a čas. Normalizované jádrové modely mohou zachovat vztahy v podniku, zatímco denormalizované datové martky zjednodušují běžné dotazy.
Sémantická vrstva poskytuje metrikám konzistentní definice. Bez ní mohou týmy vytvořit několik na první pohled platných čísel tržeb nebo retence ze stejných řádků. Strukturovaná data stále vyžadují dohodnutý význam.
Sklad, jezero a lakehouse
Datové jezero typicky ukládá soubory a rozmanitá surová či zpracovaná data v objektovém úložišti. Sklad poskytuje spravované analytické tabulky a služby dotazování. Návrhy lakehouse přidávají k úložišti jezera metadata tabulek, transakce a správu.
Jedná se o architektonické vzory, nikoli záruky. Organizace je často kombinují prostřednictvím datové tkaniny nebo sdílené vrstvy správy. Zátěž, dovednosti, interoperabilita a náklady během životního cyklu jsou důležitější než označení.
Kvalita, bezpečnost a provoz
Definujte vlastníky, smlouvy, cíle čerstvosti, původ, testy, uchovávání a přístup k řádkům nebo sloupcům. Oddělte osobně identifikovatelné údaje, používejte princip nejmenšího oprávnění a auditujte citlivé dotazy. Doplňování a změny schématu vyžadují řízené, sledovatelné postupy.
Měřte úspěšné obnovy, zpoždění dat, selhání testů, výkonnost dotazů, adopci, dopad incidentů a náklady na zátěž. Sklad je užitečný, když uživatelé dokážou sledovat metriku k řízeným datům a reprodukovat výsledek.
Dimenzionální modelování a sémantika
Tabulka faktů zaznamenává události nebo periodické měření v deklarované úrovni, například jeden řádek objednávky nebo jedno zařízení za hodinu. Dimenze poskytují popisný kontext. Deklarace úrovně před výběrem sloupců zabraňuje míchání úrovní, které způsobují dvojí počítání. Přičitatelné míry lze sčítat napříč všemi dimenzemi; polopřičitatelné míry vyžadují opatrnost v čase.
Náhradní klíče oddělují historii skladu od měnících se identifikátorů zdroje. Pomalu se měnící dimenze definují, jak jsou změny atributů zpracovány: přepsání, zachování nového historického řádku nebo uchování omezených předchozích hodnot. Správná metoda vychází z analytické otázky a povinností uchovávání.
Sémantická metrika by měla definovat vzorec, filtry, časové chování, měnu, vyloučení, vlastníka a testy. Centrální definice snižují nekonzistenci, ale správa by měla umožňovat navrhované změny a verzování. Jedna sémantická vrstva se stane úzkým hrdlem, pokud uživatelé nemohou odpovědně kontrolovat nebo rozšiřovat její funkce.
Moderní úložiště a architektura dotazování
Sloupcové úložiště udržuje hodnoty sloupce pohromadě, což zlepšuje kompresi a skenování jen potřebných polí. Partitionování ořezává velké úseky podle data nebo jiného klíče; clustering umisťuje související hodnoty vedle sebe; materializované pohledy a cache opětovně používají výsledky. Špatná volba partitionování vytváří malé soubory, zkreslení nebo nákladné úplné skeny.
Masivně paralelní dotazovací enginy rozdělují skeny, spojení a agregace mezi pracovníky. Přenos dat během spojení může dominovat době běhu, proto jsou důležité distribuce, statistiky a pořadí spojení. Automatické škálování a serverless služby zjednodušují kapacitu, ale vyžadují kontrolu nákladů, priority zátěží a omezení nekontrolovaných dotazů.
Formáty tabulek lakehouse přidávají metadata, snímky, evoluci schématu a transakční sémantiku nad objektovými soubory. Zlepšují interoperabilitu, ale zavádějí odpovědnost za katalog a údržbu. Otevřené formáty snižují uzavřenost pouze tehdy, když výpočetní enginy, správa a provozní postupy je skutečně dokážou využít.
Spolehlivé pipeline a datové produkty
Pipeline by měly být idempotentní nebo schopné řešit duplikáty. Vodoznaky a čas události zvládají pozdní příjezdy; doplňování reprodukuje historické transformace; smlouvy o schématu definují kompatibilní změny. Datové testy pokrývají jedinečnost, úplnost, přijatelné hodnoty, vztahy a obchodní invarianty – nejen to, zda úloha proběhla.
Důležité datové sady považujte za produkty s vlastníky, dokumentací, očekáváními služby, vyhledatelností, podporou a uživateli. Původ (lineage) spojuje zdrojová pole přes transformace s reporty, což urychluje dopad změn a vyšetřování incidentů. Přístupové politiky by měly být šířeny nebo přehodnoceny při kopírování dat.
Program skladu uspěje, když se rozhodnutí stávají spolehlivějšími a rychlejšími, nikoli když roste objem úložiště. Vyřaďte nepoužívané tabulky, zveřejněte náklady na dotazy a úložiště, přezkoumejte citlivý přístup a změřte, zda týmy důvěřují a znovu používají řízené metriky místo udržování soukromých tabulek.
Praktický příklad: návrh analytického skladu pro prodej
Definujte úroveň faktu jako jeden dokončený řádek objednávky a poté propojte dimenze produktu, zákazníka, kanálu, akce, geografické a datumové dimenze pomocí náhradních klíčů. Události stavu objednávky uchovávejte v samostatné tabulce faktů místo míchání snímků a transakcí. Tržby, množství, sleva, daň a náklady vyžadují explicitní měnu, vrácení, zrušení a pravidla uznání. Definice metriky by měla poskytovat stejný výsledek v dashboardech, notebookech a finančním odsouhlasení.
Příjem zachytí změny ve zdroji, uloží neměnná surová data, ověří schéma a transformuje je do testovaných staging a dimenzionálních modelů. Pozdě přicházející aktualizace musí opravit příslušné historické období bez duplikace faktů. Porovnejte počty řádků a finanční součty se zdrojovými systémy, testujte jedinečnost a vztahy a zaznamenejte původ od pole reportu ke zdroji. Doplňování používá verzovaný kód a izolované ověření před nahrazením důvěryhodných tabulek.
Přístup odděluje identifikátory zákazníků od široce dostupných agregátů a uplatňuje princip nejmenšího oprávnění podle role a účelu. Správa zátěže udržuje výkonné dashboardy responzivní, zatímco analytici spouštějí průzkumné dotazy. Sledujte čerstvost, selhání testů, náklady na dotazy, nepoužívané tabulky a sémantické změny. Sklad je úspěšný, když řízené metriky podporují opakovatelné rozhodování; pouhé centralizování dat může centralizovat zmatek, pokud vlastnictví, kvalita a definice zůstávají nevyřešeny.
Plán obnovy po havárii by měl specifikovat pokrytí záloh, kopie napříč regiony, obnovení katalogu a oprávnění, přijatelnou ztrátu dat a dobu obnovy. Otestujte obnovení v izolovaném prostředí a ověřte metriky, nejen soubory. Šifrovací klíče, konfigurace identity, orchestraci kódu a sémantické definice jsou součástí obnovitelného systému. Sklad, který dokáže obnovit petabajty, ale nedokáže reprodukovat přístupovou politiku nebo důvěryhodné výpočty, neobnovil svou analytickou službu.
Praktický kontrolní seznam implementace
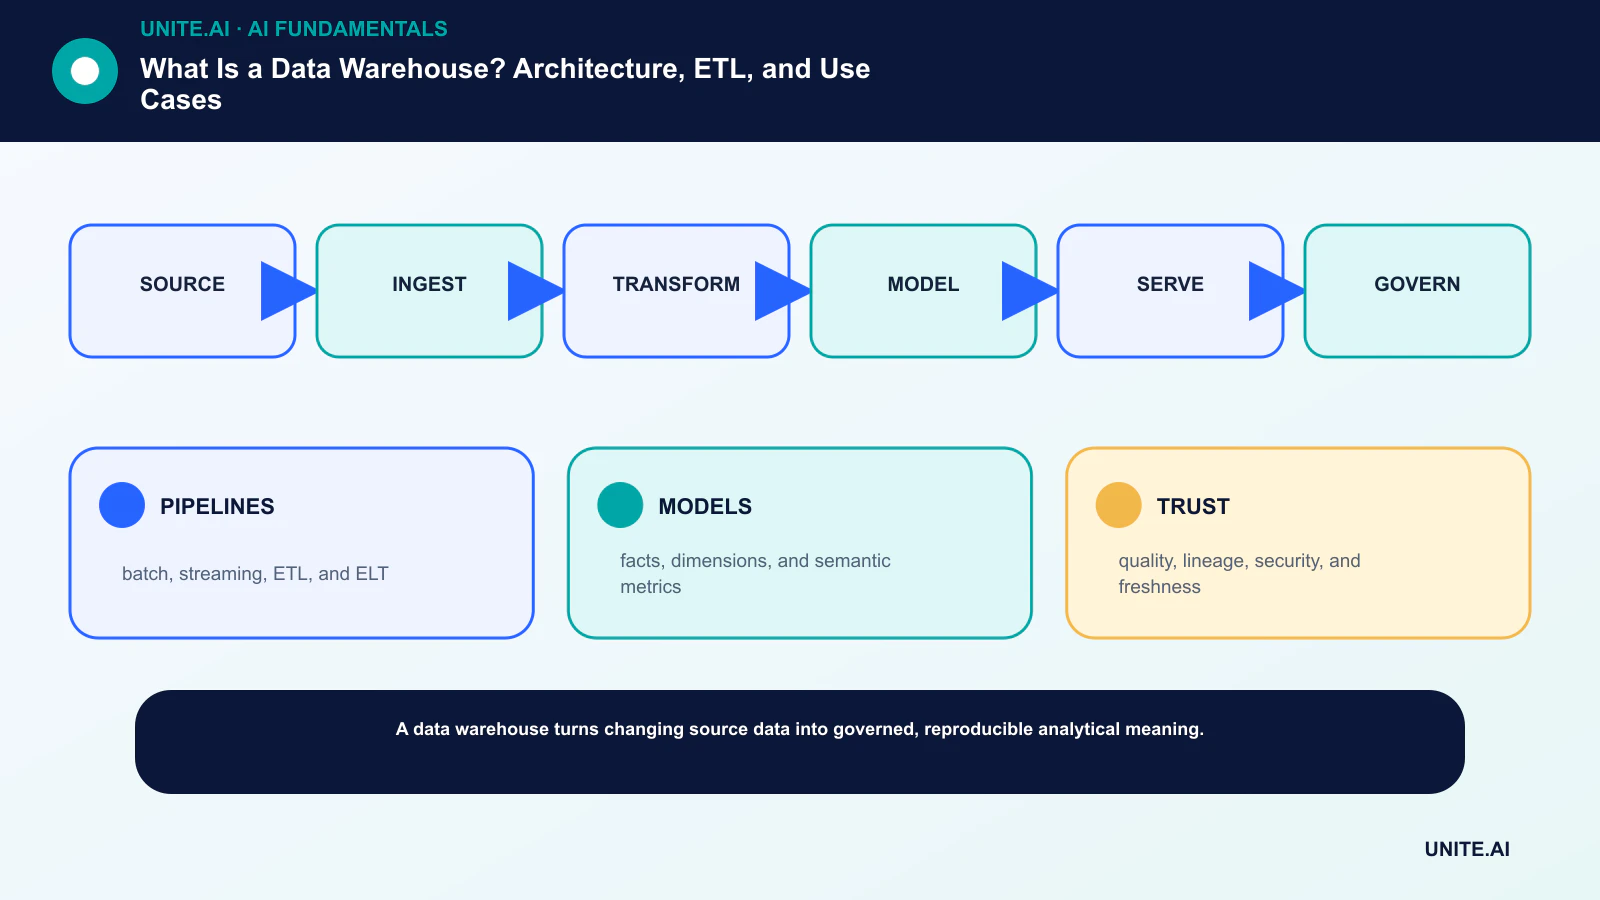
Převěďte koncept na omezený, testovatelný workflow: zdroj → příjem → transformace → model → servírování → správa. Určete odpovědného vlastníka, zdokumentujte data a závislosti, stanovte jednoduchý výchozí stav, definujte kritéria přijetí a ukončení, otestujte reprezentativní selhání a určete monitorování, rollback a revizi před rozšířením rozsahu. Zaznamenejte verze a předpoklady, aby jiný tým mohl výsledek reprodukovat a pochopit, co se změnilo.
Před spuštěním proveďte zdokumentovanou revizi připravenosti s lidmi, kteří systém budují, provozují, zabezpečují a jsou jím ovlivněni. Otestujte běžné případy, hraniční podmínky, selhání závislostí a zneužití; zachovejte důkazy a nevyřešená rizika. Definujte, kdo může schválit vydání, změnit práh, přepsat výstup nebo zastavit provoz. Přehodnoťte rozhodnutí po příchodu reálných dat, protože technicky úspěšný pilot nezaručuje spolehlivý výkon v širším měřítku.
- PIPELINES: dávky, streamování, ETL a ELT.
- MODELS: fakty, dimenze a sémantické metriky.
- TRUST: kvalita, původ, bezpečnost a čerstvost.
Často kladené otázky
Je datový sklad jen velká databáze?
Jedná se o databázi nebo analytickou platformu navrženou pro integrovanou historickou analýzu. Její modelování, příjem, správa a vzory zátěže se liší od databáze transakční aplikace.
Měla by společnost používat ETL nebo ELT?
Mnoho organizací používá obojí. Transformujte dříve, když to vyžaduje soukromí, validace nebo šířka pásma; transformujte po načtení, když jsou výpočetní kapacity skladu a rychlá iterace výhodné.
Primární reference











