Základy AI
Co jsou velké jazykové modely (LLM)?

 Přidejte Unite.AI mezi své preferované zdroje na Google
Velký jazykový model (LLM) je neuronová síť trénovaná na rozsáhlých sbírkách sekvencí za účelem predikce tokenů nebo souvisejících jazykových úkolů. Většina současných LLM používá architektury transformerů a dokáže generovat, klasifikovat, shrnovat, překládat, vyhledávat a transformovat jazyk prostřednictvím společného rozhraní.
LLM není databáze ani zaručený dedukční systém. Jeho výstup je podmíněná predikce formovaná trénovacími daty, následným tréninkem, kontextem, nástroji a dekódováním. Plynulost může koexistovat s faktickými chybami, nejistotou, zaujatostí nebo nebezpečným chováním.
Klíčové body
- Tokenizace převádí text na diskrétní jednotky; embeddingy a attention vytvářejí kontextové reprezentace.
- Předtrénování se učí obecné vzory, zatímco doladění a metody preferencí formují chování úlohy.
- Vyhledávání a nástroje mohou přidat aktuální důkazy nebo akce, ale vyžadují samostatná oprávnění a validaci.
- Vyhodnoťte nasazený systém z hlediska kvality, zakotvení, bezpečnosti, latence, nákladů a driftu.
Tokeny, transformery a předtrénování
Text je rozdělen na tokeny. Transformer je mapuje na vektory, míchá informace pomocí attention a feed-forward vrstev a vytváří pravděpodobnostní distribuci nad dalším nebo chybějícím tokenem.
Cíle samosupervize vytvářejí tréninkové signály z čistých sekvencí. Škálování parametrů, dat a výpočetního výkonu může předvídatelně snižovat ztrátu v různých rozsazích, ale kvalita datové sady, architektura, optimalizace a hodnocení určují, jaké schopnosti se v praxi objeví.
Následný trénink a inferenční fáze
Ladění instrukcí používá demonstrace; optimalizace preferencí může výstupy lépe sladit s lidským hodnocením nebo politikou. V inferenci prompt a historie konverzace definují kontext, zatímco teplota a nastavení vzorkování ovlivňují variabilitu.
RLHF a podobné metody formují chování spíše než instalují kompletní faktický kontrolor. Model může stále generovat věrohodnou, ale nepodloženou odpověď.
Vyhledávání, nástroje a agenti
Generování rozšířené o vyhledávání poskytuje pasáže vybrané z externí kolekce. Volání nástrojů umožňuje aplikačnímu kódu dotazovat databáze, počítat, vyhledávat nebo jednat. Tyto vzorce oddělují část znalostí a vykonávání od vah modelu.
Aplikace musí validovat argumenty nástrojů, vynucovat oprávnění, zachovávat citace a považovat získaný obsah za nedůvěryhodný vstup. Vyhledávání vektorové podobnosti pomáhá při vyhledávání, ale neprokazuje, že pasáž podporuje odpověď.
Omezení a hodnocení
LLM mohou halucinovat, odhalovat zapamatovaný obsah, následovat škodlivé instrukce, reprodukovat zaujatost a selhávat u úloh, které se zdají podobné tréninkovým příkladům. Dlouhý kontext nezaručuje, že každý fakt bude použit nebo správně sladěn.
Hodnoťte na reprezentativních soukromých úlohách s dokumentovanými prompty a verzemi. Měřte podporu ze zdrojů, odmítnutí, kalibraci, bezpečnost, výsledky podskupin, pracovní zátěž lidí, latenci a náklady. Sledujte po vydání, protože modely, data a chování uživatelů se mění.
Tréninková data a vývoj modelu
Korpusy pro předtrénování kombinují webové stránky, knihy, kód, akademický materiál, konverzace a licencované či kurátorské zdroje. Pipelines detekují jazyk, odstraňují duplicity, filtrují kvalitu a nebezpečný obsah, zpracovávají osobní data a volí váhy směsí. Tyto volby formují znalosti, jazykové pokrytí, styl, zaujatost a memorování.
Optimalizační procesy dávkují tokenové sekvence a minimalizují predikční ztrátu pomocí gradientního sestupu. Distribuovaný trénink rozděluje data, modelové tensory, fáze pipeline nebo experty napříč akcelerátory. Ukládání checkpointů, numerická stabilita, síťová komunikace a zotavení po chybě se ve velkém měřítku stávají hlavními inženýrskými problémy.
Hodnocení během tréninku sleduje ztrátu a sady schopností, ale kontaminace benchmarků může výsledky nafouknout. Vyčleňte časové období a proprietární úlohy, hledejte překryvy a uvádějte přesné prompty, dekódování, nástroje a skórování. Model může zlepšit průměrnou ztrátu, zatímco regresní jevy se objeví v oblasti bezpečnosti nebo u jazyků s nízkými zdroji.
Kontextová okna, dekódování a inferenční fáze
V inferenci cache klíč‑hodnota ukládá projekce attention pro předchozí tokeny, takže je není nutné přepočítávat při každém kroku. Paměť cache roste s počtem vrstev, sekvencí, batchů a reprezentací. Kvantizace a stránkování snižují zátěž, ale mohou měnit kvalitu nebo latenci.
Chamtivé dekódování vybírá token s nejvyšší pravděpodobností; teplota přepočítává pravděpodobnosti; top‑k a top‑p omezují množinu kandidátů; beam search sleduje několik sekvencí. Nejlepší strategie závisí na tom, zda úloha oceňuje determinismus, rozmanitost, strukturovaný výstup nebo pravděpodobnost sekvence. Vždy po generování validujte schéma.
Dlouhý kontext zvyšuje množství dostupných informací, ne však zaručené vybavení nebo uvažování. Pozice, rušivé elementy, rozpor a struktura promptu ovlivňují využití. Vyhledávání může vybrat menší sadu důkazů, zatímco sumarizace komprimuje historii s rizikem ztráty detailů. Měřte výkon napříč délkou a umístěním kontextu.
Adaptace, nasazení a ekonomika
Plné doladění aktualizuje všechny parametry; parametricky úsporné metody aktualizují adaptéry nebo nízkoprvkové matice; pokračující předtrénování přizpůsobuje doménové rozdělení; ladění instrukcí a preferencí formuje odpovědi. Vyhledávání je často lepší pro často se měnící fakta, zatímco ladění je lepší pro chování a formát úlohy. Metody lze kombinovat.
Možnosti nasazení zahrnují hostované API, spravované koncové body, samostatně hostované otevřené váhy, modely na zařízení a hybridy. Porovnejte zacházení s daty, správu verzí, latenci, propustnost, regiony, dostupnost, přenositelnost modelu, podporu a celkové náklady. Samo‑hostování přenáší odpovědnost za bezpečnost, škálování, aktualizace a monitorování zneužití.
Náklad na token není úplný. Slabý model může vyžadovat opakování, delší prompty, více revizí nebo drahé chyby. Měřte náklad na úspěšně dokončený úkol při požadované kvalitě a úrovni rizika. Používejte cache, batchování, menší směrované modely a deterministický kód tam, kde zlepšují celý pracovní tok.
Ukázkový příklad: zakotvení LLM v podnikových dokumentech
Asistent dokumentů by měl začít s korpusem, který respektuje oprávnění, stabilními identifikátory dokumentů, verzemi a daty účinnosti, parsovatelnou strukturou a evaluační sadou odpověditelných, neodpověditelných, nejednoznačných a konfliktních otázek. Vyhledávací indexy rozdělují dokumenty na úseky a metadata, ale velikost úseku a překrytí musí odpovídat struktuře dokumentu. Kvalita vyhledávání se měří nezávisle před generováním, takže plynulý model nemůže skrýt chybějící důkazy.
V době běhu autentizujte uživatele, filtrujte vyhledávání podle přístupu, načtěte a přehodnoťte důkazy, vytvořte omezený prompt, vygenerujte citovanou odpověď a ověřte požadovaný výstup. Model by měl uvést, když se zdroje rozcházejí nebo nepodporují odpověď. Používání nástrojů a externích akcí vyžaduje samostatné oprávnění. Chraňte se před instrukcemi vloženými do vyhledaných dokumentů tím, že obsah považujete za data, nikoli za systémovou politiku s vyšší prioritou.
Vyhodnoťte recall vyhledávání, přesnost citací, správnost odpovědí, zakotvení, odmítnutí, latenci a náklady napříč rolemi a typy dokumentů. Sledujte verze modelu, promptu, indexu, parseru a korpusu pro každý test. V produkci zaznamenávejte ID důkazů a zpětnou vazbu bez odhalování soukromého textu, monitorujte nově neodpověditelné otázky po změnách obsahu a udržujte bezpečnou náhradní možnost. Rozhraní LLM nenahrazuje správu záznamů, řízení přístupu ani odpovědnou revizi odborníků.
Plánování kapacity by mělo modelovat rozdělení délky promptů a výstupů, souběžné uživatele, chování cache, latenci nástrojů a míru opakování. Streamování zlepšuje vnímanou latenci, ale komplikuje moderaci a zrušení, protože nebezpečný nebo nesprávný obsah může uživatele dosáhnout před kontrolou celé odpovědi. Nastavte rozpočty tokenů a nástrojů, izolujte nájemce, chraňte přihlašovací údaje poskytovatele a nacvičte přepnutí mezi verzemi modelu, aniž by se tiše změnilo chování, na které uživatelé spoléhají.
Praktický kontrolní seznam implementace
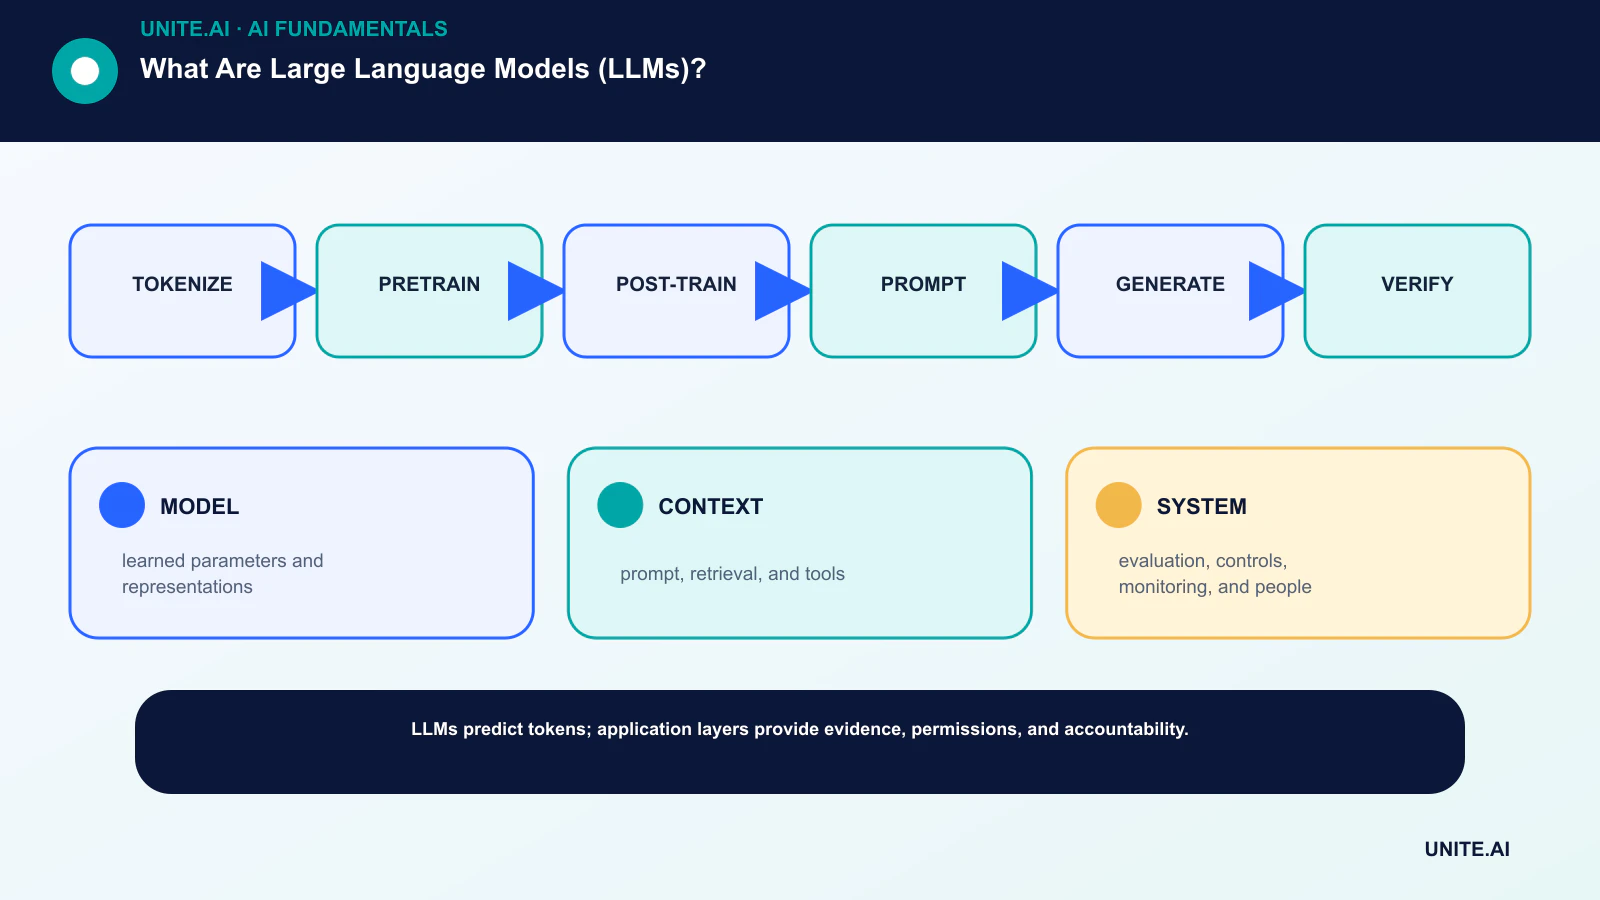
Přeměňte koncept na omezený, testovatelný pracovní tok: tokenizace → předtrénování → následný trénink → prompt → generování → ověření. Určete odpovědnou osobu, zdokumentujte data a závislosti, vytvořte jednoduchý výchozí stav, stanovte kritéria přijetí a ukončení, otestujte reprezentativní selhání a definujte monitorování, rollback a revizi před rozšířením rozsahu. Zaznamenejte verze a předpoklady, aby jiný tým mohl výsledek reprodukovat a pochopit, co se změnilo.
Před spuštěním proveďte dokumentovanou revizi připravenosti s lidmi, kteří systém budují, provozují, zabezpečují a jsou jím ovlivněni. Otestujte normální případy, hraniční podmínky, selhání závislostí a zneužití; zachovejte důkazy a nevyřešená rizika. Definujte, kdo může schválit vydání, změnit prahovou hodnotu, přepsat výstup nebo zastavit provoz. Přehodnoťte rozhodnutí po získání reálných dat, protože technicky úspěšný pilot nezaručuje spolehlivý výkon v širším měřítku.
- MODEL: naučené parametry a reprezentace.
- CONTEXT: prompt, vyhledávání a nástroje.
- SYSTEM: hodnocení, kontroly, monitorování a lidé.
Často kladené otázky
Proč se LLM nazývají velké?
Neexistuje univerzální prahová hodnota parametrů. „Velké“ odkazuje na měřítko ve srovnání s dřívějšími jazykovými modely, včetně počtu parametrů, trénovacích dat, výpočetního výkonu a šíře využití.
Rozumí LLM jazyku?
Vytvářejí užitečné vnitřní reprezentace a vykazují komplexní chování, ale slovo „rozumět“ má několik významů. Výkon by měl být demonstrován úloha po úloze, nikoli odvozen z plynulosti.
Primární reference