Základy AI
Co je Emotion AI (afektivní výpočet) a proč je důležitá?

 Přidejte Unite.AI mezi své preferované zdroje na Google
Emotion AI, často nazývaná afektivní výpočet, používá výpočetní techniky na signály spojené s afektem, jako jsou jazyk, vokální prosodie, pohyby obličeje, postoj, fyziologie nebo vzorce interakce. Systém může klasifikovat štítek, odhadovat dimenze jako valence a arousal, nebo přizpůsobovat rozhraní.
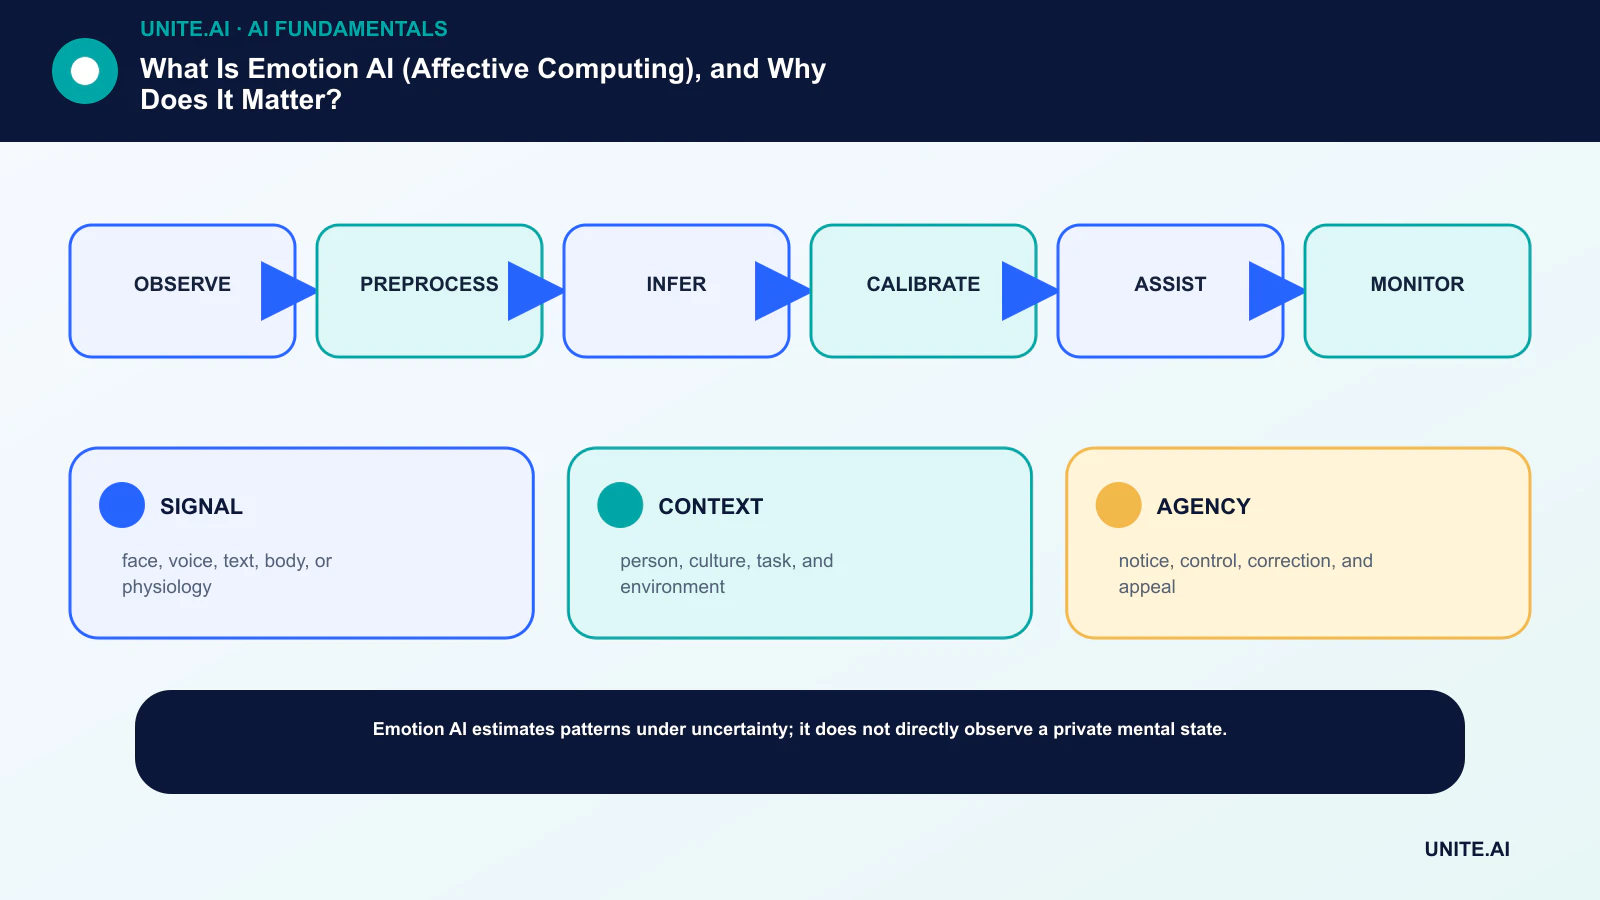
Výstup je inferencí – nikoli přímým čtením vnitřního emočního stavu. Výrazy se liší podle osoby, kultury, kontextu, zdraví a situace, takže stejný pozorovatelný signál může mít několik vysvětlení. Použití v kritických situacích vyžaduje silné důkazy, souhlas a právní přezkum.
Klíčové poznatky
- Přesně definujte pozorovatelný cíl; emoce, výraz, sentiment, stres a zapojení nejsou zaměnitelné.
- Validujte na zamýšlené populaci a prostředí, ne jen na kurátorsky vytvořeném benchmarku.
- Upřednostňujte asistenci a kontrolu uživatele před skrytou surveillancí nebo následným automatickým hodnocením.
- Dokumentujte nejistotu, práva k datům, uchovávání, výkonnost podskupin a cestu k napadení rozhodnutí.
Signály a cíle modelu
Textové modely mohou odhadovat vyjádřený sentiment; audio modely využívají načasování, výšku tónu a energii; vizuální modely analyzují pohyby; fyziologické systémy mohou používat srdeční frekvenci nebo kožní vodivost. Multimodální systémy kombinují signály, ale více senzorů automaticky nevede k pravdivějšímu štítku.
Štítek jako „frustrovaný“ závisí na instrukcích anotace a kontextu. Analýza sentimentu slov je užší než odhadování emočního stavu osoby a žádný z nich by neměl být zaměňován s klinickým hodnocením.
Proč kontext a nejistota dominují
Lidé maskují, přehánějí nebo vyjadřují pocity různě. Postižení, jazyk, osvětlení, kvalita mikrofonu a sociální normy mohou měnit pozorované signály. Laboratorní datové sady nemusí reprezentovat call centrum, učebnu, vozidlo nebo kliniku.
Vyhodnoťte kalibraci, abstenci, chyby podle skupin, výkon napříč doménami a alternativy. Matrice záměn pomáhají ukázat, které štítky jsou zaměněny, ale je potřeba kvalitativní revize k pochopení důvodů.
Užitečné a rizikové aplikace
Aplikace řízené uživatelem mohou podpořit přístupnost, reflexivní deníky, adaptivní výcvik nebo bezpečnostní upozornění. Tyto využití by měly jasně uvádět, co se měří, umožňovat korekci a vyhýbat se přehánění jistoty.
Rozhodnutí v oblasti zaměstnání, vzdělávání, pojištění, policie a zdravotnictví představují mnohem vyšší sázky. Zákon EU o AI zakazuje určité využití rozpoznávání emocí na pracovištích a ve vzdělávání, s výjimkami, a klasifikuje další použití podle rizika. Požadavky se liší podle jurisdikce a časem se mění.
Zodpovědné nasazení
Zeptejte se, zda úloha vůbec potřebuje inferenci emocí. Používejte minimalizaci dat, explicitní účel, krátké uchovávání, zabezpečení, nezávislé testování, upozornění uživatele a lidskou revizi. Vyhněte se vytváření sekundárních profilů ze signálů shromážděných pro jiný účel.
Uplatňujte praktiky vysvětlitelné AI bez naznačování, že mapa saliency dokazuje emoci. Komunikujte nejistotu srozumitelným jazykem a nabídněte smysluplný způsob, jak se odhlásit nebo napadnout následný výsledek.
Jak je afekt reprezentován
Kategorické modely předpovídají štítky jako radost, hněv, strach, smutek nebo neutrální. Dimenzionální modely odhadují kontinuální hodnoty jako valence, arousal a dominance. Modely hodnocení popisují, jak osoba hodnotí událost. Tyto reprezentace jsou teorie a volby měření, nikoli zaměnitelná pravda.
Anotace mohou pocházet od osoby prožívající událost, pozorovatele, klinika nebo experimentálního protokolu. Sebehlášení má limity introspekce a paměti; štítky pozorovatele odvozují stav z chování; fyziologická měření odrážejí arousal a mnoho neemočních procesů. Datová sada by měla uvádět, z jaké perspektivy štítek představuje.
Časové modelování je důležité, protože afekt se rozvíjí v čase. Štítky obličejových snímků mohou přehnaně reagovat na přechodný pohyb, zatímco průměr na úrovni výpovědi může změny skrýt. Délka okna, synchronizace napříč senzory, chybějící kanály a výchozí hodnoty mluvčího ovlivňují výsledek.
Modelovací pipeline podle modality
Vizuální pipeline detekuje a zarovnává tváře nebo těla, extrahuje snímky nebo klíčové body a poté klasifikuje prostorové a časové rysy. Zakrytí, úhel kamery, komprese, odstín pleti, brýle, rozdíly ve tváři a záměrný výraz mohou výkon ovlivnit. Jednotky obličejové akce popisují pohyb přímoji než deklarovaná emoce a mohou být bezpečnějším cílem.
Audio pipeline odděluje řeč, normalizuje úroveň a modeluje spektrální, prosodické a časové vzory. Zvýšená výška tónu může naznačovat nadšení, stres, otázku nebo zvyk mluvčího. Textové pipeline zachycují vyjádřené hodnocení a kontext, ale ztrácejí tón, pokud nejsou kombinovány s audiem. Multimodální fúze může probíhat na úrovni rysů, rozhodnutí nebo vrstev cross-attention.
Personalizace může kalibrovat na individuální základní úroveň, ale vyžaduje více dat a vytváří citlivý dlouhodobý profil. Systémy by měly upřednostňovat lokální nebo krátkodobou adaptaci, kde je to možné, a musí se vyhnout používání dat jedné osoby k nesouvisejícím inferencím bez platného účelu.
Hodnocení, lidské faktory a zabezpečení
Náhodné rozdělení snímků ze stejného videa mezi trénink a test vytváří únik informací. Vyčleňte osoby, seance, zařízení, místa a časová období podle zamýšleného tvrzení. Uveďte makro metriky, aby běžné třídy nezakrývaly selhání u vzácných stavů, a zahrňte možnost abstinence pro nejednoznačný vstup.
Uživatelské studie by měly měřit, zda adaptace skutečně pomáhá. Rozhraní, které mění tón na základě nesprávné inference, může působit vtíravě nebo patronizujícím způsobem. Umožněte uživatelům systém opravit, zvolit míru adaptace a vidět funkční důvod reakce, aniž by jim byl přiřazen definitní emoční štítek.
Nasazení s vysokým rizikem vyžaduje posouzení dopadu, právní přezkum, zabezpečení a zákaz sekundárních využití. Ukládejte surové video nebo biometrické údaje jen když je to nezbytné, omezte přístup a definujte mazání. Nepoužívejte skóre emocí jako jediný důkaz pro podvod, výkon, kompetenci, úmysl nebo duševní zdraví.
Hodnocení případu použití emotion-AI před nasazením
Začněte definováním tvrzeného konstruktu: pohyb obličeje, vokální prosodie, sebehlášený pocit, pozorované chování nebo klinický stav nejsou zaměnitelné. Identifikujte rozhodnutí, které bude výstup používat, a zda může sloužit méně vtíravý signál. Systém, který přizpůsobuje obtížnost hry na základě explicitní zpětné vazby frustrace, má jiný profil důkazů a rizik než ten, který odhaduje poctivost zaměstnance z webkamery.
Validace vyžaduje reprezentativní osoby, kultury, jazyky, zařízení, kontexty a podmínky nahrávání, s pravdou odpovídající tvrzení. Porovnejte s jednoduchými baseline a uveďte nejistotu, chybu podskupin, neshodu mezi hodnotiteli a výkon mimo laboratoř. Nepřevádějte pravděpodobnostní skóre na kategorické tvrzení o tom, co osoba cítí. Poskytněte uživatelům možnost korekce, odhlášení a nebiometrické cesty, kde je to možné.
Zakazujte následná rozhodnutí založená výhradně na odhadované emocí, zejména v zaměstnání, vzdělávání, pojištění, policii, zdravotní péči a přístupu ke službám. Minimalizujte uchovávání surového audia a videa, izolujte biometrické identifikátory a kontrolujte sekundární využití. Dokumentace by měla vysvětlit kontext tréninku, zamýšlené použití, neplatná využití a známé rušivé faktory jako postižení, maskování, stres, kultura nebo medikace. Emotion AI je tvrzení o měření, které vyžaduje důkazy, nikoli magické okno do vnitřní zkušenosti.
Praktický kontrolní seznam implementace
Přeměňte koncept na omezený, testovatelný pracovní postup: pozorovat → předzpracovat → inferovat → kalibrovat → asistovat → monitorovat. Určete odpovědnou osobu, dokumentujte data a závislosti, vytvořte jednoduchý baseline, stanovte kritéria přijetí a zastavení, otestujte reprezentativní selhání a definujte monitorování, rollback a revizi před rozšířením rozsahu. Zaznamenejte verze a předpoklady, aby jiný tým mohl výsledek reprodukovat a pochopit, co se změnilo.
Před spuštěním proveďte dokumentovaný přezkum připravenosti s lidmi, kteří systém staví, provozují, zabezpečují a jsou jím ovlivněni. Otestujte normální případy, hraniční podmínky, selhání závislostí a zneužití; uchovejte důkazy a nevyřešená rizika. Definujte, kdo může schválit vydání, změnit práh, přebít výstup nebo zastavit provoz. Přehodnoťte rozhodnutí po příchodu reálných dat, protože technicky úspěšný pilot nezaručuje spolehlivý výkon v širším měřítku.
- SIGNAL: tvář, hlas, text, tělo nebo fyziologie.
- CONTEXT: osoba, kultura, úkol a prostředí.
- AGENCY: upozornění, kontrola, korekce a odvolání.
Často kladené otázky
Umí AI přesně číst emoce z obličeje?
Může předpovídat štítky datové sady na základě obličejových pohybů, ale tyto pohyby neurčují jednoznačně vnitřní emoci. Přesnost silně závisí na kontextu, populaci, štítcích a návrhu měření.
Je emotion AI legální?
Záleží na použití, datech, lidech a jurisdikci. Některé kontexty jsou zakázány nebo představují vysoké riziko. Organizace potřebují aktuální právní poradenství, nikoli obecný technický kontrolní seznam.
Primární reference