
Základy AI
Co je vysvětlitelná AI?

 Přidejte Unite.AI mezi své preferované zdroje na Google
Explainable AI (XAI) zahrnuje metody a postupy, které pomáhají lidem pochopit chování nebo výstup systému AI. Vysvětlení může popsat vlivné vstupy, ukázat podobný příklad, představit kontrafaktuální změnu, shrnout globální pravidlo nebo sdělit, kdy systém neví.
Neexistuje univerzálně nejlepší vysvětlení. Vývojář ladící model, auditor testující soulad s politikou a osoba ovlivněná rozhodnutím potřebují různé důkazy. Vysvětlení je tedy třeba hodnotit podle přesnosti, významu a zamýšleného použití – ne jen podle vizuální přitažlivosti.
Klíčové poznatky
- Transparentnost popisuje dostupné informace; interpretovatelnost se týká významu; vysvětlení komunikuje důkazy nebo důvody.
- Celoobecné metody shrnují model, zatímco lokální metody se zabývají jednou predikcí nebo malým regionem.
- Post-hoc vysvětlení může být užitečné, ale může být nestabilní nebo nepravdivé vůči podkladovému modelu.
- Vysvětlení neprokazuje spravedlnost, kauzalitu, robustnost ani správnost.
Čtyři principy užitečných vysvětlení
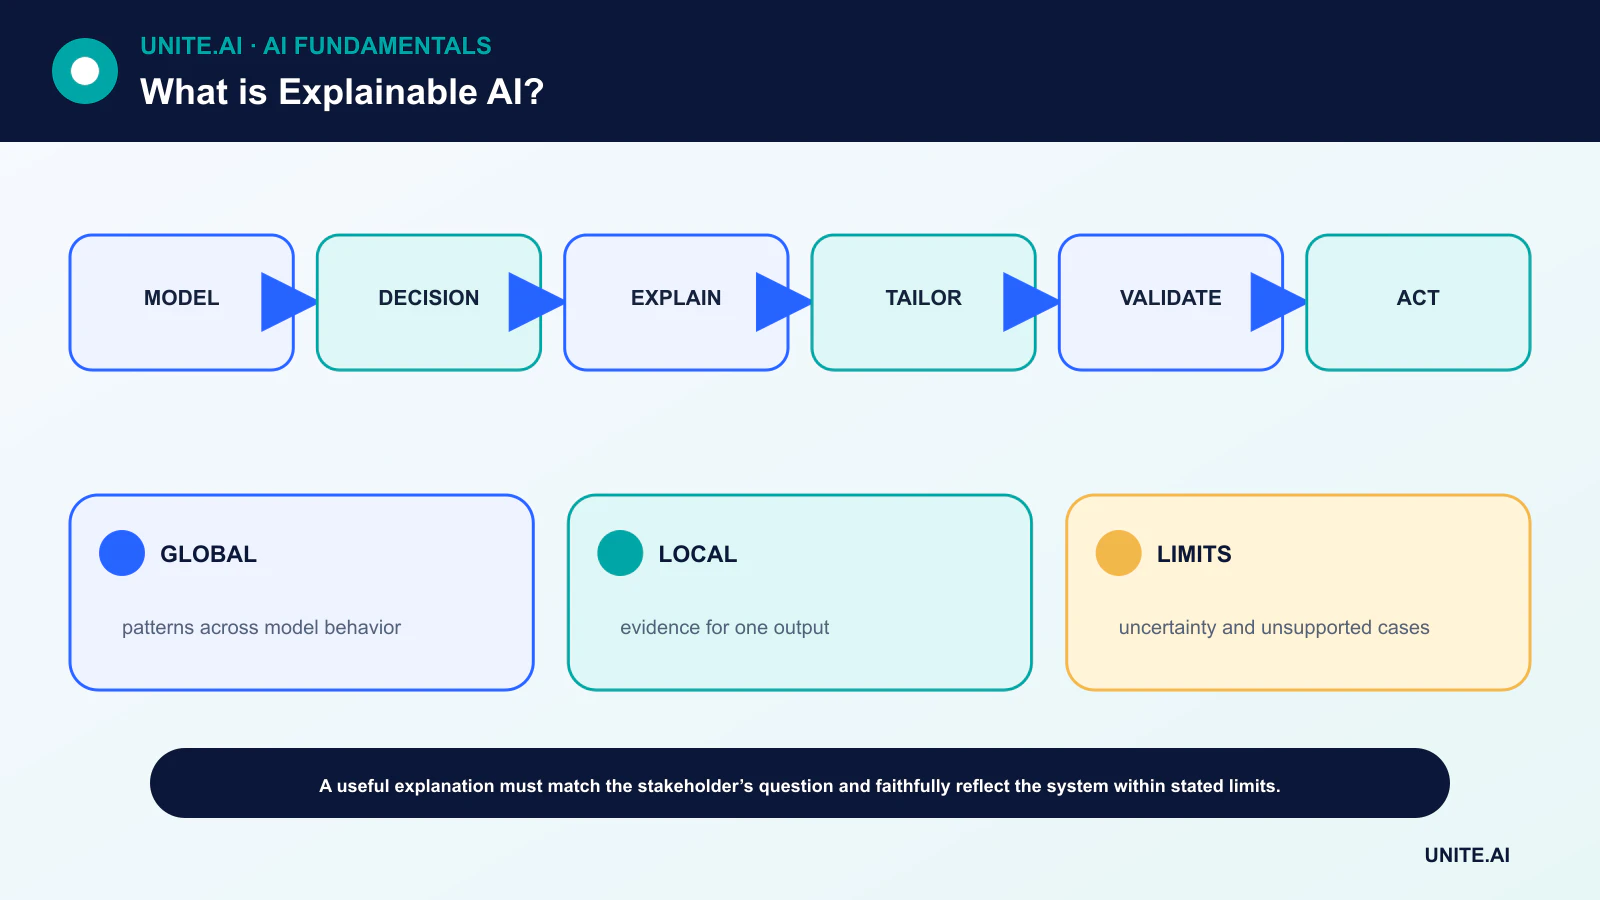
NIST navrhuje, aby systém poskytoval vysvětlení, učinil jej smysluplným pro zamýšleného uživatele, zajistil, že přesně odráží proces systému, a komunikoval jeho limity znalostí. Tyto principy oddělují existenci vysvětlení od jeho kvality.
Význam je specifický pro publikum. Stručný kód důvodu může pomoci žadateli, zatímco vývojář modelu může potřebovat distribuce, chování znaků a shluky selhání. Oba by měli být spojeni se stejným dokumentovaným systémem a kontextem rozhodnutí.
Vnitřní a post-hoc metody
Řídký lineární model nebo omezený rozhodovací strom může být přímo interpretovatelný v rámci svého platného rozsahu. Komplexní model může místo toho využívat post-hoc přiřazení znaků, lokální náhradní model, příklady, mapy významnosti nebo kontrafakty.
Vnitřní jednoduchost není automaticky pravdivá, pokud jsou znaky špatně definovány nebo je pipeline skrytá. Post-hoc složitost není automaticky zavádějící. Metodu je třeba otestovat vůči otázce, na kterou má odpovídat.
Přiřazení znaků a korelované vstupy
Metody přiřazení přidělují části výstupu vstupním znakům na základě explicitních předpokladů. LIME vytvoří jednoduchý lokální náhradní model kolem predikce; metody související se SHAP spojují aditivní přiřazení s koncepty Shapleyových hodnot.
Korelované znaky mohou sdílet nebo vyměňovat přiřazení a vysoké přiřazení není kauzální efekt. Změna znaku izolovaně může vytvořit nemožnou osobu, obrázek nebo transakci. Vysvětlení by měla uvádět své výchozí hodnoty, vzorkování a předpoklady o závislostech.
Kontrafakty, příklady a globální chování
Kontrafakt se ptá, jaká proveditelná změna by změnila výsledek. Omezení jsou zásadní: akční vysvětlení by nemělo doporučovat neměnné, nelegální nebo nerealistické změny. Metody založené na příkladech ukazují prototypy nebo vlivné tréninkové případy, ale mohou odhalit soukromá data.
Globální analýza zkoumá výkon, částečnou závislost, monotónnost, interakce a chování podskupin. U souborů, jako je gradient boosting, kombinujte souhrny s lokálními důkazy a přímými testy očekávaných omezení.
Ověřte vysvětlení a systém
Otestujte věrnost, stabilitu při malých perturbacích, konzistenci napříč ekvivalentními vstupy, pochopení uživatelem a zda vysvětlení podporuje vhodné rozhodnutí. Adversariální testy by měly ověřit, zda přesvědčivé vysvětlení může doprovázet špatný nebo manipulovaný výstup.
XAI patří do širšího hodnocení: kvalita na oddělených datech, kalibrace, spravedlnost, soukromí, bezpečnost, monitorování a mechanismy odvolání. Vysvětlení může podpořit odpovědnost, ale nemůže nahradit odpovědné řízení.
Cíle vysvětlení a rodiny metod
Vysvětlitelná AI by měla začít otázkou a publikem: proč nastalo konkrétní rozhodnutí, jak se model obecně chová, jaké důkazy ho ovlivnily, co by změnilo výsledek, nebo zda byla dodržena politika. Lokální vysvětlení se zabývá jednou predikcí; globální vysvětlení shrnuje širší chování. Vnitřně interpretovatelné modely odhalují koeficienty, pravidla nebo struktury, zatímco post-hoc metody aproximují komplexní modely. Vysvětlení chování modelu není automaticky kauzální vysvětlení světa ani odůvodnění, že rozhodnutí je spravedlivé.
Metody přiřazení znaků zahrnují gradienty, integrované gradienty, hodnoty ve stylu SHAP, permutaci a lokální náhradní modely. Vysvětlení založená na příkladech získávají vlivné nebo podobné případy; kontrafakty navrhují změny spojené s jiným výstupem; metodiky konceptů spojují vnitřní reprezentace s lidskými kategoriemi. Každá má předpoklady o výchozích hodnotách, nezávislosti znaků, lokální linearitě nebo přístupu k modelu. Korelované proměnné, interakce a předzpracování mohou způsobit, že přiřazení jsou nestabilní nebo zavádějící. Porovnávejte metody a rušte vstupy, abyste otestovali, zda vysvětlení předpovídá chování.
Hodnocení a lidské faktory
Posuzujte věrnost – zda vysvětlení odpovídá modelu – odděleně od plausibility pro člověka. Testujte stabilitu, citlivost, úplnost, řídkost a užitečnost pro definovaný úkol, jako je ladění nebo odvolání. Lidské studie potřebují reprezentativní účastníky a měly by hodnotit kvalitu rozhodnutí, detekci chyb, spolehlivost a čas, nikoli jen to, zda uživatelé považují graf za přehledný. Přesvědčivé vysvětlení může zvýšit důvěru ve špatný model, proto rozhraní musí ukazovat nejistotu, alternativy a omezení.
Kontrafakty by měly být proveditelné, akční a neměly by doporučovat změnu chráněných nebo neměnných vlastností. Vysvětlení mohou uniknout modelové nebo osobní informace a pomoci útočníkům reverzně analyzovat rozhodnutí. Používejte řízení přístupu a minimalizaci výstupu. Pro regulované nebo vysoce dopadové použití zachovejte původ dat, verzi modelu, práh a skutečnou logiku rozhodnutí; obecná grafika důležitosti znaků nemůže nahradit právně významný důvod nebo lidskou revizi.
Odpovědné používání vysvětlení
Vyberte nejjednodušší model, který splňuje požadavky na výkon a provoz, ale neobětujte platnost kvůli povrchní interpretovatelnosti. Kombinujte vysvětlení s testováním podskupin, kontrolou robustnosti, kauzální analýzou tam, kde je relevantní, a sledováním výsledků. Dokumentujte zamýšlené publikum a neplatné závěry. Pokud se vysvětlení změní po neškodné perturbaci, prověřte to před nasazením. Vysvětlitelnost je důkaz o systému pomocí metody; je cenná pro ladění, dohled a komunikaci, ale necertifikuje pravdu, spravedlnost, bezpečnost ani pochopení.
Praktický příklad: vysvětlení modelu úvěrového rizika
Poskytovatel úvěru nejprve určí publikum a požadovaný důvod: žadatelé potřebují přesné faktory rozhodnutí a možnost opravy, zatímco vývojáři potřebují diagnostiku. Kalibrovaný interpretovatelný základ se porovnává s boostovaným modelem. Lokální přiřazení, kontrafakty a globální analýza chyb jsou testovány na věrnost, stabilitu, chování korelovaných znaků a užitečnost. Vysvětlení nesmí doporučovat změnu věku, postižení nebo jiné neměnné vlastnosti a nejsou prezentována jako kauzální efekty.
Záznam produkčního rozhodnutí uchovává zdrojová data, transformaci znaků, model, práh, politiku a lidskou akci. Žadatelé mohou napadnout nesprávná data a získat smysluplné přezkoumání. Monitorování kontroluje stabilitu výsledků a vysvětlení napříč skupinami a aktualizacemi modelu. Pokud se smysluplné vysvětlení změní při neškodné perturbaci znaku nebo opomene rozhodující pravidlo politiky, nasazení se zastaví. Vysvětlitelnost doplňuje validaci a procesní práva; neomlouvá neplatný cíl, diskriminační výsledky ani nedostatek odpovědné lidské autority.
Důkazy o implementaci a provozní připravenost
Produkční rozhodnutí vyžaduje více než úspěšnou demonstraci. Definujte zamýšlené uživatele, provozní prostředí, vstupy, výstupy, závislosti, vlastníka a důsledek každého důležitého selhání. Zaveďte reprodukovatelný základ a verziovanou evaluační sadu před laděním. Testujte běžné případy, hraniční podmínky, poškozené nebo chybějící vstupy, posun distribuce, výpadek závislosti, zneužití a skupiny či prostředí, která jsou nejvíce opomíjena. Měřte kvalitu úkolu spolu s kalibrací nebo nejistotou, latencí, propustností, náklady na zdroje, přístupností, soukromím a bezpečností. Zaznamenávejte každou transformaci a práh, aby nezávislý recenzent mohl výsledek reprodukovat a rozlišit důkazy od atraktivního prototypu.
Před spuštěním přiřaďte pravomoc pro vydání, výjimky, změny, návrat a ukončení. Použijte postupné nasazení, zachovejte bezpečnou zálohu a ověřte monitorování pomocí úmyslně vložených selhání. Provozní telemetrie by měla odhalovat kvalitu vstupů, chování výstupů, verzi modelu nebo pravidla, stav závislostí, lidské zásahy a potvrzené výsledky, aniž by sbírala zbytečná citlivá data. Definujte prahové hodnoty upozornění a odpovědného, poté po nasazení přezkoumávejte reálné důkazy místo předpokladu, že offline výkon přetrvá. Přehodnocujte vždy, když se změní zdroje dat, uživatelé, modely, dodavatelé, politiky, hardware nebo cíle. Udržovaný systém také potřebuje dokumentované postupy obnovy, učení z incidentů, mazání a uchovávání a jasný bod, kdy má být deaktivován nebo nahrazen.
Často kladené otázky
Jsou mapy pozornosti vysvětlení?
Mohou sloužit jako diagnostické signály, ale samotné váhy pozornosti nezaručují věrné zobrazení důvodů výstupu modelu.
Vyžaduje vysvětlitelná AI jednoduchý model?
Ne vždy. Komplexní modely lze analyzovat pomocí post-hoc metod, ale tato vysvětlení vyžadují nezávislé ověření a jasně stanovená omezení.
Primární reference












