
Základy AI
Co je gradientní sestup?

 Přidejte Unite.AI mezi své preferované zdroje na Google
Gradient descent je optimalizační metoda, která upravuje parametry modelu tak, aby snížila cílovou funkci. V tréninku neuronových sítí je tento cíl obvykle ztráta vypočítaná na příkladech. Gradient ukazuje směr nejstrmějšího lokálního nárůstu, takže gradientní sestup udělá krok v opačném směru.
Gradient popisuje lokální citlivost; jeho velikost není přímým měřítkem toho, jak rychle se model „učí“. Skutečný pokrok také závisí na učební rychlosti, zakřivení, šumu, parametrizaci, stavu optimalizátoru a datech.
Klíčové poznatky
- Backpropagation vypočítává gradienty, zatímco gradientní sestup je používá k aktualizaci parametrů.
- Optimalizace v mini‑batchích je standardní praktický přístup pro hluboké učení.
- Učební rychlost řídí měřítko aktualizace a může se řídit plánem místo toho, aby se po každém kroku zmenšovala.
- Momentum, AdamW, ořezávání a normalizace řeší různé optimalizační problémy.
Základní pravidlo aktualizace
Pro vektor parametrů θ, učební rychlost η a ztrátu L:
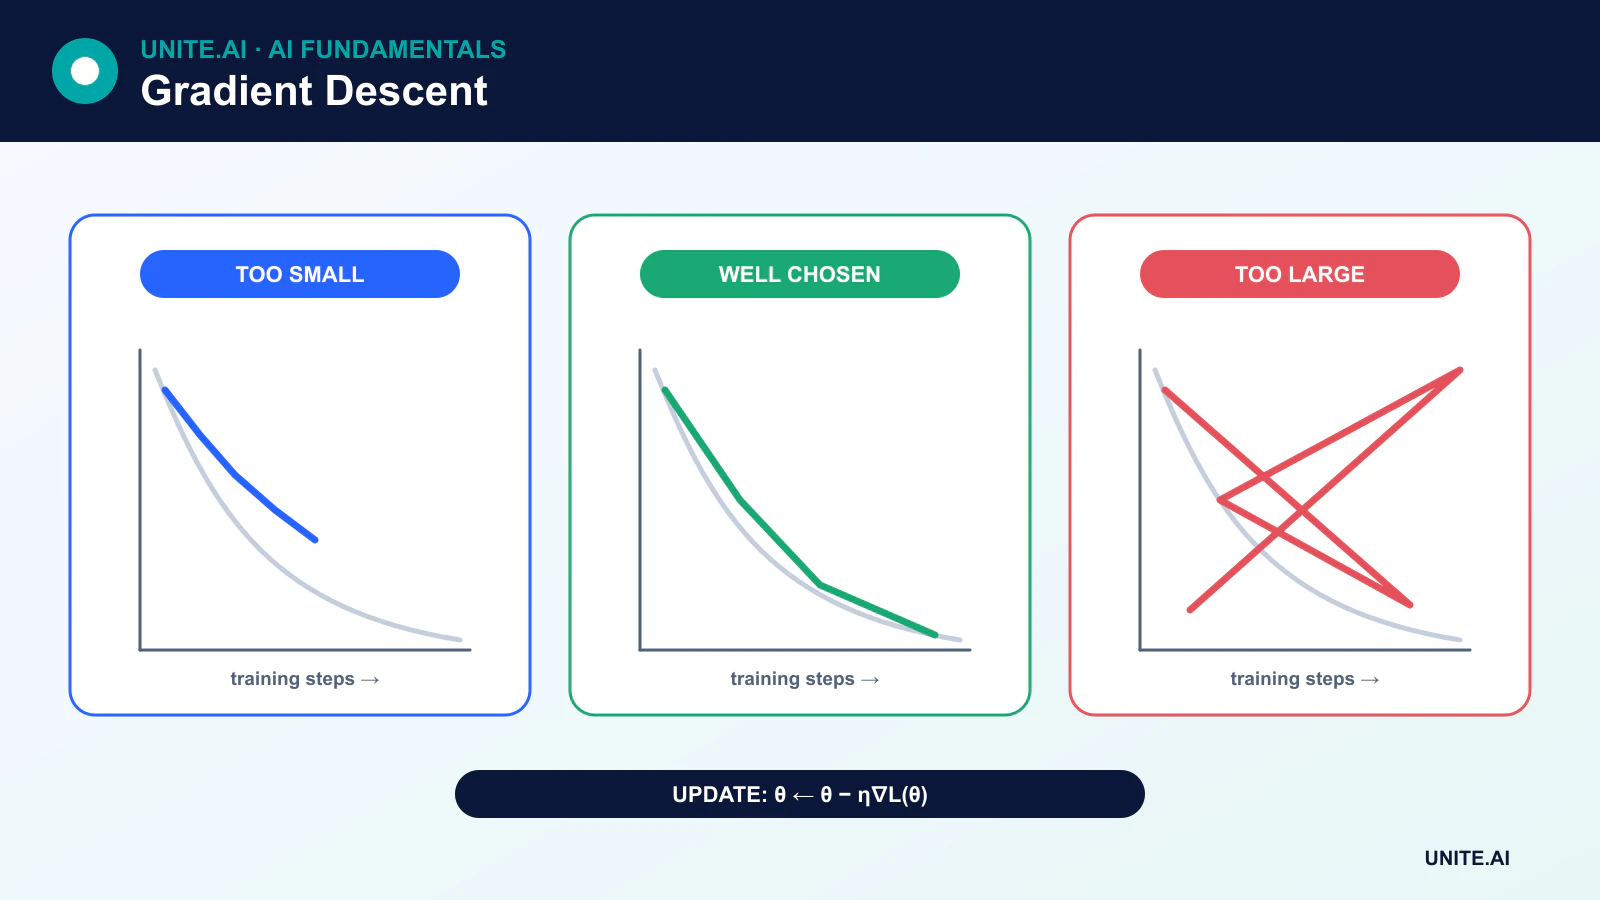
θ ← θ - η∇L(θ)
Gradient ∇L(θ) obsahuje jeden parciální derivát pro každý parametr. Odečtení ho posune lokálně dolů. Stacionární bod má gradient nula, ale může to být minimum, maximum, sedlový bod nebo rovná oblast. Povrchy ztráty v hlubokém učení jsou nekonvexní, takže trénink nezaručuje nalezení jedinečného globálního minima nebo nulové ztráty.
Metody batch, stochastic a mini‑batch
Dávkový gradientní sestup
Dávkový gradientní sestup vypočítává gradient pomocí celého tréninkového souboru při každé aktualizaci. Odhad je stabilní, ale může být nákladný na čas i paměť a jedna aktualizace může podvyužívat moderní akcelerátory.
Stochastický gradientní sestup
Přísný stochastický gradientní sestup používá pro každou aktualizaci jeden náhodně vybraný příklad. Jeho gradienty jsou šumivé, což může pomoci při prozkoumávání povrchu ztráty, ale operace s jedním příkladem mohou být neefektivní na paralelním hardwaru.
Mini‑batch gradientní sestup
Trénink v mini‑batchích odhaduje gradient z podmnožiny příkladů. Vyvažuje statistický šum s efektivními maticovými operacemi a je obvyklým přístupem v deep learning. Velikost batchu ovlivňuje paměť, propustnost, šum gradientu, normalizaci a někdy generalizaci.
Volba učební rychlosti
Příliš velká rychlost může přeskakovat užitečné oblasti nebo způsobit divergence. Příliš malá rychlost může učinit trénink neprakticky pomalým nebo uvíznout v rovinatých oblastech. Nejvhodnější měřítko závisí na optimalizátoru, velikosti batchu, modelu, inicializaci a cíli.
Plány mohou postupně zahřívat, snižovat se v milnících, sledovat kosinovou křivku nebo reagovat na pokrok ve validaci. Rychlost nemusí po každé aktualizaci monotónně klesat. Teplé restartování a cyklické plány úmyslně zvyšují rychlost během částí tréninku.
Momentum
Momentum udržuje exponenciální klouzavý průměr minulých gradientů. Může urychlit postup podél konzistentních směrů a snížit oscilace v prudkých, úzkých směrech. Momentum ve stylu Nesterova vyhodnocuje nebo aproximuje gradient po pohledu dopředu podél směru momenta.
Adaptivní optimalizátory
RMSProp škáluje aktualizace pomocí klouzavého průměru čtverců gradientů. Adam kombinuje momenty podobné momentu první řádu se škálováním druhého momentu. AdamW odděluje úbytek váhy od adaptivní aktualizace gradientu a je široce používán pro transformátory.
Adaptivní optimalizátory často usnadňují počáteční trénink, ale nejsou automaticky nadřazeny pro každý model či konečný cíl generalizace. Porovnání optimalizátorů vyžaduje sladěné plány a pečlivé ladění.
Ořezávání a akumulace gradientu
Ořezávání gradientu omezuje normu nebo hodnoty gradientu, aby snížilo dopad výbuchových gradientů, zejména v rekurentním nebo nestabilním tréninku. Akumulace gradientu přidává gradienty napříč několika menšími batchi před aktualizací, čímž aproximuje větší efektivní batch, když je paměť omezená.
Sledování optimalizace
Sledujte tréninkovou a validační ztrátu, metriky úlohy, učební rychlost, normy gradientu, normy parametrů a numerické chyby. Klesající tréninková ztráta při zhoršujícím se validačním výkonu naznačuje přeučení, ne úspěch optimalizace, který by měl být automaticky pokračován.
Optimalizace minimalizuje daný cíl. Nízká ztráta neprokazuje, že data, metrika nebo chování ve skutečném světě jsou vhodné. Únik informací, špatné štítky a nesoulad cíle mohou vytvořit dobře optimalizovaný, ale škodlivý model.
Geometrie optimalizace a pravidla aktualizace
Gradientní sestup aktualizuje parametry opačným směrem k gradientu ztráty. Full‑batch sestup používá při každém kroku všechny tréninkové příklady; stochastický používá jeden; metody mini‑batch odhadují gradient z podmnožiny a dominují v hlubokém učení. Učební rychlost určuje měřítko kroku. Příliš malá plýtvá výpočtem nebo uvízne; příliš velká osciluje nebo diverguje. Momentum akumuluje pohybující se směr, zatímco adaptivní metody jako Adam škálují souřadnice pomocí momentů gradientu. Jejich různé implicitní zkreslení může vytvořit modely se stejnou tréninkovou ztrátou, ale odlišnou generalizací.
Povrchy ztráty v neuronových sítích obsahují rovné i ostré oblasti, sedla, symetrie a špatně podmíněné směry. Škálování rysů, normalizace, inicializace, reziduální spojení a předkondicionování mění geometrii, kterou optimalizátor vidí. Plány mohou zahřívat, snižovat, cyklovat nebo reagovat na plateau. Úbytek váhy je odlišný od pouhého přidání L2 penalizace u některých adaptivních optimalizátorů. Velikost batchu ovlivňuje šum, paměť, paralelismus a režim učební rychlosti, takže porovnání optimalizátorů vyžaduje sladěné tréninkové rozpočty a pečlivé ladění.
Diagnostika, reprodukovatelnost a ukončování
Sledujte tréninkovou a validační ztrátu, metriky úlohy, normy gradientu a parametrů, učební rychlost, propustnost a numerická varování. Divergence může vzniknout z poškozených batchů, neplatných štítků, nestabilní smíšené přesnosti nebo nesprávného redukování ztráty. Plateau může naznačovat nedostatečnou kapacitu, nasycené aktivace, špatné rysy, nadměrnou regularizaci nebo problém s plánem. Přeučení vyžaduje data, augmentaci, regularizaci nebo předčasné zastavení — ne tvrzení, že optimalizátor selhal. Prohlédněte si reprezentativní chyby a porovnejte jednoduchou referenci před zvýšením složitosti tréninku.
Reprodukovatelnost vyžaduje semena, pořadí dat, kód, konfiguraci, verze hardwaru a knihoven, ačkoliv některá jádra akcelerátorů zůstávají nedeterministická. Ukládejte kontrolní body s stavem optimalizátoru a plánovače, aby mohl trénink konzistentně pokračovat. Vyberte kontrolní bod na základě validačních kritérií stanovených předem a vyhraďte nedotčený testovací soubor. V distribuovaném tréninku ověřte efektivní velikost batchu, průměrování gradientu a zacházení s neúspěšnými pracovníky. Optimalizace minimalizuje zvolený cíl na dostupných datech; nezaručuje kalibrované pravděpodobnosti, kauzální uvažování, spravedlnost, bezpečnost ani užitečnost ve skutečném světě.
Praktický příklad: ladění optimalizátoru pro jazykový model
Tým stanoví tokenizer, pořadí dat, model, efektivní batch a rozpočet tokenů pro trénink, poté porovná SGD s momentem a AdamW napříč obhajitelnými plány učební rychlosti. Zaznamenávají se zahřívání, útlum, úbytek váhy, ořezávání a přesnost. Každý kandidát běží s několika semeny a validace používá vyhrazený časový úsek plus úlohové hodnocení. Propustnost a energie jsou hlášeny spolu se ztrátou, aby mírně lepší optimalizátor nebyl vybrán za nepřiměřenou cenu.
Diagnostika odhalí, zda nestabilita pochází z jedné datové části, nadměrné velikosti kroku, podtečení nebo architektury modelu. Kontrolní body zachovávají stav optimalizátoru a plánovače a jsou v testu obnoveny. Konečná volba se zakládá na kvalitě a robustnosti validace, ne na nejnižší tréninkové ztrátě. Uzavřený testovací soubor se spustí jednou po výběru. Produkční inferenční proces je samostatně kalibrován a sledován, protože úspěch optimalizátoru během předtréninku nezaručuje bezpečné nebo pravdivé chování.
Důkazy o implementaci a provozní připravenost
Rozhodnutí o nasazení vyžaduje více než úspěšnou demonstraci. Definujte zamýšlené uživatele, provozní prostředí, vstupy, výstupy, závislosti, vlastníka a důsledky každého důležitého selhání. Zaveďte reprodukovatelnou základní linii a verzovanou evaluační sadu před laděním. Testujte běžné případy, okrajové podmínky, poškozené nebo chybějící vstupy, posun distribuce, výpadek závislosti, zneužití a skupiny či prostředí, která jsou pravděpodobně nedostatečně obsloužena. Měřte kvalitu úlohy spolu s kalibrací nebo nejistotou, latencí, propustností, náklady na zdroje, přístupností, soukromím a bezpečností. Zaznamenejte každou transformaci a práh, aby nezávislý recenzent mohl výsledek reprodukovat a odlišit důkazy od atraktivního prototypu.
Před spuštěním přiřaďte pravomoc pro vydání, výjimky, změny, rollback a ukončení. Použijte postupné nasazení, zachovejte bezpečnou náhradní možnost a ověřte monitorování s úmyslně vloženými selháními. Provozní telemetrie by měla odhalovat kvalitu vstupů, chování výstupů, verzi modelu nebo pravidla, stav závislostí, lidské zásahy a potvrzené výsledky bez sběru zbytečných citlivých dat. Definujte prahy upozornění a odpovědného za reakci, poté po nasazení přezkoumejte důkazy z reálného světa místo předpokladu, že offline výkon přetrvá. Přehodnoťte kdykoliv se změní zdroje dat, uživatelé, modely, dodavatelé, zásady, hardware nebo cíle. Udržovaný systém také potřebuje zdokumentované postupy obnovy, učení se z incidentů, mazání a uchovávání a jasný bod, kdy má být deaktivován nebo nahrazen.
Často kladené otázky
Dosahuje gradientní sestup vždy globálního minima?
Ne. U konvexních cílů poskytují vhodné podmínky silné záruky. Cíle hlubokých sítí jsou nekonvexní a praktické optimalizátory obvykle hledají užitečné řešení místo toho, aby dokazovaly, že našly jedinečné globální minimum.
Proč může nulový gradient být zavádějící?
Nulový nebo velmi malý gradient může naznačovat minimum, maximum, sedlový bod, saturaci nebo rovné plateau. Diagnostika tréninku musí zohlednit historii ztráty, zakřivení, měřítko parametrů a výkon validace.
Primární reference












