AI 基础
什么是来自人类反馈的强化学习(RLHF)?

 将 Unite.AI 添加到您在 Google 上的首选来源
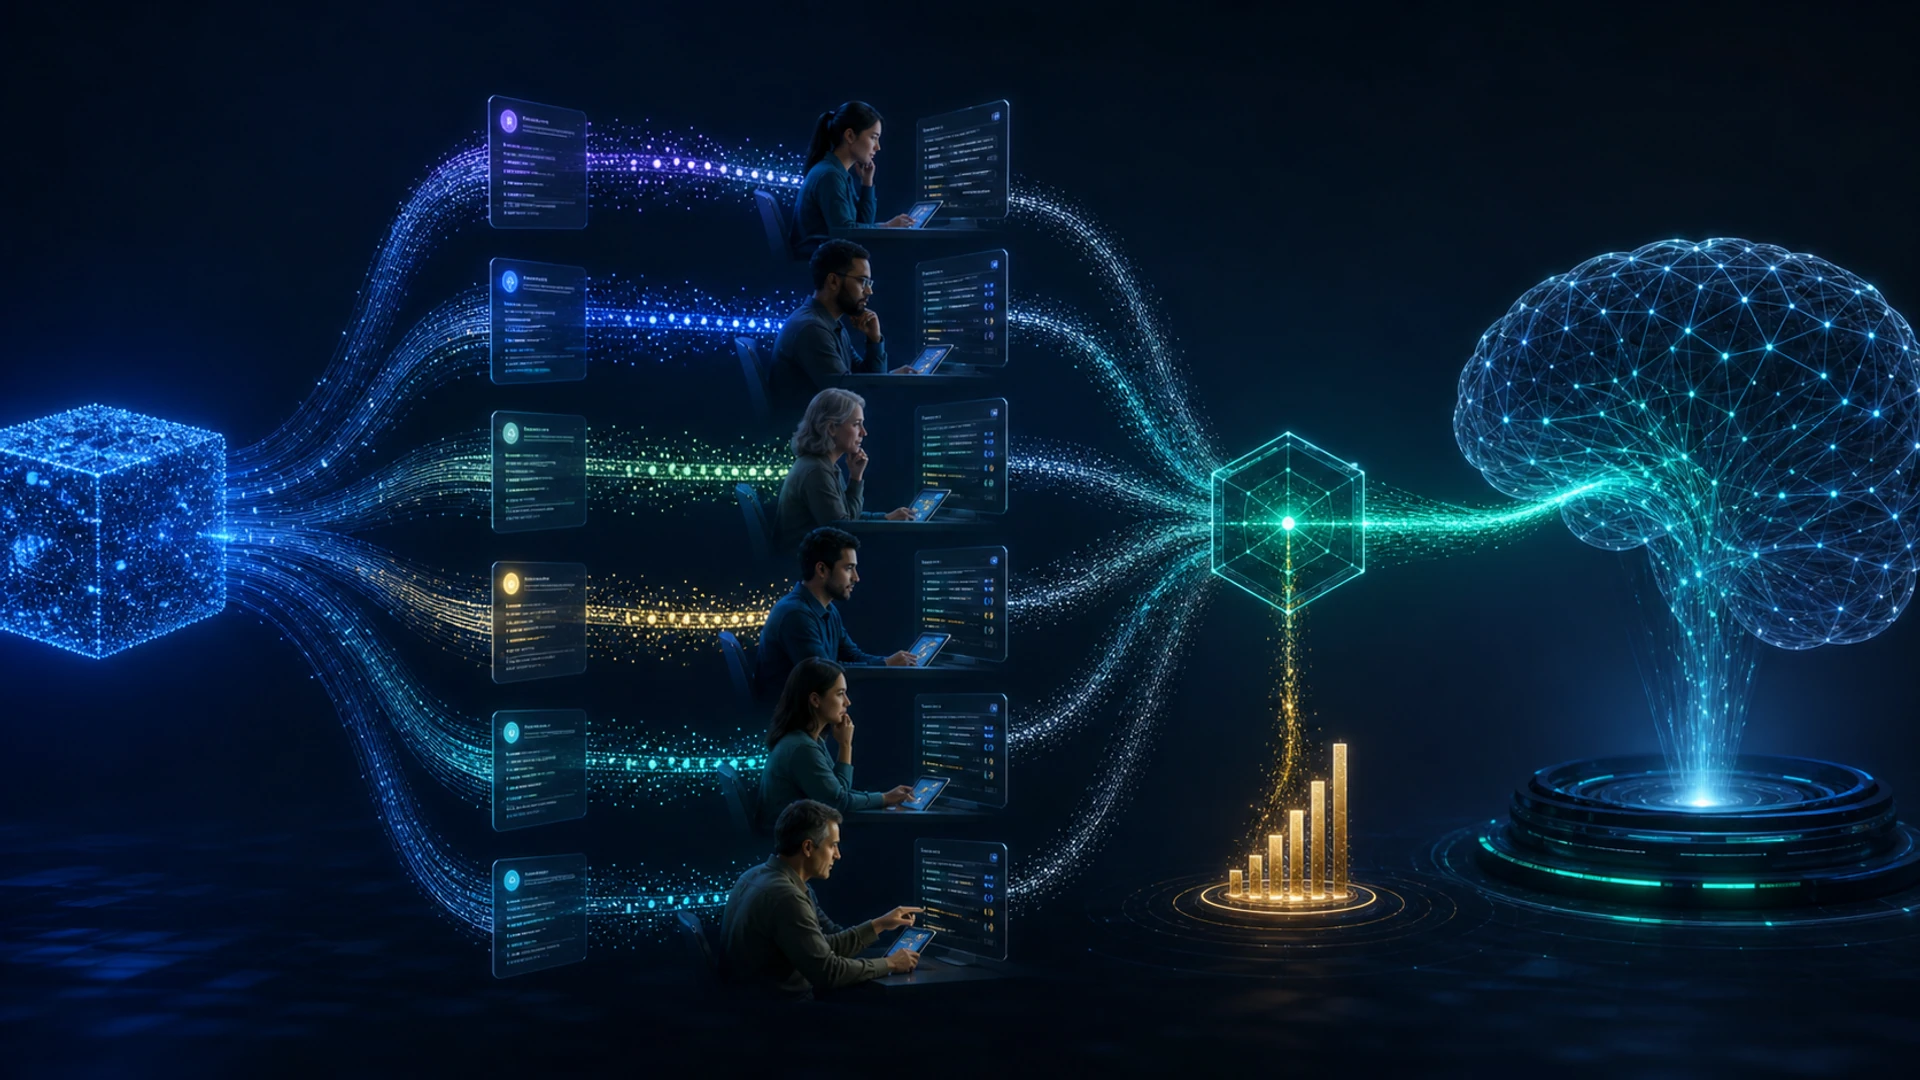
强化学习来自人类反馈(RLHF)是一类方法,利用人类判断在所需行为难以用简单自动奖励来指定时帮助优化模型。对于语言模型,人们通常比较候选回复,而学习到的偏好模型将这些比较转化为训练信号。
RLHF 可以使预训练模型更有帮助或更符合书面政策,但它并不能证明模型的真实性或与每位用户的对齐。结果取决于谁提供反馈、提示如何采样、奖励模型能表示什么以及优化的约束方式。
关键要点
- RLHF 通常在预训练和监督指令微调之后进行。
- 成对偏好用于训练奖励或偏好模型;随后策略优化倾向于得分更高的输出。
- 奖励破解、标注者分歧、分布漂移和过度优化仍是重要风险。
- 直接评估最终策略的任务质量、安全性、校准以及子群体影响。
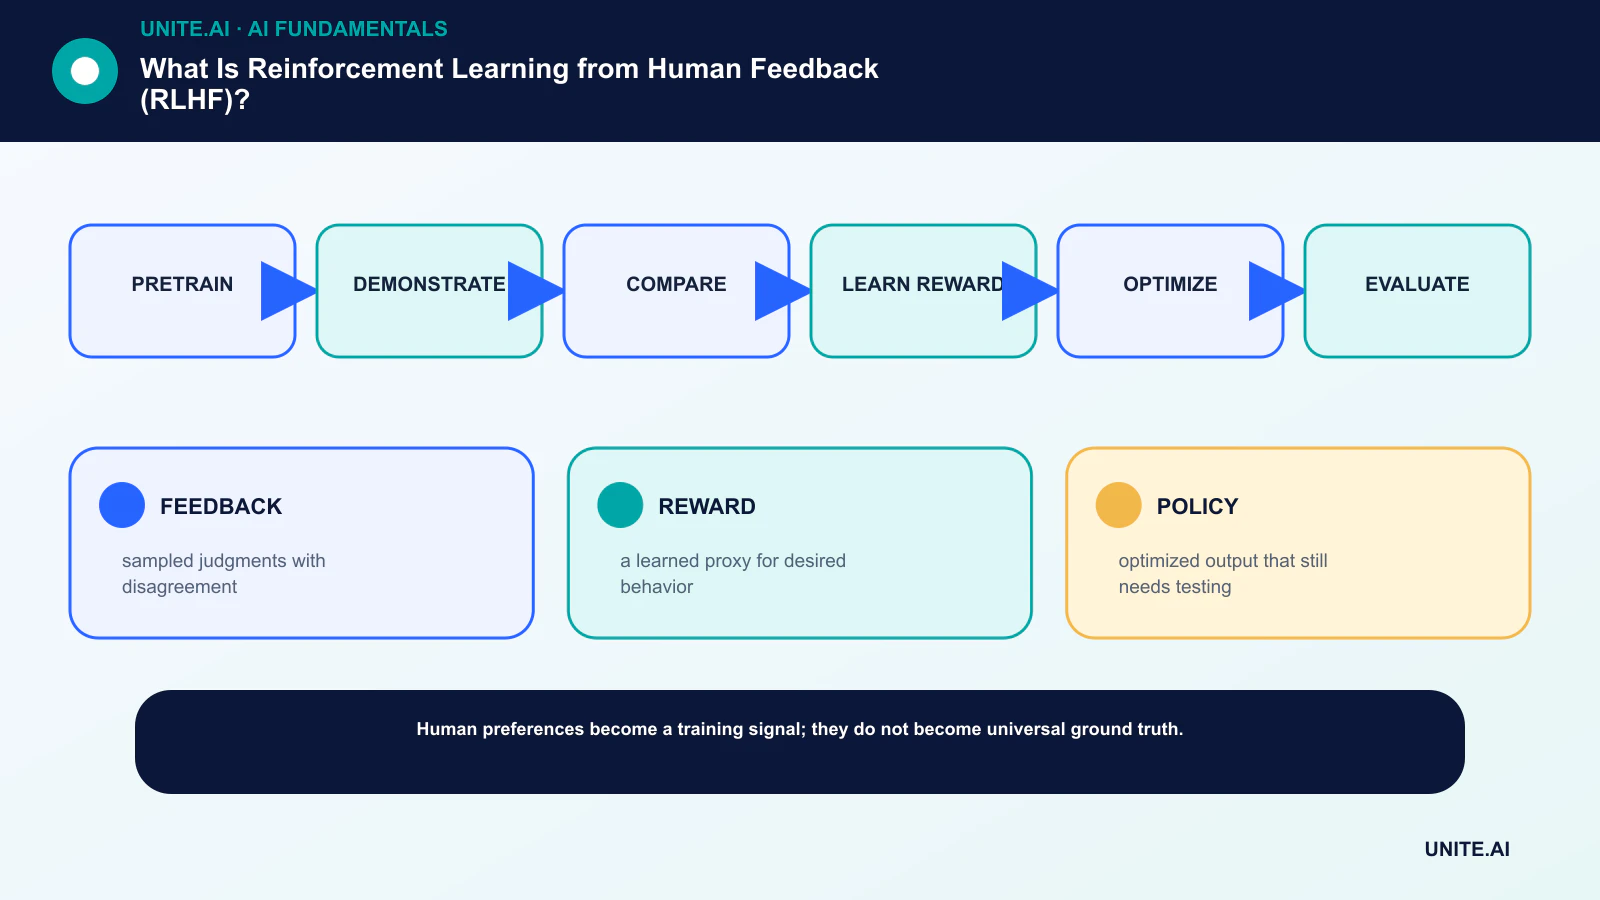
常见的 RLHF 流程
语言模型首先通过预训练学习广泛的统计结构。随后,监督微调使用期望回复的示例。为了收集偏好,标注者对同一提示的输出进行排序或选择。
奖励模型学习预测这些比较。诸如 PPO 的强化学习算法可以在学习到的奖励上优化语言模型,同时惩罚项阻止模型偏离参考策略过远。
反馈是度量,而非真实基准
标注者可能会出现分歧,因为指令模糊、专业水平不同或价值观真正冲突。位置、冗长程度、置信度和风格都可能影响偏好。高质量的程序会培训评估者、测量一致性、审计示例并保留不确定性。
采样同样重要。如果偏好集合排除了困难语言、领域或有害内容,奖励模型就无法可靠地对其进行监督。数据科学的纪律性与优化器同等重要。
失效模式
策略可能利用学习到的奖励的弱点,产生得分高但未满足根本意图的输出。过度优化可能降低多样性、放大偏好的风格,或使模型自信地迎合。
奖励模型本身在其训练分布之外也可能失效。团队应测试对抗性提示、事实任务、拒绝边界、校准以及不同优化强度下的行为,而不是仅依赖单一的整体偏好胜率。
替代方案与补充
直接偏好优化(Direct Preference Optimization)从偏好对中学习,无需通过在线强化学习循环拟合单独的策略。拒绝采样、监督偏好微调、基于规则的反馈以及过程监督提供了其他权衡。
没有任何方法可以消除对提示、检索、工具和应用层控制的需求。后训练阶段塑造行为;部署的系统仍然需要有依据的证据、权限、监控以及人工升级。
偏好模型的训练方式
对于提示 x 以及两个响应 y₁ 和 y₂,偏好模型会分配标量分数,并通过训练使得被偏好的响应获得更高分。常用的损失基于一个分数超过另一个分数的概率。这将大量成对判断转化为可以为新生成输出打分的函数。
模型学习任何能够预测收集到的选择的信号。如果评估者偏好自信的文字、较长的答案、特定的文化规范或熟悉的观点,这些关联可能成为奖励特征。平衡的指令、反例、专家审查以及对表面偏好的审计可以降低但不能根除该问题。
偏好数据可以包括平局、排名、批评、标量标签或示例。对配对的选择很重要: 明显不同答案之间的比较对细微质量边界的学习帮助较少,而仅使用困难配对可能导致训练不稳定。主动采样可以针对信息丰富的分歧,但可能改变数据分布。
策略优化与正则化
基于 PPO 的 RLHF 从当前策略采样响应,用奖励模型对其打分,并更新策略以提升期望奖励。KL(Kullback–Leibler)惩罚或相关约束使策略保持在监督参考附近,限制破坏性漂移并阻止对狭窄奖励模型弱点的利用。
优化强度是产品选择。过少会使期望行为保持不变;过多可能导致奖励破解、重复措辞、阿谀奉承或多样性下降。应在整个训练过程中绘制质量和安全指标相对于奖励和散度的曲线,而不是仅凭奖励选择检查点。
直接偏好方法从偏好对和参考模型中导出目标函数,无需显式的在线 RL 循环。它们可以简化训练,但仍继承偏好质量、覆盖范围以及参考策略的假设。宪法式或 AI 生成的反馈改变了标签提供者;但它并未消除通过人为验证价值和失败的需求。
评估与数据治理
使用盲测比较、任务特定测试、对抗性提示、真实性检查、拒绝的精确率和召回率以及子群体审查。尽可能将评估者与训练数据分离。相对于旧模型的胜率可能掩盖绝对失误,尤其当两个候选模型都表现不佳时。
记录标注者的招募、报酬、专业水平、地域、语言、指令、接触有害内容的情况、分歧、仲裁以及质量控制。反馈工作可能带来心理风险,负责任的数据运营应包括对工作者的支持以及拒绝令人不安任务的权利。
部署后,监控偏好漂移和过度概括。为日常帮助调校的策略在医学或法律场景中可能表现不佳。保持领域边界、检索、权限和升级机制在 RLHF 假设之外,仅在新证据证明需要时才重新训练。
具体的 RLHF 训练与评估流水线
典型项目从预训练语言模型和用于监督微调的指令数据集开始。随后标注者在书面评分标准下比较候选回复,评分标准涵盖正确性、相关性、风格、安全性和不确定性。成对偏好用于训练奖励模型或直接优化策略。采样必须包括常规任务、困难边缘案例、对抗性提示、多语言以及标注者合法分歧的领域。
奖励模型在保留集比较上的准确性是必要但不足的。优化后的策略可能利用学习奖励的错误,变得过于冗长、拒绝无害请求或失去能力。需在训练期间跟踪任务基准、人类偏好、校准、安全性、多样性以及相对于参考模型的散度。定期从不断变化的策略中收集新比较,以确保偏好数据覆盖模型实际产生的输出。
记录提供偏好的人员、他们的指令、报酬、分歧、质量控制以及文化或领域限制。对可能造成专业伤害的错误使用专家审查。对奖励模型和最终策略进行红队测试,维护行为回归测试,并分阶段部署。RLHF 根据测得的偏好塑造行为;它并不证明真实性,亦未消除偏见,或解决在每个情境中规定模型应做何事的更广泛问题。
实用实施清单
将概念转化为有界、可测试的工作流: 预训练 → 示范 → 比较 → 学习奖励 → 优化 → 评估。指定负责的所有者,记录数据及其依赖,建立简单基线,设定接受和停止标准,测试代表性失败,并在扩展范围前定义监控、回滚和审查。记录版本和假设,以便其他团队能够复现结果并了解变更内容。
在上线前,进行有文档记录的就绪审查,参与人员包括构建、运营、保障以及受系统影响的人员。测试常规案例、边界条件、依赖失效和误用;保留证据和未解决的风险。明确谁可以批准发布、修改阈值、覆盖输出或停止运行。随着真实世界数据的到来重新评估决定,因为技术上成功的试点并不保证在更大规模上的可靠表现。
- FEEDBACK: 带有分歧的抽样判断。
- REWARD: 对期望行为的学习代理。
- POLICY: 已优化的输出,但仍需测试。
常见问题
RLHF 与微调是同一回事吗?
RLHF 是一种使用偏好衍生奖励的后训练形式。监督微调直接在目标输出上进行训练;许多流水线同时使用两者。
RLHF 能让模型真实吗?
它可以提升通过反馈过程衡量的行为,但模型仍可能错误、具说服性或策略性地利用奖励。真实性需要直接评估和扎实的依据。
主要参考文献