AI 基础
贝叶斯定理是什么?

 将 Unite.AI 添加到您在 Google 上的首选来源
贝叶斯定理描述了在观察到证据后如何更新假设的概率。它将已知假设下证据的概率与已知证据下假设的概率联系起来。
这种区别是统计推理和机器学习的核心。当一种情况存在时,测试可能非常准确,但如果该情况很少见,即使出现阳性结果,指示该情况的概率仍然适中。
关键要点
- 后验概率将先验信念与观察到的证据的似然相结合。
- 证据项对可能的假设进行归一化。
- 基准率(先验概率)可以主导表面上看似强烈的证据。
- 朴素贝叶斯假设特征在给定类别的条件下相互独立,而不是在所有情况下都独立。
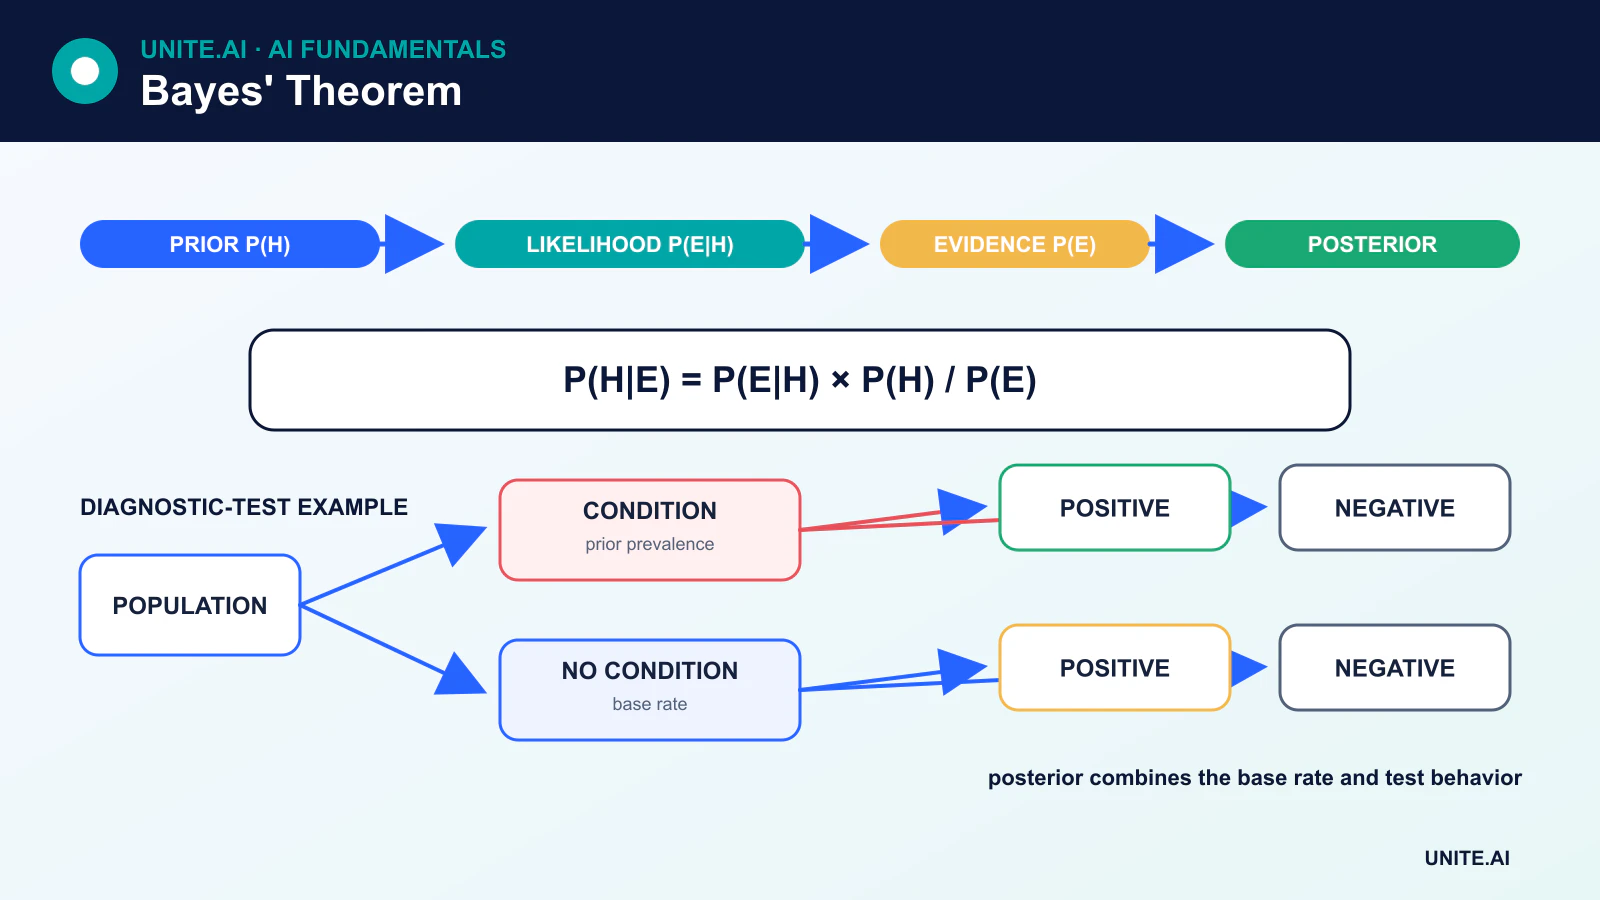
公式
P(A|B) = P(B|A)P(A) / P(B)
- P(A) 是假设 A 的先验概率。
- P(B|A) 是在 A 为真时观察到证据 B 的似然。
- P(B) 是证据的总体概率。
- P(A|B) 是在观察到 B 之后 A 的后验概率。
该定理来源于两个等价的联合概率表达式:P(A ∩ B) = P(B|A)P(A) 和 P(A ∩ B) = P(A|B)P(B)。
数值基准率示例
假设一种情况影响 1% 的人群。某测试的灵敏度为 90%,假阳性率为 5%。考虑 1,000 个人:
- 约有 10 人患有该情况;测试正确标记了 9 人。
- 约有 990 人未患病;5% 的假阳性率大约标记了 50 人。
- 因此大约有 59 个阳性结果,其中 9 个是真阳性。
阳性结果后该情况的概率约为 9 / 59 ≈ 15%,而不是 90%。测试的灵敏度回答的是 P(positive | condition);用户通常想要的是 P(condition | positive)。贝叶斯定理利用基准率将二者联系起来。
贝叶斯更新
随着新证据的到来,后验可以成为下一次更新的先验。完整的贝叶斯模型需指定可能的假设、先验分布、似然函数以及待推断的量。不确定性用后验分布而非单一点估计来表示。
先验应被记录并进行敏感性测试。弱信息先验可以对不合理的取值进行正则化,而选择不当的强先验可能会支配有限的数据。
朴素贝叶斯分类器
朴素贝叶斯使用贝叶斯定理和以下假设从特征 x₁ … xₙ 预测类别 y:
P(x₁, …, xₙ | y) = Π P(xᵢ | y)
在已知类别的条件下,特征被假设为条件独立。这在实际中常常不成立,但当得到的类别得分仍然有用时,分类器仍能表现良好。
常见变体
- Multinomial Naive Bayes 对计数类特征建模,常用于文档分类。
- Bernoulli Naive Bayes 对二元特征的存在性建模。
- Gaussian Naive Bayes 对每个连续特征使用类别条件的高斯分布建模。
- Categorical Naive Bayes 对离散类别建模。
平滑与数值稳定性
如果某特征值在训练中从未与某类别出现,未平滑的概率估计会变为零,从而消除整个乘积。加性或拉普拉斯平滑可以避免这种情况。实现时通常计算对数概率,使得对许多小值的乘法转化为对数值的相加,保持数值稳定。
概率、得分与校准
朴素贝叶斯的概率输出往往校准不足,因为相关特征会被重复计数。分类器可能在排序上表现良好,却高估了置信度。当概率用于决策时,应在留出数据上评估校准情况。
贝叶斯超越朴素贝叶斯
贝叶斯推断支持层次模型、A/B 测试、科学参数估计、预测、考虑不确定性的决策以及概率图模型。当后验无法闭式求解时,常使用马尔可夫链蒙特卡罗或变分推断等近似方法。
常见推理错误
- 混淆
P(A|B)与P(B|A)。 - 忽视罕见或常见的基准率。
- 将先验视为客观或未记录先验。
- 假设高似然自动意味着高后验。
- 将预测关联误解为因果关系。
条件概率、赔率与证据
贝叶斯定理将证据出现后假设的概率与其先验概率、在该假设下观察到证据的似然以及证据的总体概率联系起来。以赔率形式表示时,后验赔率等于先验赔率乘以似然比。这将测试前的信念与测试对假设的区分力度分开。当情况罕见时,即使测试看似高度准确,也会产生大量假阳性,因为基准率进入了后验。
似然是针对固定观测数据的假设函数,不应与假设的概率混淆。证据归一化对竞争假设求和或积分。条件独立假设可以简化计算,如朴素贝叶斯,但必须检查其后果。当证据共享原因或信息重复时,不能将多条证据视为独立相乘。因果方向也很重要:P(evidence|hypothesis) 通常不等于 P(hypothesis|evidence),这正是经典的逆概率错误。
建模选择、计算与决策使用
贝叶斯分析指定先验、似然和后验预测分布。先验可以编码已有知识、对小样本进行正则化,或保持弱信息;应通过敏感性分析加以论证和检验。共轭模型可得到解析更新,而马尔可夫链蒙特卡罗、变分推断和顺序方法则用于近似复杂后验。应诊断收敛性、有效样本量、近似误差以及先验预测的合理性,而不是在未进行计算检查的情况下直接报告后验数值。
后验概率提供信息,但本身并不能决定行动。决策需要考虑损失、收益、约束和可选方案。应使用校准、适当的评分规则以及对新数据的后验预测检查来评估概率模型。仅在符合建模过程收集的证据下进行更新;选择偏差和数据集漂移会使似然失效。传达可信区间和假设时不要把它们当作保证的频率范围。贝叶斯定理是精确的概率代数,而贝叶斯结论的质量取决于所使用的模型和提供的证据。
案例演示:解释诊断测试
某测试的灵敏度为 95%,特异度为 90%,但该情况仅影响 1% 的筛查人群。对 10,000 人而言,预计约有 95 例真阳性和 990 例假阳性,导致阳性预测值低于 9%。贝叶斯定理将基准率效应明确化。计算阐明了人口规模、测试阈值和不确定性,而不是把灵敏度宣传为阳性结果正确的概率。这一区别同样是严谨的数据科学的基础。
临床医生仅在对测试之间的依赖关系进行建模时才会用额外证据更新概率。决策阈值会综合考虑漏诊的危害、确认测试的风险、成本以及患者偏好。校准应在本地人群中检验,患病率变化则触发复审。后验支持讨论和后续步骤,但并不取代确认诊断。报告采用自然频数和敏感性分析,使患者和从业者能够看到结论在合理假设下的变化。
实施证据与运营准备
生产决策需要的不仅是成功的演示。必须明确预期用户、运行环境、输入、输出、依赖关系、负责人以及每个关键失效的后果。调优前应建立可复现的基线和带版本的评估集。测试普通案例、边界条件、格式错误或缺失的输入、分布漂移、依赖中断、误用以及最可能被忽视的群体或环境。测量任务质量时同时关注校准或不确定性、延迟、吞吐量、资源成本、可访问性、隐私和安全。记录每一次转换和阈值,以便独立审阅者能够复现结果并区分证据与吸引人的原型。
上线前,需分配发布、例外、变更、回滚和退役的授权。使用分阶段发布,保留安全回退,并通过有意注入的故障验证监控。运营遥测应揭示输入质量、输出行为、模型或规则版本、依赖健康状况、人为覆盖以及确认结果,而不收集不必要的敏感数据。设定警报阈值并指定响应负责人,然后在部署后审查真实世界的证据,而不是假设离线性能会持续。每当数据来源、用户、模型、供应商、政策、硬件或目标变化时都需重新评估。维护中的系统还需有文档化的恢复、事件学习、删除与保留流程,以及明确的停用或替换时点。
常见问题
似然与概率有什么区别?
在参数固定时,模型为可能的数据分配概率。观测数据固定时,同一表达式可以视为关于可能参数值的似然函数。数值公式可能相同,但解释不同。
朴素贝叶斯是完全的贝叶斯推断吗?
它在强条件独立模型下使用贝叶斯定理进行分类。更广义的贝叶斯推断会在未知量上放置分布,并通过后验分布进行推理。
主要参考文献
具有后验分布的 ns。主要参考文献 scikit-learn: 朴素贝叶斯 NIST/SEMATECH: 概率分布与条件概率。