
AI 基础
情感分析是什么?方法、用途与局限性

 将 Unite.AI 添加到您在 Google 上的首选来源
情感分析估计文本、语音转录或其他内容中的评价性语言。系统可以对极性进行分类,如正面、负面或中性;检测方面级别的观点;估计强度;或识别对特定主张的立场。
目标必须谨慎定义。情感并不等同于情绪、意图、毒性、满意度或真实性。一个正面的句子可能以讽刺的方式描述有害事件,而负面的产品评论仍可能整体上推荐该产品。
关键要点
- 在收集示例之前,先定义单元、目标、标签和上下文。
- 词典是透明的基线;监督模型和 Transformer 模型能够捕获更多上下文,但需要具备代表性的数据。
- 否定、讽刺、领域词汇、多语言文本以及方面边界仍然是难点。
- 在每个类别、子群体、领域和时间段进行评估;对关键用途加入人工审查。
层级与目标
文档级分析为整个项目生成一个标签。句子级分析对各个陈述进行区分,而基于方面的分析则将情感关联到实体或属性——例如,对图像质量持正面评价,但对电池寿命持负面评价。
立场判断询问说话者是否支持特定命题,这可能与情绪基调不同。在使用文本分类方法之前,这些区分应在标注指南中明确。
词典、传统模型与 Transformer
词典为词汇分配分数,并结合否定或强度规则进行组合。它可解释且成本低廉,但在处理上下文时表现不足。传统监督模型使用词或 n-gram 特征,而 Transformer 学习上下文表示并可进行微调。
少样本提示可能很方便,但输出取决于示例和措辞。每种复杂方法都应与基线进行比较,并仅在保留的、版本化的评估集上使用少样本学习。
数据与语言挑战
标签可能反映标注者的视角,而非客观事实。领域漂移十分显著:“unpredictable”在电影中可能是赞美,在车辆中则是批评。代码切换、方言、表情符号、引用语以及讽刺都会使 token 级别的信号变得复杂。
有意平衡各类别,并防止相关作者、产品或对话在训练集与测试集之间泄漏。若模型记住了品牌或说话者,可能在表面上表现准确,却未真正学习情感。
评估与负责任的使用
报告精确率、召回率、F1 分数以及混淆矩阵,而不仅仅是准确率。按方面、长度、方言和时间审查错误,并为每种错误的运营成本校准阈值。
汇总趋势可用于研究或分流,但推断个人状态或用于就业、信用、健康或执法决策会带来更大风险。应提供不确定性、来源上下文、隐私控制以及人工审查。
标注与数据集构建
编写标注指南,明确目标实体、分析单元、标签定义、混合与中性处理、引用规则、讽刺策略以及领域示例。先与数位标注员进行试点,计算一致性,讨论分歧,并在扩大标签规模前修订任务。
抽样决定模型学习的内容。社交媒体流可能过度代表活跃账户;支持工单可能遗漏满意的客户;星级评分可能与评论文本不符。保留来源和时间元数据,遵守平台条款和隐私规定,并从决策将要实施的人群中构建测试集。
标签泄漏可能通过评分、收集系统插入的表情符号、模板签名或与情感相关的产品名称发生。对近似重复的帖子进行去重,并对对话或作者进行分组,使其语言不出现在划分的两侧。
建模选择与校准
词典系统对词分数求和,并针对否定、强化词、标点或表情符号进行调整。它们提供有用的合理性检查,并可通过领域词汇进行适配。使用 TF–IDF 特征的线性模型在部分数据集上仍具竞争力,并能揭示影响力 n-gram。
上下文编码器根据周围文本对词进行表示,并可针对极性或方面进行微调。长文档可能需要层次模型、句子聚合或检索相关片段。多语言方法可以训练单一共享模型、翻译成枢纽语言,或维护本地模型;每种方式在覆盖范围和文化适配上都有权衡。
当分数用于触发行动时,概率校准尤为重要。可靠性图和期望校准误差可显示报告的 0.8 置信度是否对应约 80% 的正确率。阈值可以设定一个弃用区间以供人工审查;当错误成本不同,采用不同阈值是合理的——而非掩盖质量不均。
应用与常见误解
汇总情感可帮助确定主题优先级、比较活动反馈或分流紧急服务信息。方面分析往往比整体极性更具可操作性,因为它明确了人们讨论的具体内容。趋势分析需要在时间维度上保持稳定的抽样和标签定义。
不要把负面帖子数量的多寡等同于整体舆论。发布行为、机器人、审查、平台人口结构、活动以及收集查询都会影响样本。情感模型并未衡量沉默的群体,措辞的变化也可能被误解为态度的变化。
在个人决策中,错误标签可能导致污名化且难以申诉。避免将情感作为员工敬业度、心理健康、信用、意图或欺骗的代理指标。当涉及到个人时,应展示来源上下文、允许纠正,并要求具备真实裁量权的人类决策者。
案例示例:客户反馈的情感分析
公司在分析支持评论时应明确是需要文档情感、方面情感、情绪、紧急程度还是问题分类。‘送货很快,但产品坏了’无法用单一的正负标签准确表示。需为目标、否定、讽刺、混合陈述、引用语和未知情况编写标注指南,并在将标签视为真值前测量标注者一致性。
将词典或线性基线与微调编码器或提示语言模型进行比较。按时间或客户划分数据,以防止近重复泄漏,并保持类别分布。仅在合法且有依据的情况下,按语言、渠道、产品和人口特征报告精确率、召回率、F1、校准和混淆情况。审查高置信度错误,因为它们在自动分流中比不确定的输出更具风险。
将情感作为聚合或优先级排序的信号之一,而非对个人状态的绝对衡量。监控词汇和产品漂移,使用审查过的示例重新训练,并允许客服纠正标签。切勿依据未经验证的情感分数推断受保护属性或对员工进行惩戒。对高层报告时,展示样本规模、不确定性、缺失数据以及驱动变化的主题,使得波动的分数促使调查,而非得出简单结论。
多语言部署不应假设翻译输入后仍保留语调、否定、习语或文化惯例。需通过母语审阅者验证每种受支持语言及混合语言模式,并在证据薄弱时提供未知结果。领域适配同样重要:在日常对话中听起来负面的词汇,可能是中性的技术描述。仅在运营证据证明其必要时,才维持独立阈值或模型,以免增加复杂性和治理负担。
实用实施清单
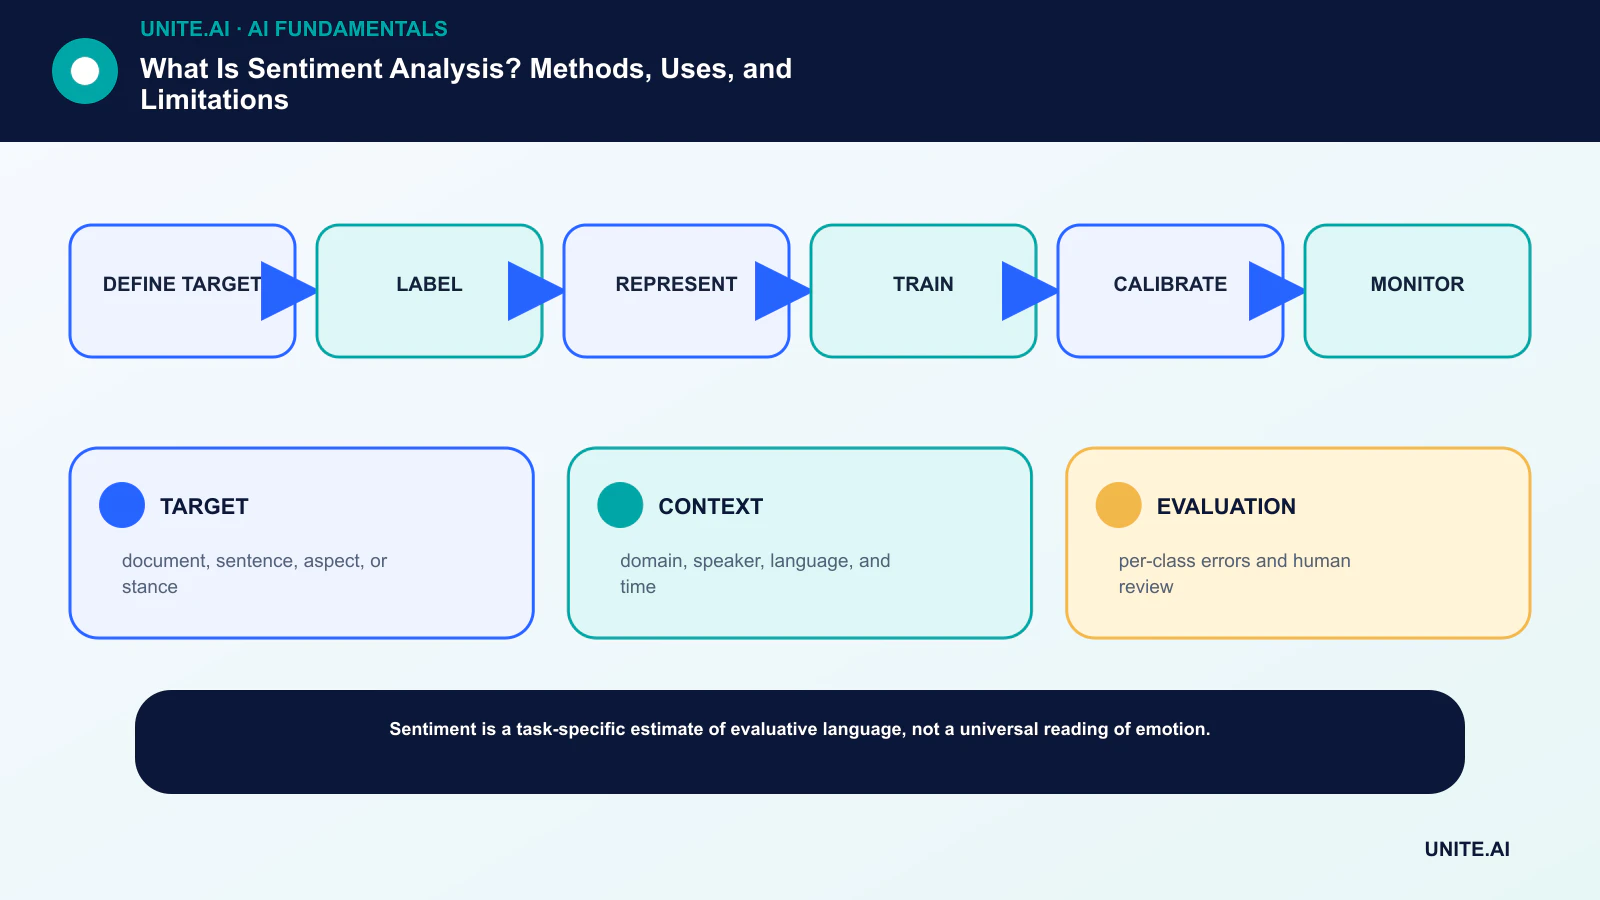
将概念转化为有界、可测试的工作流:定义目标 → 标签 → 表征 → 训练 → 校准 → 监控。指定负责人,记录数据及其依赖,建立简易基线,设定接受和停止标准,测试具代表性的失败情况,并在扩展范围前定义监控、回滚和审查。记录版本和假设,以便其他团队复现结果并了解变更内容。
上线前,进行有文档记录的准备审查,邀请构建、运营、保障以及受系统影响的人员参与。测试正常案例、边界条件、依赖失效和误用;保留证据和未解决的风险。明确谁可以批准发布、修改阈值、覆盖输出或停止运行。实际数据到来后重新评估决策,因为技术上成功的试点并不保证在更大规模下的可靠表现。
- TARGET: 文档、句子、方面或立场。
- CONTEXT: 领域、说话者、语言和时间。
- EVALUATION: 每类错误及人工审查。
常见问题
情感分析是客观的吗?
不是。它依据任务和标注过程定义的标签进行估计。有些文本本身就模棱两可、混合、依赖上下文,或因读者不同而产生不同解读。
情感分析能检测讽刺吗?
模型可以学习到部分模式,但讽刺往往依赖于说话者的历史、共享知识以及文本之外的上下文。这仍是常见的失效模式。
主要参考文献












