AI 基础
什么是混淆矩阵?

 将 Unite.AI 添加到您在 Google 上的首选来源
混淆矩阵是一张表格,用于统计分类器的预测与已知标签一致或不一致的次数。它揭示了哪些类别被混淆,并提供用于计算诸如精确率、召回率、特异度和 F1 等指标的计数。它是 监督学习 分类问题的核心诊断工具之一。
矩阵本身并不是单一的性能分数。它是对特定决策阈值、数据集和类别定义下结果的结构化视图。
关键要点
- 对于二元分类,四种结果是真阳性、假阳性、假阴性和真阴性。
- 始终标注坐标轴:不同的库和文献并不一定把实际类别和预测类别放在相同的方向上。
- 当类别不平衡时,准确率可能掩盖严重错误。
- 改变分类阈值会改变混淆矩阵以及精确率与召回率之间的权衡。
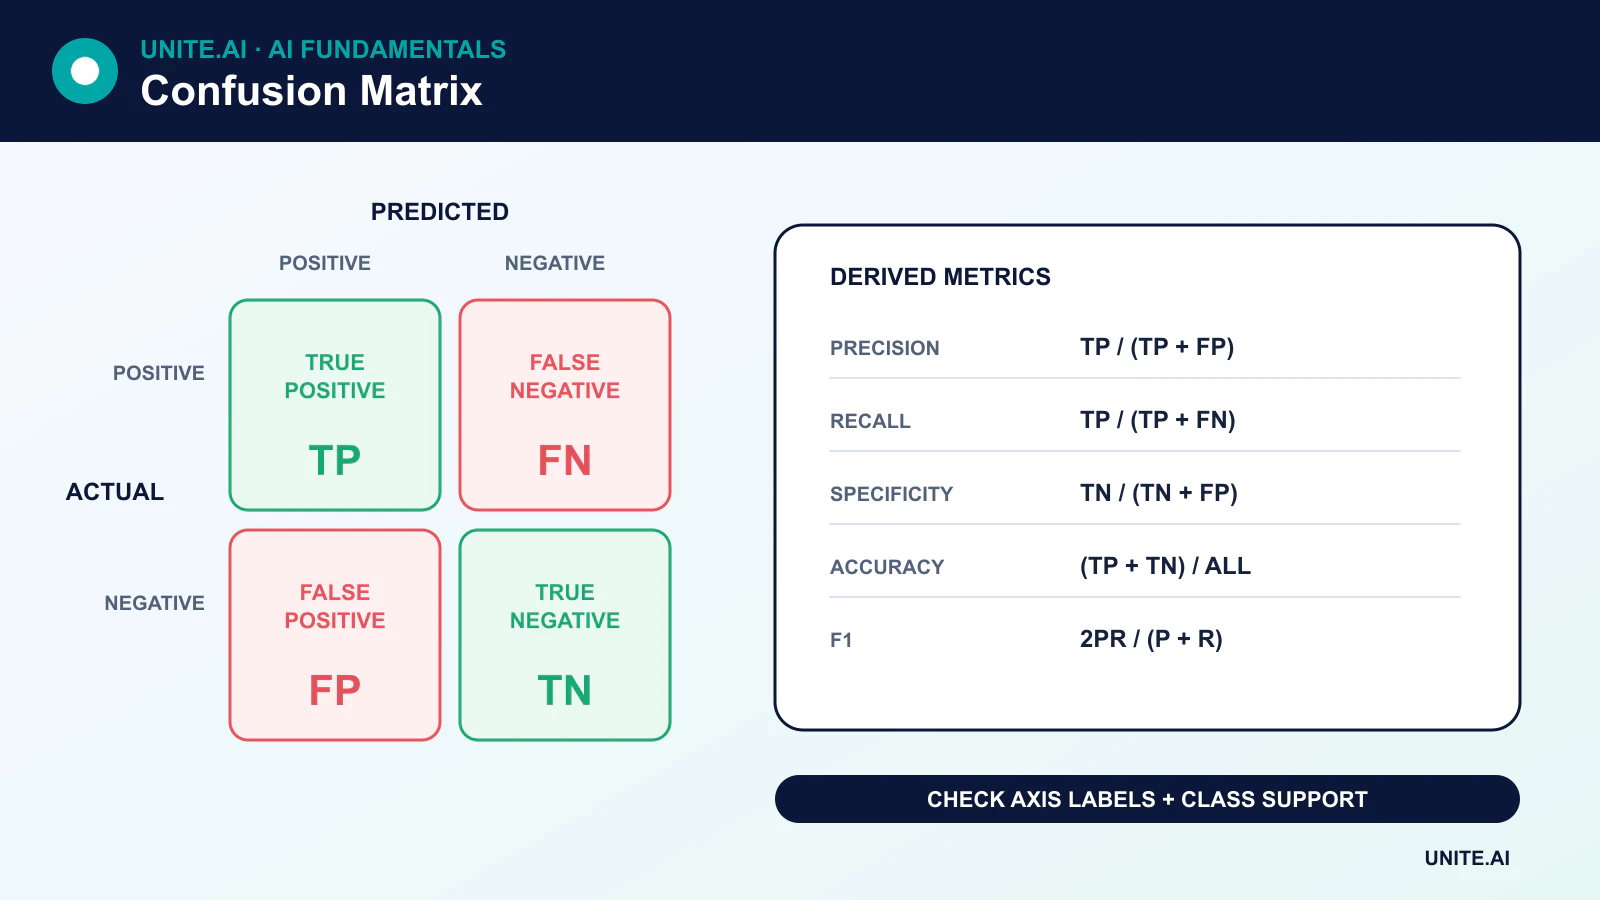
二元分类的四种结果
- 真阳性 (TP):样本为正,模型预测为正。
- 假阳性 (FP):样本为负,但模型预测为正。
- 假阴性 (FN):样本为正,但模型预测为负。
- 真阴性 (TN):样本为负,模型预测为负。
在 scikit-learn 的约定中,行表示真实类别,列表示预测类别。其他可视化可能会转置此布局,因此应以标签(而非角落位置)来指导解释。
从混淆矩阵衍生的指标
精确率
Precision = TP / (TP + FP)
精确率回答:在被预测为正的样本中,有多少比例实际上为正?
召回率或灵敏度
Recall = TP / (TP + FN)
召回率回答:在所有实际为正的样本中,模型识别出了多少比例?在二元分类中,正类召回率也称为灵敏度或真阳性率。
特异度
Specificity = TN / (TN + FP)
特异度是负类的召回率:在实际为负的样本中,模型正确拒绝了多少比例?
准确率
Accuracy = (TP + TN) / (TP + TN + FP + FN)
当类别及错误成本相对平衡时,准确率有用。但当某一类别占主导时,准确率可能具有误导性。
F1 分数
F1 = 2 × (Precision × Recall) / (Precision + Recall)
F1 通过调和平均将精确率和召回率综合在一起。它忽略了真阴性,因此并不适用于所有任务的概括。
实际案例
假设测试集包含 1,000 笔交易,其中 50 笔为欺诈。模型检测出其中 40 笔欺诈,但误标了 30 笔合法交易:
- TP = 40
- FN = 10
- FP = 30
- TN = 920
该模型的准确率为 96%,但精确率约为 57%,召回率为 80%。高准确率主要源于大量合法交易。该模型是否可接受取决于漏检欺诈的成本、调查能力以及其风险评分的校准程度。
阈值会改变矩阵
许多分类器输出的是分数而非必然的是/否答案。降低正类阈值通常会提升召回率和假阳性;提高阈值则通常提升精确率或特异度,同时漏掉更多正例。阈值应基于验证数据和实际错误成本来选择,而不是自动固定为 0.5。
精确率-召回率曲线和 ROC 曲线对不同阈值下的性能进行概括。当正类稀少时,精确率-召回率曲线往往更具信息价值。
多类别混淆矩阵
对于 K 类,矩阵为 K × K。正确预测位于对角线;非对角线单元格显示哪些类别对被混淆。每类指标可以通过不同方式进行平均:
- 宏平均:为每个类别赋予相等权重。
- 加权平均:根据每个类别的样本数量加权。
- 微平均:在计算指标之前先汇总所有结果计数。
仅报告一种平均方式可能掩盖小类别的糟糕表现。应在差异重要时提供支持计数和每类结果。
常见错误
- 在未检查坐标轴标签的情况下读取转置矩阵。
- 使用训练数据而非合适的留出集来计算指标。
- 忽视类别比例、抽样策略或跨划分的重复实体。
- 比较不同阈值下生成的矩阵时未标明阈值变化。
- 将所有假阳性和假阴性视为同等代价。
因此,混淆矩阵是一种诊断工具,而非完整评估。校准、子组分析、鲁棒性以及下游影响也应纳入分类审查。
读取每个单元格并提取有用指标
对于二元分类,混淆矩阵在选定的正类和阈值下统计真阳性、假阳性、假阴性和真阴性。准确率将正确预测除以所有案例;精确率询问预测为正的样本中有多少比例是正确的;召回率询问实际为正的样本中被找到了多少比例;特异度衡量实际为负的样本被正确拒绝的比例。F1 是精确率和召回率的调和平均。没有哪一个指标是绝对最佳的:欺诈筛查、医学分诊和垃圾邮件过滤对同一单元格赋予了不同的后果。
对于多类别问题,行通常表示实际类别,列表示预测类别,尽管约定各有不同,因此必须明确标签。One-vs-rest 计数产生每类的精确率和召回率。宏平均对各类别赋予相等权重;微平均在汇总决策后更倾向于常见类别;加权平均则依据类别支持度进行。多标签任务允许每个样本拥有多个标签,需要按标签或按样本定义指标。可按行归一化以检查召回模式,或按列归一化以检查预测构成,但应保留原始计数,以免稀有组在视觉上被放大。
阈值、不确定性与运营决策
混淆矩阵在单一阈值下概括了硬决策。可使用精确率-召回率或 ROC 曲线比较不同阈值,然后依据容量、患病率和错误成本选择运营点。校准关注预测概率是否与实际频率相匹配,且独立于排序。当患病率变化时,即使灵敏度和特异度保持稳定,精确率也可能变化。应报告置信区间或自助法波动,并避免仅凭小子群中的少量错误得出结论。
按时间、地点、设备、语言及相关受影响群体审计矩阵,以发现集中错误。将模型与现有决策流程(包括人工审查)进行比较。对于级联系统,记录每个阶段的错误:检索、分类、阈值设定和行动。监控实时结果标签及其延迟和纠正流程。表面上提升的 F1 仍可能增加有害的假阴性或超出审查容量。混淆矩阵是一份决策账本;需将每个单元格关联到受错误影响的对象以及随后的响应。
实际案例:选择医学筛查阈值
一个 机器学习 筛查模型为低患病率的疾病输出风险评分。团队在不同阈值下生成混淆矩阵,并报告灵敏度、特异度、精确率、误报和漏报案例的置信区间。由于阳性预测值取决于患病率,模型针对目标人群进行建模,而不是引用单一数据集的精确率。结果按设备、地点、年龄、性别及其他临床合理的分组进行细分。
临床医生选择一个在保持所需灵敏度的同时不致使确认检测负荷过重的运营点。矩阵被换算为每 10,000 名筛查人群的预期计数,以便直观了解后果。超出验证条件的评分不产生自动结论。监控将预测与延迟确认的诊断进行比较,跟踪容量和校准,并在患病率或获取方式变化时触发审查。混淆矩阵始终与具体模型、阈值和人群相连。
实施证据与运营准备
生产决策需要的不仅是成功演示。应明确预期用户、运行环境、输入、输出、依赖关系、负责人以及每项关键故障的后果。调优前建立可复现的基线和带版本号的评估集。测试常规案例、边界条件、格式错误或缺失的输入、分布漂移、依赖中断、误用以及最可能被忽视的群体或环境。将任务质量与校准或不确定性、延迟、吞吐量、资源成本、可访问性、隐私和安全性一起衡量。记录每一次转换和阈值,以便独立审查员能够复现结果并将证据与吸引人的原型区分开来。
上线前,指定发布、例外、变更、回滚和退役的授权人。采用分阶段发布,保留安全回退,并通过人为注入故障来验证监控。运营遥测应展示输入质量、输出行为、模型或规则版本、依赖健康状况、人为覆盖以及已确认的结果,同时避免收集不必要的敏感数据。设定警报阈值和响应负责人,然后在部署后审查真实世界的证据,而不是假设离线性能会持续。每当数据来源、用户、模型、供应商、政策、硬件或目标发生变化时,都需重新评估。维护中的系统还需有文档化的恢复、事件学习、删除与保留流程,以及明确的停用或替换时点。
常见问题
什么是归一化混淆矩阵?
归一化是将计数除以真实类别总数、预测类别总数或全部观测值。它使得跨类别的比率更易比较,但报告仍应保留原始支持计数,以免将小群体误认为与大群体等量。
混淆矩阵能评估回归吗?
不能直接。混淆矩阵要求离散的类别。对连续目标进行分箱会丢失信息;回归通常应使用残差分析以及针对连续值设计的指标,如 MAE 或 RMSE。
主要参考文献