AI 基础
什么是支持向量机?

 将 Unite.AI 添加到您在 Google 上的首选来源
支持向量机(SVM)是一种监督学习方法,旨在寻找类之间具有最大可能间隔的决策边界。决定该边界的训练样本称为支持向量。
SVM 可以实现线性或非线性分类、回归以及新颖性检测。它们在特征信息丰富的小到中等规模数据集(包括高维稀疏数据)上表现尤为出色,但在极大规模数据集上训练成本可能变得不可接受。
关键要点
- SVM 最大化边界与最近训练点之间的最小间隔。
- 支持向量是数据点,而非额外的超平面。
- 参数 C 在间隔宽度与违规惩罚之间进行平衡。
- 核函数在隐式特征空间中计算相似度,无需显式构造每个转换后的特征。
最大间隔的概念
对于线性二分类器,决策边界是一个超平面:
w · x + b = 0
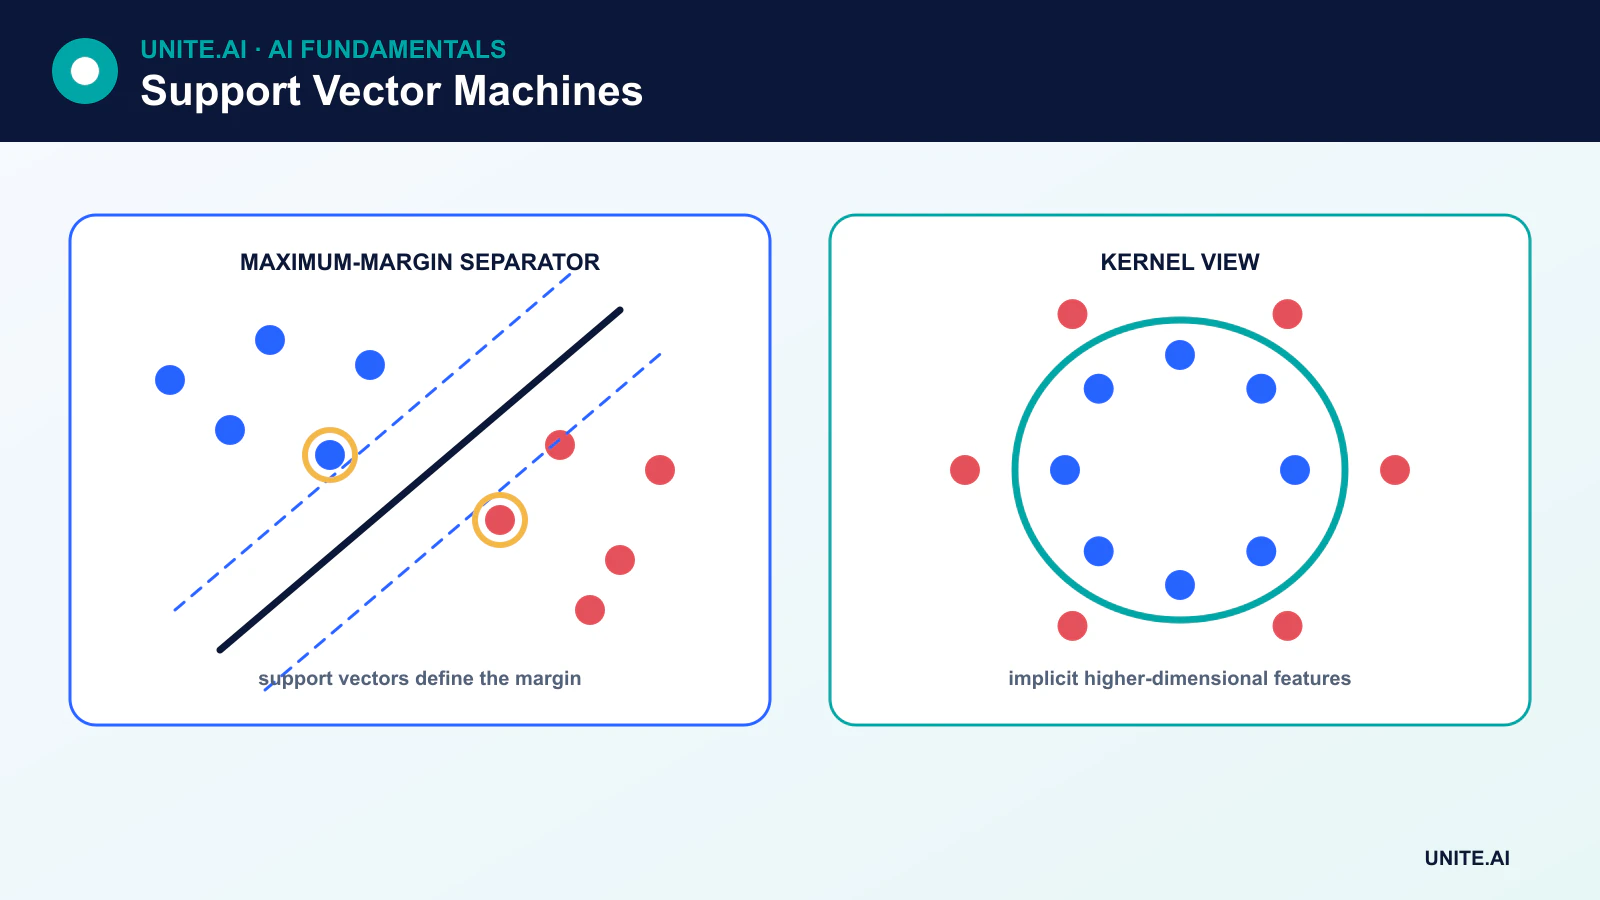
向量 w 决定方向,b 决定偏移。许多超平面都可以将训练类分开。SVM 选择能够使两侧最近样本距离最大化的那条超平面。最近的样本即为支持向量,对拟合边界影响最大。
目标并非独立地最大化边界到每个点的距离,而是最大化最小间隔,同时满足或对类别约束进行惩罚。
硬间隔与软间隔
硬间隔 SVM 要求完美的线性可分,对异常值极为敏感。实际数据集通常需要软间隔,它为位于间隔内部或边界错误侧的样本引入松弛变量。
超参数 C 控制对这些违规的惩罚:
- 较大的 C 对违规惩罚更严厉,通常会产生更窄的间隔,使模型更紧贴训练样本。
- 较小的 C 允许更多违规,以换取更宽且更正则化的间隔。
支持向量的数量取决于数据和求解结果;增大 C 并不能保证得到特定数量的支持向量。
核技巧
在原始特征空间中,某些类别无法通过直线超平面分离。核函数计算对应于另一特征空间的内积,使 SVM 能在不显式计算每个转换后坐标的情况下拟合非线性边界。
常用的核函数包括:
- Linear: 适用于文本等高维稀疏特征,计算效率高。
- Polynomial: 捕捉最高到指定次数的特征交互。
- Radial basis function (RBF): 基于距离创建灵活的局部边界。
- Sigmoid: 类似神经网络的激活函数,但较少作为默认选择。
对于 RBF SVM,gamma 控制每个训练样本对边界的局部影响程度。较大的 gamma 会产生高度细致的区域并导致过拟合;较小的 gamma 则产生更平滑的影响。
多类分类
传统的 SVM 目标是二分类。各库通过 一对其余 (one-vs-rest)(为每个类别训练一个分类器)或 一对一 (one-vs-one)(为每对类别训练分类器并组合决策)等策略进行扩展。多类 SVM 并不是仅绘制比类别数少一条的分界线。
支持向量回归与单类 SVM
支持向量回归(SVR)在 epsilon 宽度的管道内忽略误差,仅对更大的偏差进行惩罚,从而拟合函数。单类 SVM 估计典型数据的边界,可用于新颖性检测。异常点并不必然代表欺诈或故障;它只是相对于已拟合表示而言异常。
实际需求
SVM 依赖距离和内积,因此数值特征通常需要归一化。C、核函数、gamma 和类别权重应通过验证进行选择。概率估计并非间隔固有属性,通常需要校准,这会增加成本,需要单独评估。
核 SVM 的训练时间随样本数量呈二次或三次增长,取决于数据和实现方式。线性 SVM 变体或随机线性模型更适合极大规模数据集。对于原始图像、音频或语言,深度学习得到的表示往往更有效,而 SVM 仍可对固定的嵌入进行分类。
SVM 的优势与局限
SVM 在特征众多的情况下表现良好,提供明确的正则化目标,并在预测时主要依赖支持向量。其局限性包括对特征缩放和超参数的敏感性、训练成本可能较高、非线性核下可解释性降低,以及需要进行概率校准。
间隔、核函数与优化目标
支持向量机旨在寻找类间具有大间隔的分离超平面。只有位于间隔上或内部的支持向量决定边界。软间隔 SVM 引入松弛以容忍重叠和错误标记的样本;参数 C 在更宽的间隔与训练违规之间进行权衡。由于距离和点积驱动求解,输入通常需要归一化。当错误代价和类别分布不均时,类别权重或重采样有助于平衡,但阈值和概率仍需独立验证。
核技巧将相似度评估为若输入被映射到更高维特征空间后的内积。线性、 多项式、 径向基函数以及专用核函数分别编码不同假设。对于 RBF 核,gamma 控制每个点对边界的局部影响程度:高 gamma 会产生复杂区域并导致过拟合,低 gamma 则可能欠拟合。核矩阵随样本数呈二次增长,使非线性 SVM 在大数据集上成本高昂。大规模情况下,线性求解器或近似特征映射更为可取。
多类使用、校准与运营限制
二分类 SVM 可通过一对其余、一对一或结构化形式扩展为多类。超参数需在交叉验证中调优,必要时采用分组或时间切分。评估每类的精确率、召回率、间隔分布、校准情况以及在分布漂移下的表现。原始决策分数并非概率;Platt 缩放或等距校准使用独立数据,若类别比例变化可能导致性能下降。应在相同的预处理和调参工作量下,与逻辑回归、树模型以及现代基于表示的方法进行比较。
部署时必须使用完全相同的特征缩放器、特征顺序、核参数、支持向量以及类别映射。核 SVM 的预测成本随支持向量数量增长,因此需在真实批次上测量延迟和内存。远离训练支持向量的输入仍可能得到高置信度标签;必要时加入分布外检测或拒绝策略。检查错误是否源自敏感代理或数据集瑕疵。SVM 在中等规模、高维问题上依然表现出色,但最大几何间隔并不等同于因果结构或安全性保证。
实战示例: 一个用于稀有文档路由的 SVM
某法律运营团队使用 TF–IDF 特征和线性 SVM 将简短的文件归类到路由类别。为防止模板泄漏,团队按案件和时间进行划分;根据审查错误成本对类别权重进行缩放,并在嵌套验证中调优 C。线性模型与逻辑回归和 Transformer 进行比较。每类的精确率、召回率、校准以及审稿人工作量比整体准确率更为关键。
决策分数在独立数据上进行校准,低间隔或不支持的语言文档则转入人工处理。部署产物包括分词器、词表、加权方式、模型、校准器以及标签映射。监控会跟踪新词、类别分布、间隔以及纠正后的路由。文档和支持向量受到保护,因为文本特征可能泄露机密信息。当非线性核带来的质量提升不足以抵消延迟、内存和可解释性成本时,将被放弃。
实施证据与运营准备
生产决策需要超越成功演示的依据。需明确目标用户、运行环境、输入输出、依赖关系、负责人以及每类关键故障的后果。调参前建立可复现的基线和带版本的评估集。测试常规案例、边界条件、格式错误或缺失的输入、分布漂移、依赖中断、误用以及最可能被忽视的群体或环境。衡量任务质量时同步评估校准或不确定性、延迟、吞吐量、资源成本、可访问性、隐私和安全性。记录所有转换和阈值,以便独立审阅者复现结果并将证据与吸引人的原型区分开来。
上线前,需明确发布、例外、变更、回滚和退役的责任人。采用分阶段发布,保留安全回退,并通过人为注入故障验证监控。运营遥测应展示输入质量、输出行为、模型或规则版本、依赖健康状况、人为覆盖以及已确认的结果,且不收集不必要的敏感数据。设定警报阈值和响应负责人,部署后审查真实世界的证据,而非假设离线表现会持续。每当数据源、用户、模型、供应商、政策、硬件或目标变化时都需重新评估。维护中的系统还需有文档化的恢复、事故学习、删除与保留流程,以及明确的停用或替换时机。
常见问题
SVM 只用于分类吗?
不是。支持向量回归用于预测连续目标,而单类 SVM 可以估计新颖性边界。每种变体都有不同的目标和超参数集合。
何时线性 SVM 是合适的选择?
在线性高维稀疏特征(包括传统文本表示)上,线性 SVM 通常表现出色,此时使用灵活的核函数会增加成本却没有明显收益。
主要参考文献