
AI 模型与平台
Appen 新推出即装数据集(OTS),加速人工智能部署

 将 Unite.AI 添加到您在 Google 上的首选来源
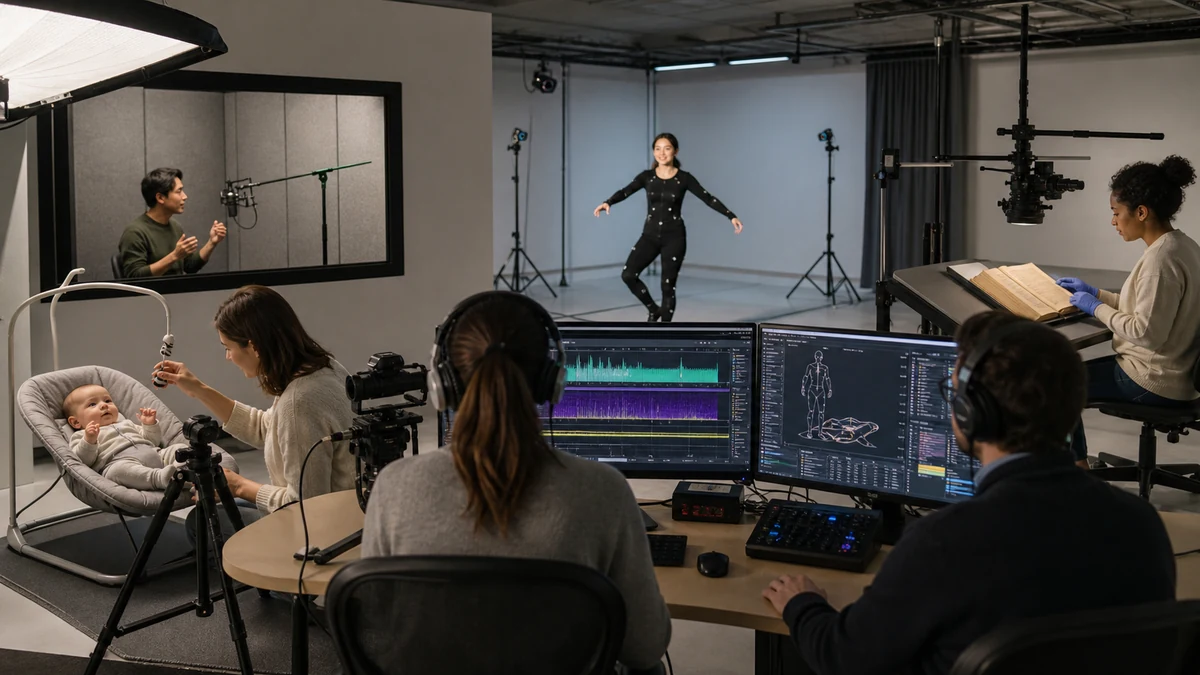
Appen Limited (ASX:APX),一家为大规模构建有效人工智能系统的组织提供高质量训练数据的领先供应商,今日宣布推出新的即装数据集(OTS)。这些数据集旨在使企业更容易、更快速地获取高质量的训练数据,以加速其人工智能(AI)和机器学习(ML)项目。新的OTS数据集包括人体运动和创新性的婴儿哭声,以及适合光学字符识别(OCR)的脚本语音和图像,适用于阿拉伯语、克罗地亚语、希腊语、匈牙利语、泰语等高需求但难以获取的语言。随着数据集的扩展,Appen的OTS产品线现在包括超过250个数据集,涵盖超过11,000小时的音频、超过25,000张图像和超过8,700万字的文本,跨越80种语言和多种方言。
Appen的OTS数据集是一种快速、经济有效的工具,可以让企业以高质量的训练数据启动人工智能或机器学习项目。扩展人工智能能力的团队也可以利用OTS数据集有效地提高准确率、开发新模型技能并将其他改进融入其人工智能模型中。通常,OTS数据集可以在一周内交付,而新数据集的收集和注释项目可能需要八到十二周,甚至更长时间,具体取决于复杂性。所有Appen数据集都是使用完全透明的、选择加入的方法开发的,因此人工智能专家可以确保其数据是干净的、符合要求的,消除了潜在的反弹和声誉损害风险。
“全球各地的AI团队正在从事具有紧迫截止日期和灵活数据要求的项目,可以从使用即装数据集中受益,”Appen首席技术官Wilson Pang说。“OTS数据集缩短了实现价值的时间,并以传统方法无法实现的低总成本提供高质量的数据。我们在Appen采取必要的步骤,以确保所有我们的数据集都是以道德的方式获取和人口统计学平衡的,使公司能够通过最小化模型中的偏见和确保数据注释者的公平对待来保持负责的AI实践。你总是知道OTS数据集的确切质量,这有助于构建更好的在现实世界中起作用的人工智能。”
MediaInterface已经为德国和欧洲其他地区的医疗保健机构提供语言技术解决方案超过20年。当公司扩展到法国时,它拥有完全本地化的软件,但缺乏法语词汇数据,特别是法语名称和地点,这些经常在患者健康信息中被引用。使用Appen的OTS数据集,MediaInterface获得了大约21,000个法语名称和14,000个地名。“来自Appen的关键数据已被纳入我们的背景词汇中,以成功推出新市场,这有助于我们为客户构建新的词汇并加强我们对未来的市场推出的方法,”MediaInterface产品经理Ines Wendler说。
最有经验的AI专家将OTS数据集与按需数据收集和注释项目相结合,以满足其复杂的AI模型训练数据需求。Appen是提供持续支持的领导者,通过一系列特定的数据收集服务,例如持续数据注释和智能标记,通过AI驱动的工具和自动化工作流程来最大化效率。
“我们从醒来到睡觉的每一刻都与人工智能互动——通过虚拟助手、聊天机器人、搜索引擎、社交网络、医疗设备、智能汽车和其他应用程序,”Appen高级AI专家总监Judith Bishop说,她领导着一支由100名AI语言学家和语言专家组成的团队。“语言通常是许多这些令人信服的AI用例的主要接口,因此为了保证良好的体验,模型需要被训练为适用于所有人。Appen致力于高质量的数据和负责的、道德的AI开发,使公司购买我们的即装数据集能够完全信任其数据来加速其AI项目。”
加入现有数百个已经在appen.com上线的数据集,新推出的Appen即装数据集包括:
- 阿拉伯语(埃及)、阿拉伯语(沙特阿拉伯)、阿拉伯语(阿联酋)、高棉语(柬埔寨)、克罗地亚语、希腊语、匈牙利语、波兰语、西班牙语(西班牙)和土耳其语的脚本语音
- 简体中文印刷文本、泰语印刷文本和芬兰语印刷文本的图像OCR——包括预先录制的广告牌、外包装、标志、杂志和菜单,以训练和更新计算机视觉OCR模型
- 人体运动(中国)- 包括注释的视频,跟踪像素级别,适合游戏开发、健身应用等
- 婴儿哭声音频(中国)- 包括预先录制和注释的婴儿声音,可以用来训练AI模型识别不同的哭声并提醒父母
如需更多信息和请求Appen OTS数据集样本,请点击这里。


