
Anderson 视角
GAN作为传统CGI的面部渲染器

 将 Unite.AI 添加到您在 Google 上的首选来源

要点在生成对抗网络的潜在空间中,将身份与表达分离开来,仍然是面部视频合成的核心未解难题。
查看更多
- 在生成对抗网络的潜在空间中,将身份与表达分离开来,仍然是面部视频合成的核心未解难题。
- 像SMPL和3DMM这样的参数化CGI模型,正越来越多地被用来规范生成对抗网络难以控制的潜在编码。
- 迪士尼的“风格化渲染”混合方法通过将传统纹理贴图与生成对抗网络生成的图像融合,产生了令人不安的逼真效果。
观点 当生成对抗网络(GAN)首次展现出生成惊人逼真的三维人脸的能力时,人们开始争相探索其尚未开发的潜力:生成在时间上保持一致的人脸视频。
在GAN的潜在空间中,似乎必定存在某种隐藏的秩序和理性:埋藏在潜在编码中的初步语义逻辑,使GAN能够从多个视角、以不同方式(例如改变表情)一致地生成同一个人的脸,进而提供一种在时间上令人信服的深度伪造视频方法,大幅超越自动编码器。
相比GPU限制迫使DeepFaceLab和FaceSwap采用的低分辨率环境,高分辨率输出本应轻而易举。自动编码器工作流程中的面部替换区域,将成为GAN依据少量输入图像甚至单张图像进行创作的区域。
被替换人脸与承载人脸之间将不再有不匹配,因为整张图像都会从头生成,包括头发、下颌轮廓和面部特征的外缘,而这些通常是传统自动编码器深度伪造的难点。
GAN人脸视频的寒冬
事实证明,事情没有那么简单。最终,解耦成为核心问题,至今仍是主要挑战。如何保留清晰可辨的面部身份,同时改变姿态或表情,而不必像自动编码器那样费力地收集数千张参考图像,教会网络这些变化会产生什么结果?
后续GAN人脸动画与合成研究转而提出:可以对输入身份施加有目标、通用且模板化的变换,而不针对该身份本身。例如,给GAN生成的人脸添加一种表情,而这种表情从未出现在GAN已知的该人物照片中。

2022年论文《Tensor-based Emotion Editing in the StyleGAN Latent Space》将模板化表情应用于来自FFHQ数据集的输入人脸。 来源:https://arxiv.org/pdf/2205.06102.pdf
显然,一刀切的方法无法涵盖每个人独有的丰富表情。我们不禁要问:在这种平均表情潜在编码的影响下,杰克·尼科尔森或威廉·达福那样独特的笑容能否得到忠实呈现?

这位迷人的拉丁裔陌生人是谁?尽管GAN方法生成的人脸更逼真、分辨率更高,变换却没有依据演员的多张真实照片;DeepFaceLab则会对数千张此类图像进行大量训练。因此,人物相似度受到影响。背景中,一个DeepFaceLab模型被导入DeepFaceLive,这是该流行而有争议的软件的流媒体实现。 示例来自https://www.youtube.com/watch?v=9tr35y-yQRY(2022)和https://arxiv.org/pdf/2205.06102.pdf。
近年来提出了多种GAN表情编辑工具,其中大多数处理不熟悉的人物身份。由于读者不认识这些人,通常无法判断变换是否忠实。

2020年的Cascade-EF-GAN对陌生人物身份进行变换。 来源:https://arxiv.org/pdf/2003.05905.pdf
过去三年中,获得最多关注和引用的GAN人脸编辑器或许是InterFaceGAN。它可以沿着与姿态(相机或面部角度)、表情、年龄、种族、性别及其他重要属性有关的潜在编码遍历潜在空间。
InterFaceGAN等框架采用的20世纪80年代风格式变形功能,主要展示图像通过适当潜在编码(例如年龄)重新投影时的变换路径。然而,对制作具有时间连续性的视频而言,这些方案迄今可谓令人印象深刻的灾难。
如果再考虑生成时间一致的头发的难度,以及潜在编码探索和操纵本身没有时间指导机制,那么可以合理地认为,GAN并非人脸视频合成所需的一切™。如何把这种指导加入一个为静态图像设计、原本不支持视频输出的框架,本身就不明确。
此后的努力带来了渐进式改进,增强了解耦能力;另一些研究则加入计算机视觉方法作为指导层,例如2021年末的论文 《SemanticStyleGAN:学习用于可控图像合成与编辑的组合生成先验》,以语义分割作为控制机制。
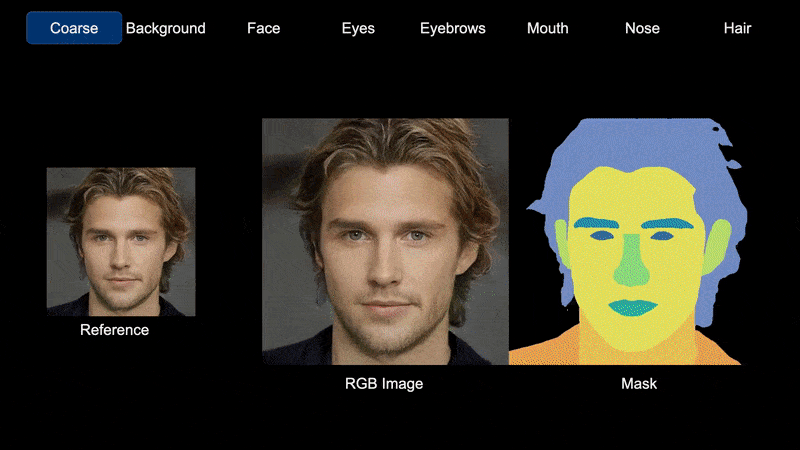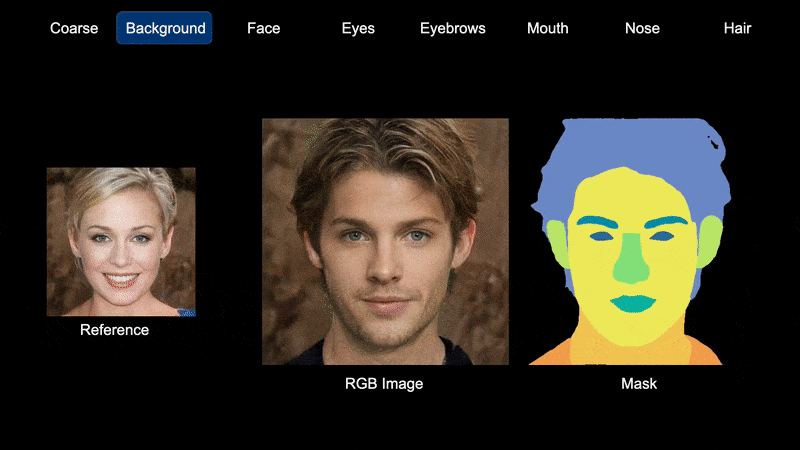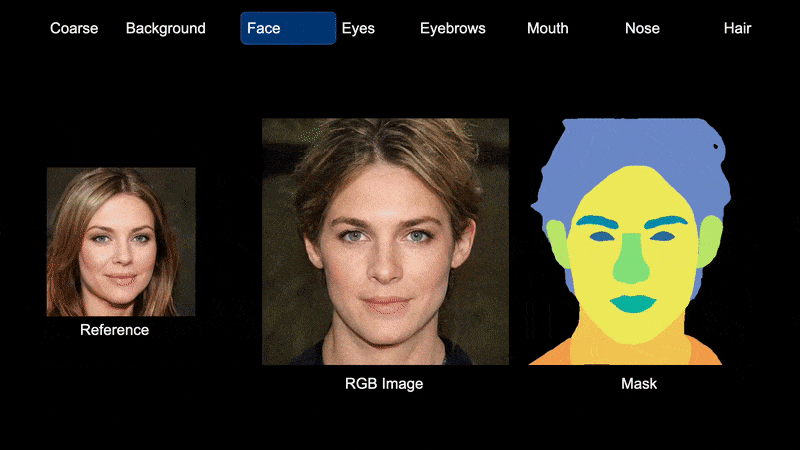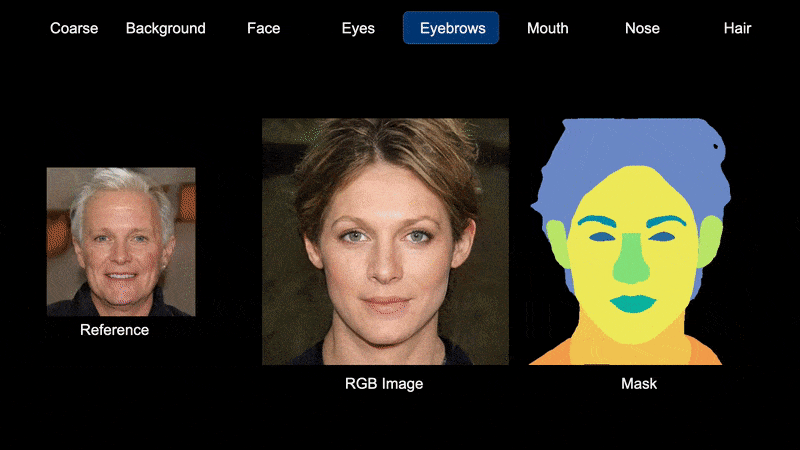
SemanticStyleGAN利用语义分割控制潜在空间。 来源:https://semanticstylegan.github.io/
参数化指导
GAN人脸合成研究越来越倾向于使用传统参数化CGI人脸,引导并组织那些能力惊人却难以控制的潜在编码。
参数化人脸基元用于计算机视觉研究已有二十多年。近期,随着Skinned Multi-Person Linear Model(SMPL)参数化CGI基元使用增多,人们重新关注这一方向。该方法由马克斯·普朗克研究所和ILM开创,后来通过Sparse Trained Articulated Human Body Regressor(STAR)框架得到改进。

SMPL(此处为名为SMPL-X的变体)可以施加参数化CGI网格,使其匹配图像中整个身体的估计姿态,必要时也包含表情。该网格可作为体积或感知指导,支持对图像进行新的操作。 来源:https://arxiv.org/pdf/1904.05866.pdf
该方向最受赞誉的进展,是迪士尼2019年的Rendering with Style项目。它把传统纹理贴图与GAN生成图像相结合,尝试制作质量更高、类似深度伪造的动画。

迪士尼生成GAN深度伪造的混合方法,将旧技术与新技术相结合。 来源:https://www.youtube.com/watch?v=TwpLqTmvqVk
迪士尼的方法把传统渲染的CGI元素输入StyleGAN2网络,补绘人脸中的问题区域,例如皮肤纹理;这些区域在视频生成中难以保持时间一致。

Rendering with Style工作流程。
由于驱动过程的参数化CGI头部可以按用户需要调整,GAN人脸也能体现这些变化,包括头部姿态和表情变化。
该方法旨在融合CGI的可控性与GAN人脸的自然真实感,结果却显示了两者的缺点,仍无法保持头发纹理乃至基本面部特征位置的一致性。
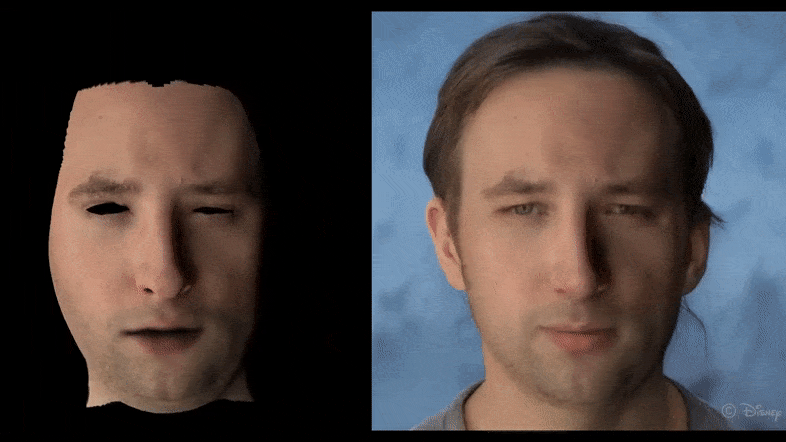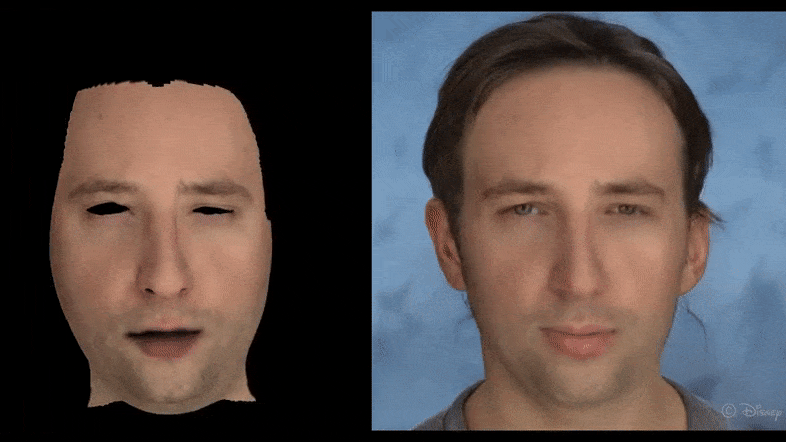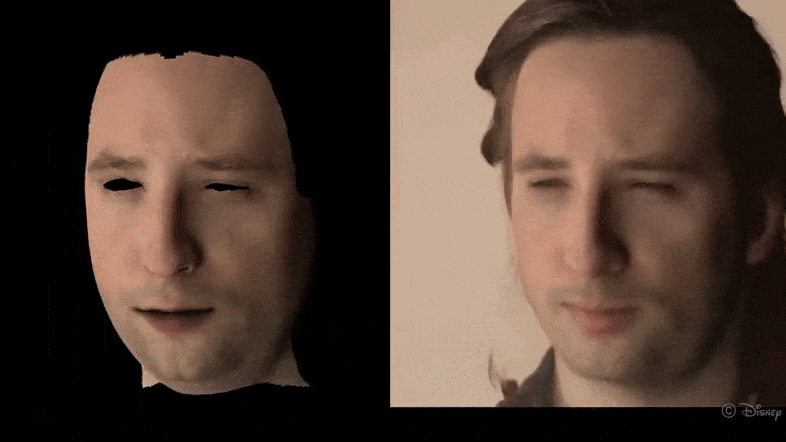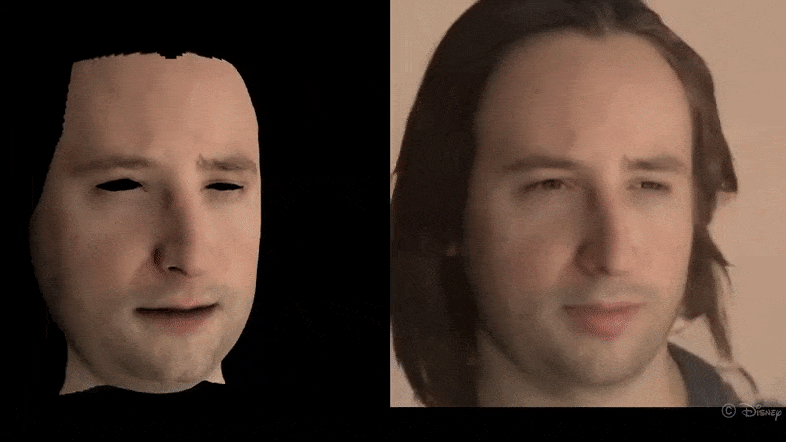
Rendering with Style产生了一种新的恐怖谷现象,不过其原理仍有一定潜力。
2020年的论文 《StyleRig:通过绑定StyleGAN实现肖像图像的三维控制》采用越来越流行的方法,以三维可变形人脸模型(3DMM)作为中介,改变StyleGAN中的属性;这里由名为RigNet的新绑定网络实现。

StyleRig使用3DMM作为解释潜在空间的中介。 来源:https://arxiv.org/pdf/2004.00121.pdf
但与此类研究的一般情况一样,迄今结果似乎局限于小幅姿态操作,以及没有依据个人特征进行指导的表情或情感变化。

StyleRig提高了可控性,但时间一致的头发仍是未解决的难题。 来源:https://www.youtube.com/watch?v=eaW_P85wQ9k
三菱研究的MOST-GAN也有类似结果。这篇2021年的论文使用非线性3DMM作为解耦架构,但同样难以实现动态且一致的运动。
最新尝试结合可控性与解耦的研究是《One-Shot Face Reenactment on Megapixels》,它同样使用参数化3DMM头部,作为StyleGAN的友好接口。

在One-Shot Face Reenactment的MegaFR流程中,网络将反演到潜在表示的真实图像,与从已渲染3DMM模型中获取的参数相结合,实现人脸合成。 来源:https://arxiv.org/pdf/2205.13368.pdf
OSFR属于日益增多的GAN人脸编辑器,试图建立类似Photoshop或After Effects的线性编辑流程。用户可以输入所需图像,再对其实施变换,而不必在潜在空间中寻找对应某个人物身份的编码。
但参数化表情仍是一种概括性、非个性化的表情注入方式,所产生的变换会以自己的方式显得怪异,而且并不总是积极的。

注入OSFR的表情。
与以往研究类似,OSFR可以从单张图像推断接近原始姿态的姿态,也能进行正面化,将偏转角度的人脸转换为正面肖像。

新论文所述一种OSFR实现中的原始图像(上)与推断出的正面肖像。
实际上,这种推断类似于支撑神经辐射场(NeRF)的部分摄影测量原理。但这里必须依据单张照片确定几何结构,而不是NeRF使用的3至4个视角;后者利用这些视角推断缺失的中间姿态,创建可探索的含有人物的神经三维场景。
(不过,NeRF也并非所需的一切™。在人脸视频合成方面,它面对的障碍与GAN几乎完全不同。)
GAN在人脸视频合成中有一席之地吗?
从单张源图像获得动态表情和超出训练分布的姿态,似乎是当前GAN人脸合成研究中的炼金术式执念。这主要因为GAN是目前唯一能输出较高分辨率、相对高保真神经人脸的方法。自动编码器深度伪造框架虽能利用大量真实姿态和表情进行训练,但输入输出分辨率受VRAM限制,且需要承载图像。NeRF也有类似限制;与另外两种方法不同,它目前没有成熟的表情修改方法,总体可编辑性也有限。
准确的CGI/GAN人脸合成系统似乎只能寄望于新的方法:在潜在空间中组装由多张照片构成的身份实体。这样,人物身份编码不必穿越整个潜在空间以利用无关的姿态参数,而能把自身相关的真实图像作为变换参考。
即便如此,或者即便像自动编码器训练集那样,用单一身份的人脸图像训练整个StyleGAN网络,缺失的语义逻辑仍可能需要由语义分割或参数化3DMM人脸等辅助技术提供。至少在这种情况下,它们会有更多素材可用。


