
Anderson 视角
AI 辅助对象编辑:谷歌 Imagic 与 Runway “Erase and Replace”

 将 Unite.AI 添加到您在 Google 上的首选来源

本周,两个全新但截然不同的 AI 驱动图形算法为终端用户提供了对照片中对象进行高度细粒度且有效的修改的新方式。
首个算法是来自 Google Research、以色列理工学院和魏茨曼科学研究所合作的 Imagic。Imagic 通过对扩散模型进行微调,实现了基于文本的细粒度对象编辑。

随心所欲地更改想要的部分,保持其余不变——Imagic 承诺仅对您想更改的区域进行细粒度编辑。 来源: https://arxiv.org/pdf/2210.09276.pdf
任何尝试在 Stable Diffusion 的重新渲染中仅修改单个元素的人都深有体会:每当一次成功的编辑完成,系统往往会改动另外五个本来已经满意的细节。这一缺陷导致许多最有才华的 Stable Diffusion 爱好者不得不在 Stable Diffusion 与 Photoshop 之间来回切换,以修复这种“附带损伤”。仅从这一点来看,Imagic 的成就已经相当值得关注。
撰稿时,Imagic 甚至尚未发布宣传视频;再加上 Google 对无约束图像合成工具的 审慎态度,我们是否以及在何种程度上能够试用该系统仍未可知。
第二款产品是 Runway ML 更加易用的 Erase and Replace 功能,它是该公司完全在线的机器学习视觉特效工具套件中 “AI Magic Tools” 部分的 新特性。
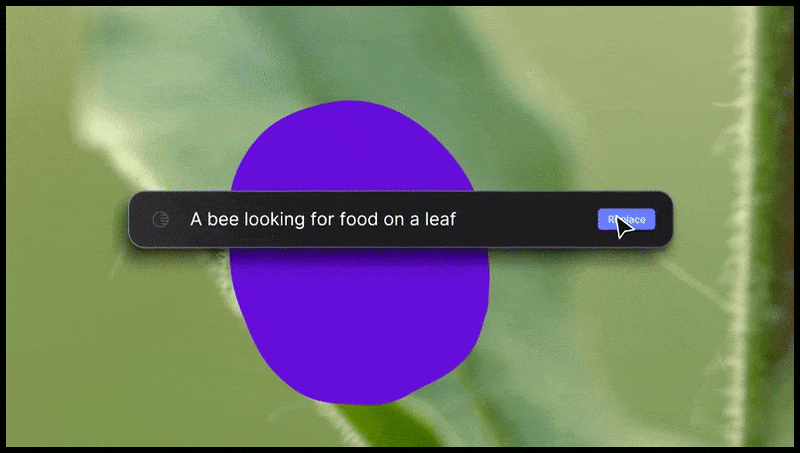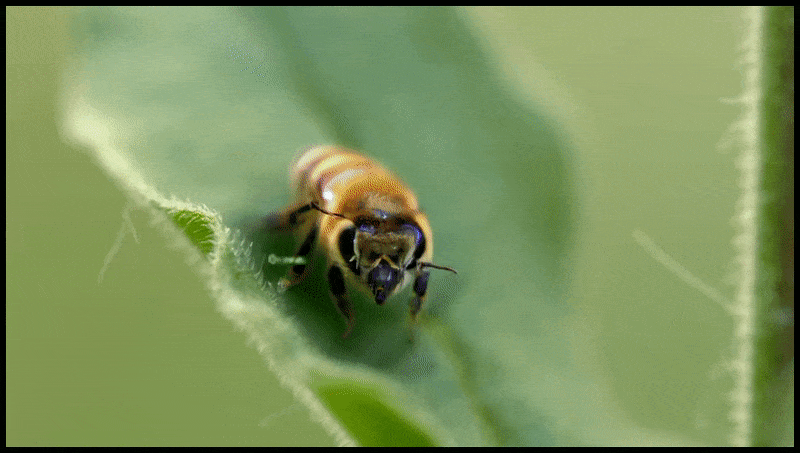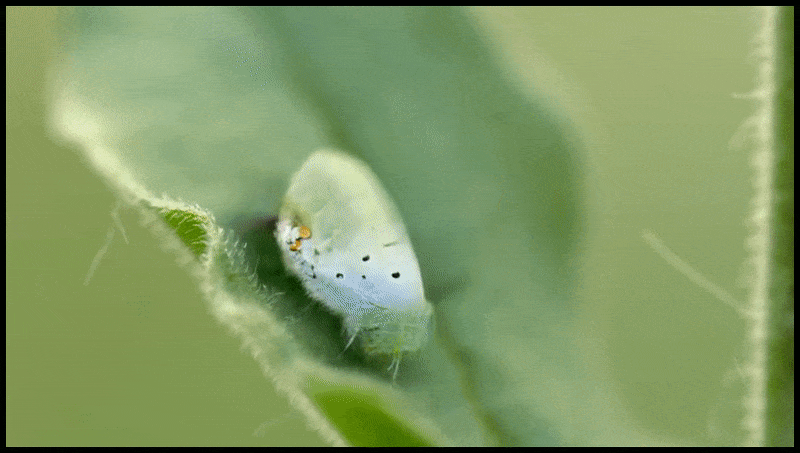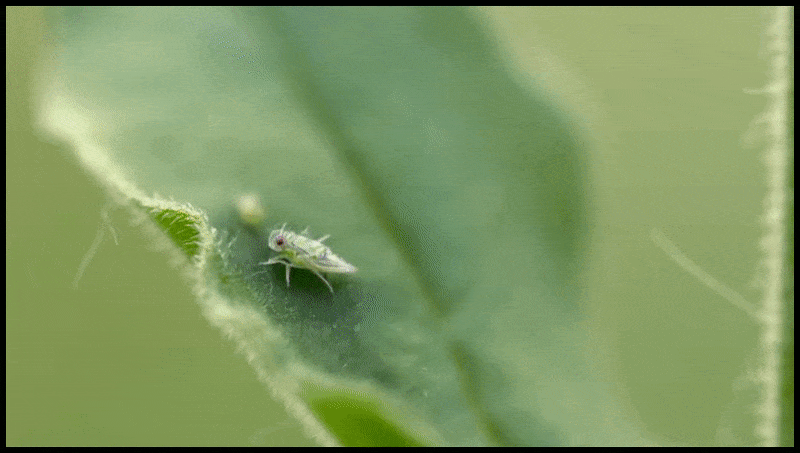
Runway ML 的 Erase and Replace 功能,已在文本转视频编辑系统的预览中出现。
先来看看 Runway 的这项功能。
擦除并替换
与 Imagic 类似,Erase and Replace 仅针对静态图像,尽管 Runway 已在尚未发布的文本转视频编辑方案中 预览 了相同的功能:
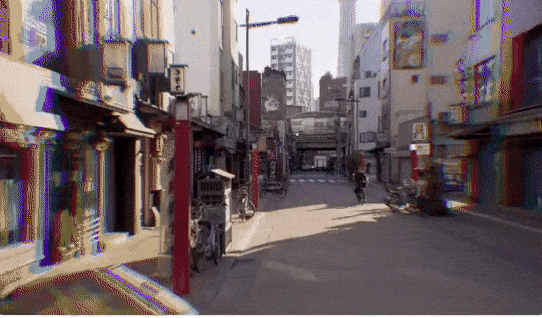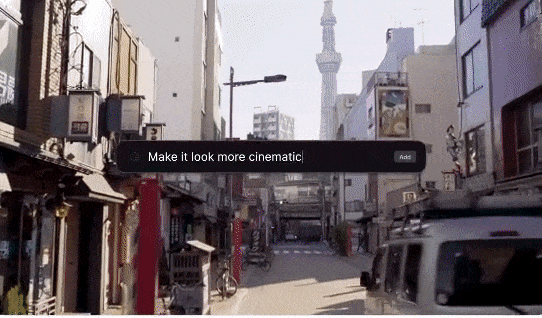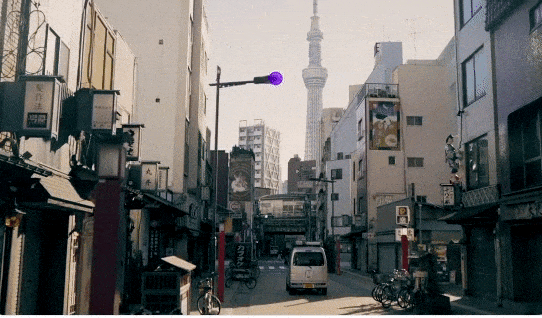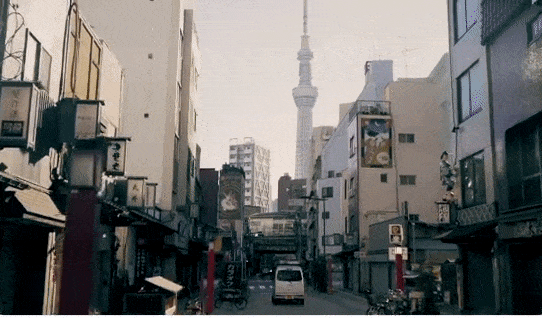
虽然任何人都可以在图像上测试全新的 Erase and Replace,但视频版本尚未公开。 来源: https://twitter.com/runwayml/status/1568220303808991232
尽管 Runway ML 尚未公布 Erase and Replace 背后的技术细节,但其将室内植物替换为相当逼真的罗纳德·里根胸像的速度,表明该功能可能基于类似 Stable Diffusion(或更不可能的授权版 DALL‑E 2)的扩散模型来重新生成所选对象。

将室内植物换成“吉普”胸像的速度虽不及此图快,但已相当迅速。 来源: https://app.runwayml.com/
该系统存在类似 DALL‑E 2 的限制——如果图像或文字触发 Erase and Replace 过滤器,系统会发出可能因进一步违规而导致账号被暂停的警告——这基本上是 OpenAI 对 DALL‑E 2 所实施政策的模板化复制。
许多结果并未出现 Stable Diffusion 常见的粗糙边缘。Runway ML 是 Stable Diffusion 的投资者和 研究合作伙伴,他们可能已经训练出一款专有模型,其性能优于我们目前在使用的开源 1.4 检查点权重(与此同时,众多其他开发团队,无论是业余还是专业的,都在训练或微调 Stable Diffusion 模型)。
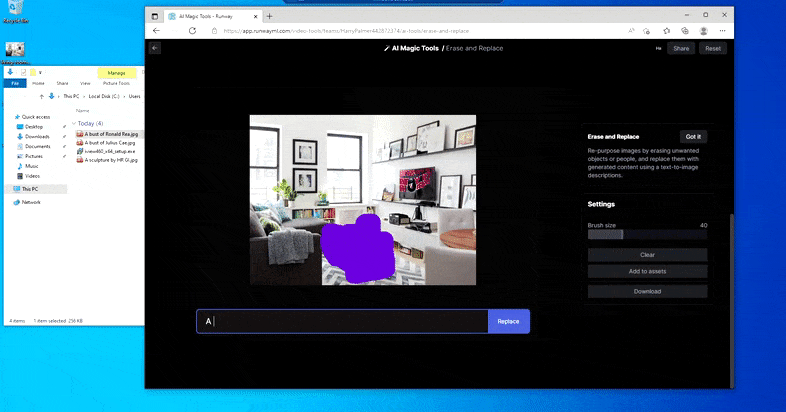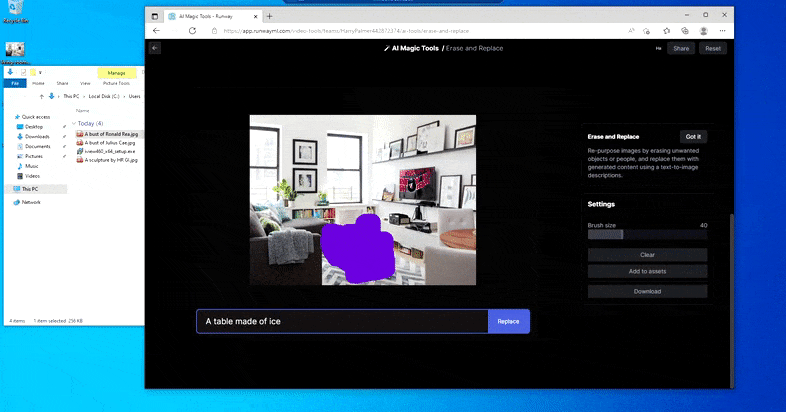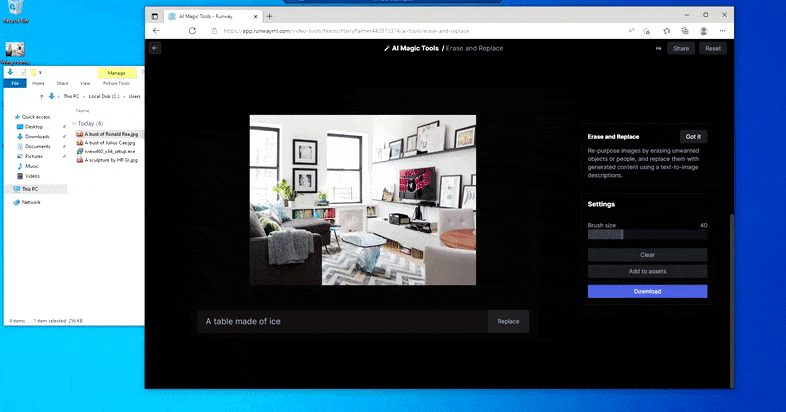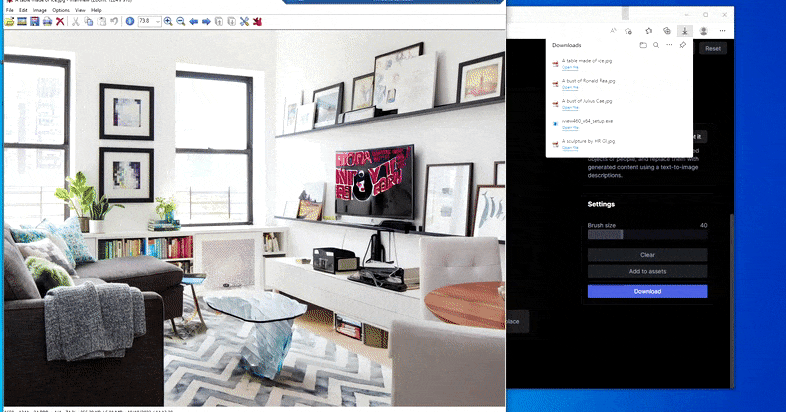
在 Runway ML 的 Erase and Replace 中,将普通餐桌替换为“冰制餐桌”。
和 Imagic(见下文)一样,Erase and Replace 本质上是“面向对象”的——你不能仅仅擦除画面中一个‘空白’区域并用文本提示的结果进行填充;在这种情况下,系统会沿掩码的视线追踪最近的可见对象(如墙壁或电视),并在其上执行转换。
正如名称所示,Erase and Replace 无法在空白处注入对象。此处尝试召唤最著名的西斯领主,结果在电视上出现了一幅奇怪的与维达相关的壁画,约在‘替换’区域绘制的位置。
目前尚难判断 Erase and Replace 是否在使用受版权保护的图像时采取回避策略(在 DALL‑E 2 中此类图像仍被大幅阻拦,尽管成功率不一),亦或是其后端渲染引擎所使用的模型本身并未针对这类情况进行优化。
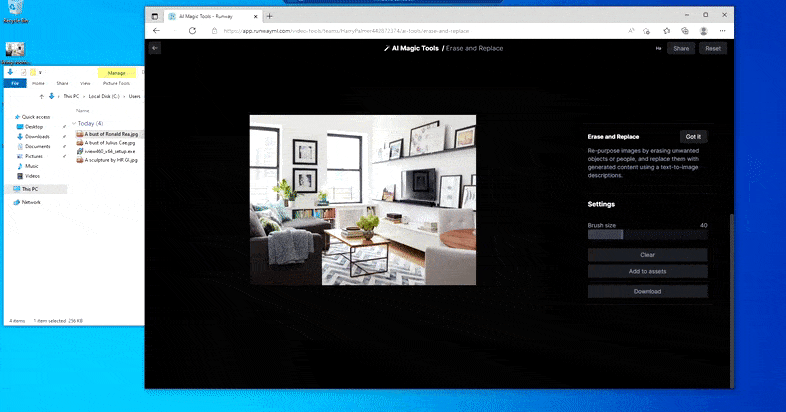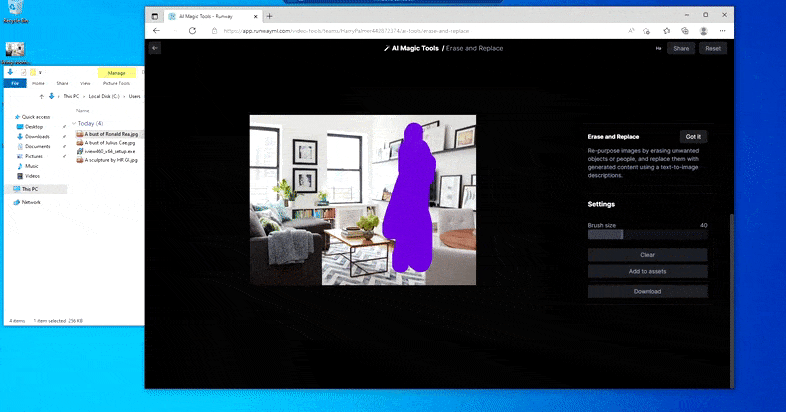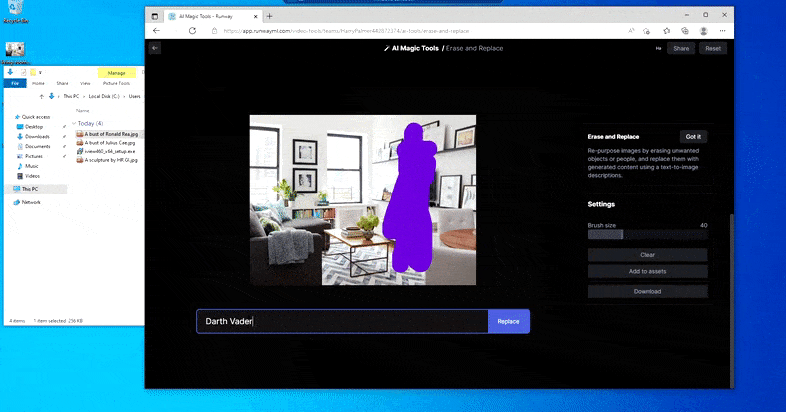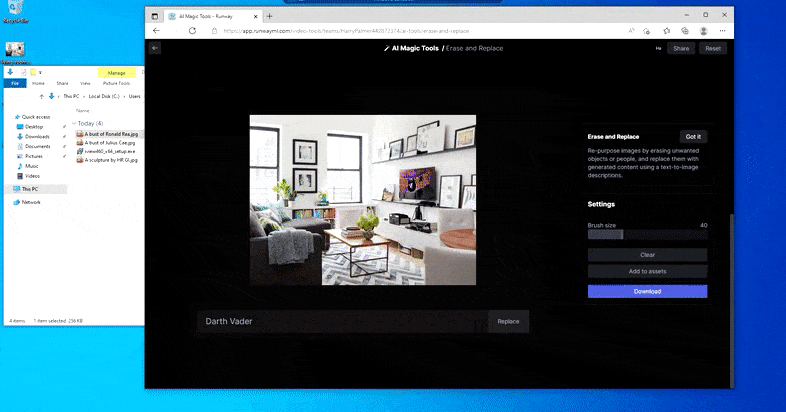
略带 NSFW 的 “妮可·基德曼壁画” 表明该(可能)基于扩散的模型缺乏 DALL‑E 2 过去对真实人脸或露骨内容的系统性拒绝,而对受版权保护作品的尝试结果从模糊(“异形”)到荒诞(“铁王座”)不等。右下角为来源图片。
了解 Erase and Replace 用何种方法来分离可替换对象将颇具意义。推测该图像会经过某种 CLIP 的变体处理,利用目标识别和随后语义分割来辨别离散的对象。上述操作在普通的 Stable Diffusion 部署中远未达到同等效果。
然而没有系统是完美的——有时系统似乎只擦除而未替换,即便(正如上图所示)底层渲染机制明确理解文本提示的含义。在这种情况下,想把咖啡桌变成异形几乎是不可能的——桌子会直接消失。
更恐怖的“找瓦尔多”版本,因为 Erase and Replace 未能生成外星人。
Erase and Replace 看似是一套高效的对象替换系统,具备出色的修补能力。然而,它只能替换而非编辑已存在的对象。要在不破坏环境材质的前提下真正修改图像内容,是一项更为艰巨的任务,涉及计算机视觉研究领域长期致力于在各流行框架的潜在空间中实现 可分离性 的挑战。
Imagic
这正是 Imagic 所要解决的任务。该 新论文 展示了大量编辑示例,能够成功修改照片的单个细节,而保持其余部分不受影响。
在 Imagic 中,修改后的图像不会出现深度伪造式的拉伸、扭曲和“遮挡猜测”等特征,这些通常源于仅凭单张图像的有限先验。
该系统采用三阶段流程——文本嵌入优化、模型微调以及最终生成修改后的图像。

Imagic 将目标文本提示编码为初始文本嵌入,然后优化该结果以获得输入图像。随后,对生成模型进行针对源图像的微调,加入一系列参数,最后进行所请求的插值。
不足为奇的是,该框架基于 Google 的 Imagen 文本到视频架构,尽管研究人员指出其原理可广泛适用于潜在扩散模型。
Imagen 采用三层架构,而非公司最近的 文本到视频迭代 所使用的七层结构。这三个独立模块包括:在 64×64 像素分辨率下运行的生成式扩散模型;将输出放大至 256×256 像素的超分辨率模型;以及进一步将输出提升至 1024×1024 像素的第二个超分辨率模型。
Imagic 在该流程的最早阶段介入,在 64 像素阶段使用 Adam 优化器、固定学习率 0.0001 对请求的文本嵌入进行优化。
可视化可分离性的典范:那些曾尝试在扩散、GAN 或 NeRF 模型中仅更改渲染对象颜色的终端用户,都能体会到 Imagic 在不“撕裂”图像整体一致性的前提下完成此类变换的意义。
随后在 Imagen 的基础模型上进行微调,每张输入图像进行 1500 步,条件为修订后的嵌入。同时,第二层 64px→256px 在同一条件图像上并行优化。研究人员指出,对最终的 256px→1024px 层进行类似优化对结果“几乎没有影响”,因此未实现该步骤。
论文称,在双 TPUV4 芯片上,每张图像的优化过程约需八分钟。最终渲染在核心 Imagen 中使用 DDIM 采样方案 完成。
与 Google 的 DreamBooth 类似的微调过程相同,生成的嵌入还可用于风格化以及包含 Imagen 底层数据库更广泛信息的写实编辑(正如下表第一列所示,源图像本身并不具备实现这些转换所需的内容)。
通过 Imagic 可实现灵活的写实运动与编辑,同时在此过程中得到的可分离代码同样可用于风格化输出。
研究人员将 Imagic 与此前的工作进行比较:SDEdit(2021 年由斯坦福大学与卡内基梅隆大学合作的基于 GAN 的方法)以及 Text2Live(2022 年四月由魏茨曼科学研究所与 NVIDIA 合作的项目)。
Imagic、SDEdit 与 Text2Live 的视觉对比。
显而易见,前述方法仍在挣扎;尤其在底部那一行涉及大幅姿态变换时,竞争方案完全未能重新构造源素材,而 Imagic 则取得了显著成功。
虽然相较于此类研究的标准,Imagic 对资源的需求和每张图像的训练时间已算短,但其仍不太可能被纳入个人电脑的本地图像编辑应用中——且尚不清楚微调过程能在多大程度上缩减至普通消费者可接受的水平。
就目前而言,Imagic 是一项令人印象深刻的产品,更适合作为 API 使用——在此环境中,Google Research 对于助长深度伪造的批评持谨慎态度,或许更为舒适。
首次发布于 2022 年 10 月 18 日。


