
Anderson 视角
一种机器学习系统,可以在您阅读文章时重写文章

 将 Unite.AI 添加到您在 Google 上的首选来源
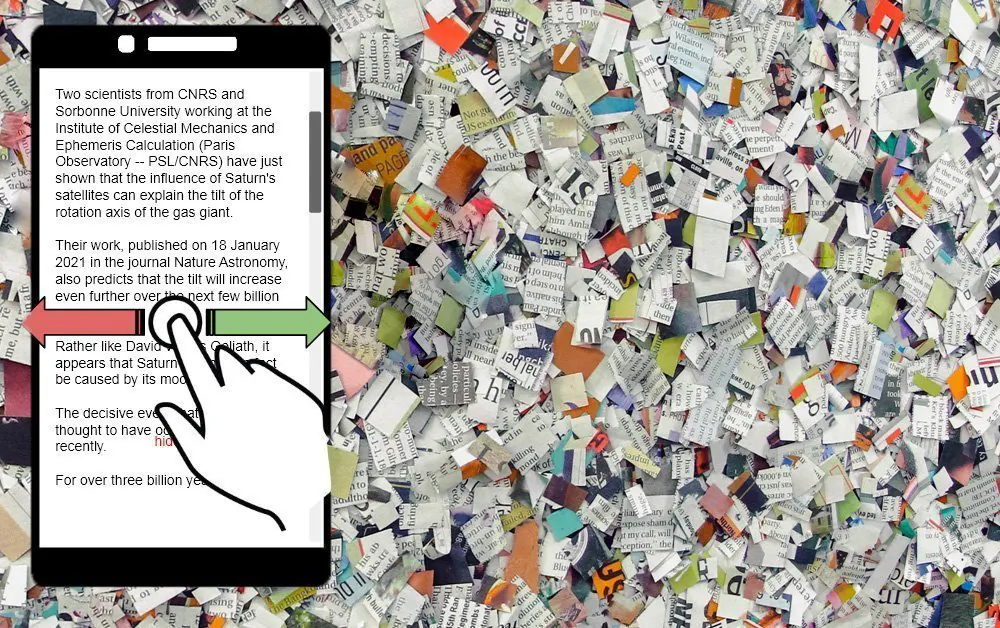
加拿大最新研究提出了一种方法,可以根据Tinder风格的“滑动”或对读者与文章内容交互的被动观察,自动重写文章。
该系统被称为Hone As You Read(HARE),在加拿大安大略省西部大学的一篇论文中被提出,相关的Python代码可以在GitHub上找到。
该项目的核心思想是,文章可能包含各种类型的内容,从标题到更详细的信息。文章的后部分可能包含不同类型的支持材料、用例或关于新闻影响的假设或推测。
在HARE系统中,如果您不喜欢这种材料,可以在段落级别上投票将其删除,而系统会学习您的偏好,因此,当您滚动到下一部分时,类似的内容已经被删除或重写。如果您不想积极参与训练系统,HARE可以通过观察您与文档的被动交互来推断您的选择。
Tinder风格的不满句子投票
在下面的图像中,我们看到HARE基于用户的显式或隐式行为的三种可能的分类。第一种情况(左),用户主动“向左滑动”(或向右),以Tinder风格的投票手势表达对段落或句子的内容、风格、复杂性或语气的赞同或不满。
第二种情况(中),系统使用停留时间作为用户兴趣的指标,基于滚动暂停的位置和持续时间。
第三种情况(右),HARE使用智能手机摄像头来估计查看者在可见文档段落上的凝视路径和停留时间。
研究人员认为,任何一段停留时间的增加都可能表明用户的兴趣增加,尽管在试图理解可能复杂或写得不好的文本时,这可能并不总是如此。
根据用户偏好预处理内容
该论文讨论了HARE在每篇文章中的用户体验,但很明显,用户与文档的历史交互可以让未来的阅读体验得到定制,通过一致地识别内容类型并将模板化的用户偏好应用于新文章,因此,随着用户看到越来越少的“不想要”的内容,交互的需求就会减少。
HARE被描述为一个总结算法,允许在用户到达之前,以风格或简洁性重写未见的内容;但该论文明确指出,它也可以预先删除内容基于用户反馈。
为了测试目的,系统使用了来自英国《每日邮报》报纸的11,222篇文章的语料库,并通过在Telegram聊天应用程序上的测试部署进行了评估。少于十段的文章被丢弃以进行试验。
研究人员的方法使用了K-Means聚类在文章中的SBERT句子嵌入中,最初具有随机权重的概念。
在广泛的算法和方法中,HARE具有三个比较模型,第一个模型(ORACLEGREEDY)可以访问先前的用户偏好,表明算法可以在加载时预处理文章,而不是交互式地进行。
其他模型,ORACLESORTED和ORACLEUNIFORM,分别根据兴趣水平或在整个文章中随机选择句子。
内容删除和重写
令人惊讶的是,ORACLEUNIFORM在控制集上表现更好,尽管它没有访问先前的用户兴趣。研究人员认为,这是因为它一次性处理整个文章,仅选择“最有趣的句子”。研究人员承认,这可能会限制可用的内容仅限于处理最重要概念的句子,逻辑上删除其他可能处理概念影响或评估的文本。
HARE中使用的提取式总结器有LexRank、SumBasic和TextRank。
HARE在13名志愿者和70次试验中进行了测试,采用了不同的算法方法,并能够在消费级笔记本电脑上以1.3毫秒至100毫秒的速度更新摘要(重写/删除的文本),具体取决于正在试验的模型。结果表明,删除最多文本的模型表现不佳,主要是因为这会影响剩余文本的连贯性。
动态文章重写的伦理影响
研究人员承认,这类技术存在伦理问题:
“HARE任务旨在设计面向用户的未来应用。按照设计,这些应用程序可以控制用户从给定文章中阅读的内容。可能当这些工具在没有足够谨慎的情况下部署时,它们会加剧已经由自动新闻源、搜索结果和在线社区产生的“回音室”效应。”
然而,他们也指出,这样的系统可以在未来应用中用于减轻回音室效应,通过注入可能最初不在文章中的替代观点。他们观察到:“这种因素的权重可以调整,以提供引人入胜的阅读体验和多样化的想法。”
研究人员认为,可能从这样的系统中受益的读者是那些希望在获取信息时节省时间的读者和内容发布者。


