
Основи ШІ
Що таке глибоке підкріплювальне навчання?

 Додайте Unite.AI до бажаних джерел у Google
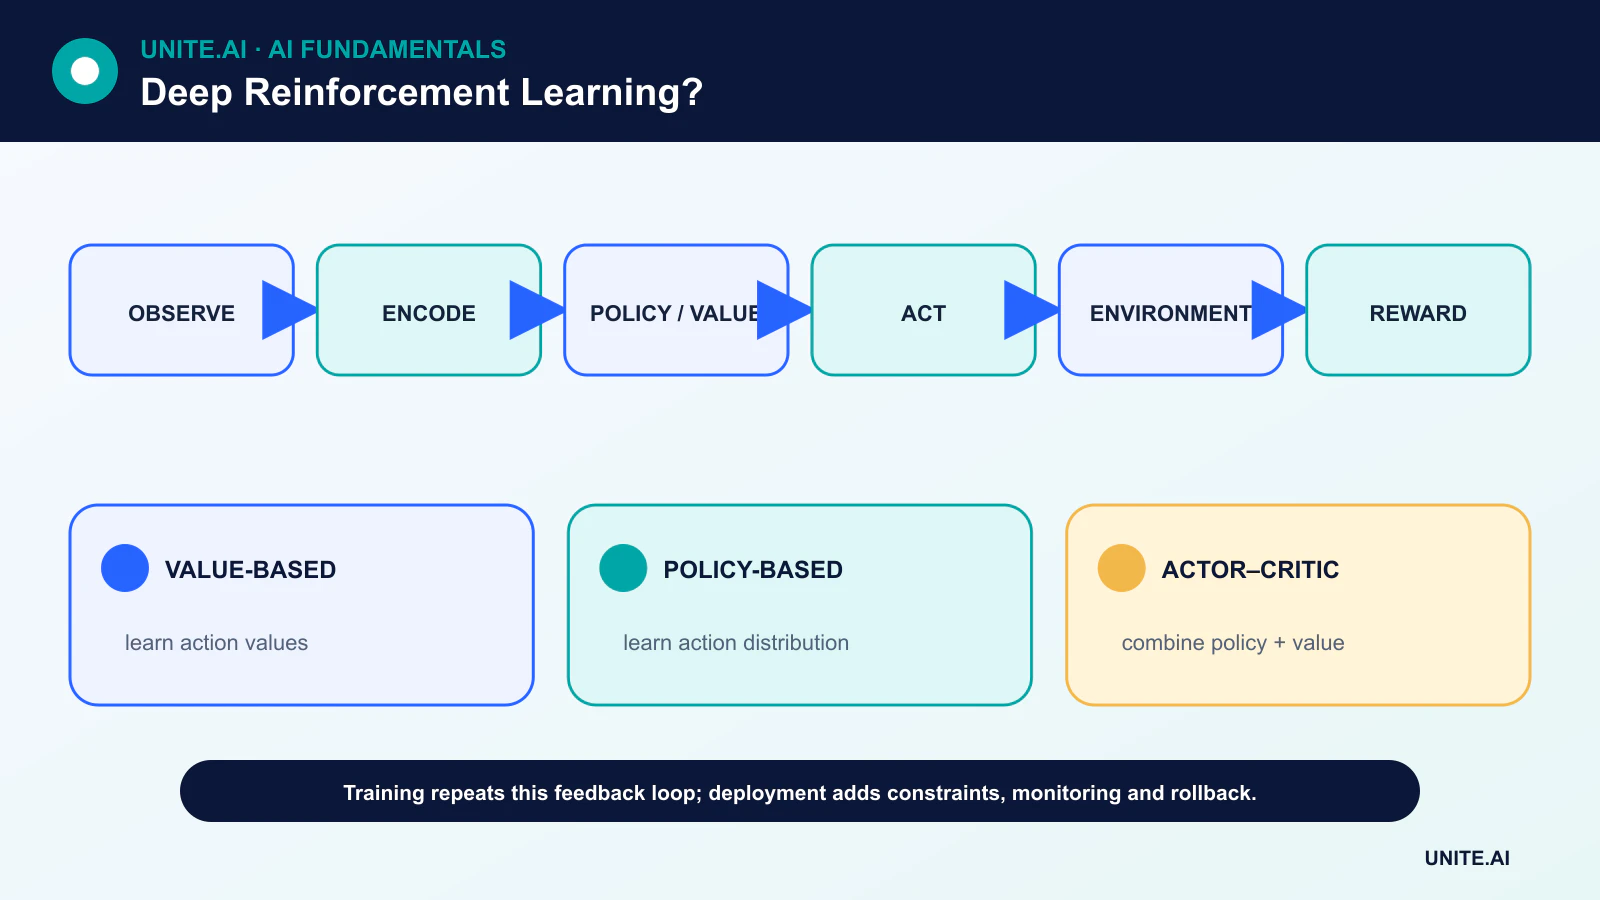
Глибоке підкріплювальне навчання (deep RL) поєднує підкріплювальне навчання з глибокими нейронними мережами. Агент спостерігає стан, обирає дію, отримує нагороду та нове спостереження, після чого коригує політику або функцію цінності, щоб покращити майбутні рішення.
Глибока мережа не усуває складні аспекти підкріплювального навчання. Вона забезпечує гнучке представлення зображень, потоків датчиків, великих просторів дій або складних функцій цінності. Дослідження, затримка кредиту, нестабільне навчання та безпечна оцінка у реальному світі залишаються ключовими інженерними проблемами.
Ключові висновки
- Deep RL навчає послідовні рішення через взаємодію, а не з фіксованої таблиці позначених прикладів.
- Методи, засновані на значеннях, оцінюють, наскільки хороші дії; політичні методи безпосередньо навчаються розподілу дій; методи актор‑критик поєднують обидва підходи.
- Буфери повторного відтворення, цільові мережі та ретельний дизайн нагород можуть покращити навчання, але жоден з них не гарантує надійної поведінки.
- Високий результат у симуляторі не є доказом стійкості, безпеки чи успішного перенесення у фізичний світ.
Проблема прийняття рішень: стани, дії та нагороди
Багато завдань deep‑RL моделюються як марковський процес прийняття рішень. У момент часу t агент отримує стан або спостереження st, обирає дію at, після чого отримує нагороду rt+1 та наступний стан. Метою є очікуване дисконтоване повернення, а не лише наступна нагорода.
Коефіцієнт дисконту визначає, наскільки важливими є віддалені нагороди. Функція нагород визначає, чого буде прагнути процес оптимізації, тому неповний проксі може породжувати поведінку, технічно успішну, але операційно небажану. Це одна з причин, чому дизайн нагород і тестування обмежень потребують такої ж уваги, як і архітектура моделі.
Методи, засновані на значеннях, політиці та актор‑критик
Алгоритм, заснований на значеннях, оцінює вартість стану або дії. Deep Q‑мережі використовують нейронну мережу для апроксимації Q‑значень і зазвичай обирають дію з найвищою оцінкою, зберігаючи певний рівень дослідження. Алгоритм градієнту політики натомість оптимізує параметризовану політику, що генерує розподіл дій.
Системи актор‑критик підтримують як актор, який пропонує дії, так і критик, який оцінює їхню вартість. Така архітектура підтримує безперервне управління, але вводить взаємодіючі джерела помилок оцінки. Тому Deep RL спирається на ті ж самі фундаментальні принципи, що й глибоке навчання, градієнтний спуск та зворотне поширення.
Чому буфери повторного відтворення та цільові мережі допомагають
Послідовні зразки досвіду корельовані, а оновлення мережі змінює цілі, що використовуються в наступних оновленнях. Повторне відтворення досвіду розриває частину цієї часової кореляції, вибираючи старі переходи. Цільова мережа змінюється повільніше, ніж онлайн‑мережа, що робить бутстреп‑цілі менш мінливими.
Ці механізми підвищують стабільність навчання, проте налаштування залишаються важливими. Швидкість навчання, графік дослідження, масштаб нагород, склад реплею та пропускна здатність мережі можуть впливати на результат. Потрібно повідомляти кілька випадкових ініціалізацій, оскільки один запуск може вводити в оману.
Офлайн‑RL, модель‑базований RL та сим‑до‑реального
Офлайн‑RL навчається на фіксованому записаному наборі даних без збору нових взаємодій. Це корисно, коли дослідження дорогі або небезпечні, проте політика має уникати дій, які погано представлені в журналі. Модель‑базований RL навчає або використовує модель переходу для планування, обмінюючи додаткові припущення на ефективність використання зразків.
У робототехніці часто навчаються у симуляції, випадково змінюючи фізичні параметри, а потім тонко налаштовують або верифікують на апаратурі. Проміжок між симуляцією та реальністю може виявити помилки у сприйманні, таймінгу, динаміці контакту та не змодельованих крайових випадках. Система підкріплювального навчання повинна оцінюватися під впливом збурень, зсуву розподілу та явних обмежень безпеки.
Оцінка та впровадження
Корисна оцінка розділяє навчальне та тестове середовище, повідомляє розподіли повернень, а не лише найкращий результат, та перевіряє порушення обмежень, частоту втручань і поведінку у найгіршому випадку. Для реальних систем команди також потребують моніторингу, процедур відкату, обмежених просторів дій та можливості людського втручання.
Deep RL є найпривабливішим, коли рішення послідовні, доступний зворотний зв’язок і ручні правила керування недостатні. Це поганий вибір за замовчуванням, коли є багато мічених даних, звичайний оптимізатор вирішує задачу або дослідження створює ризик для людей чи активів.
Архітектури Deep RL та сигнали навчання
Глибоке підкріплювальне навчання використовує нейронні мережі для представлення функції цінності, політики, моделі середовища або їх комбінації. Deep Q‑мережа передбачає значення дій і навчається на цільових значеннях тимчасової різниці; повторне відтворення досвіду зменшує кореляцію між оновленнями, а цільова мережа стабілізує змінну мету. Методи градієнту політики безпосередньо оптимізують очікуване повернення, а методи актор‑критик використовують навченого критика для зниження дисперсії градієнта. Безперервні дії часто вимагають детерміністичних або стохастичних варіантів актор‑критик, тоді як дискретні високовимірні дії потребують ретельного дослідження та дизайну виходу.
Навчання є нестабільним, оскільки політика змінює дані, які вона збирає. Дані реплею стають поза‑політикою, бутстреп‑цілі залежать від поточних оцінок, а апроксимація функції може посилювати помилки — комбінація, яку іноді називають смертельною тріадою. Подвійні оцінювачі зменшують переоцінку цінності; функції переваги покращують розподіл кредиту; бонуси ентропії стимулюють дослідження; обрізані цілі обмежують руйнівні оновлення політики. Нормалізуйте спостереження та нагороди лише за безпечного стану, і реєструйте середовище, обгортку, повторення дії, завершення та передобробку нагород, оскільки кожен з цих факторів змінює задачу.
Оцінка, симулятори та безпека впровадження
Повідомляйте розподіли повернень за незалежними ініціалізаціями та інстанціями середовища, а не лише найкращий запуск. Оцінюйте ефективність використання зразків, порушення обмежень, катастрофічні наслідки, чутливість до масштабу нагород та стійкість до шуму спостережень, затримки, помилок виконавчих механізмів і зміненої динаміки. Порівнюйте зі скриптовим керуванням, класичним керуванням, підкріплювальним імітуванням та простішими RL‑методами. Відокремлюйте варіації середовища та тестуйте метрики без нагород, оскільки агент може експлуатувати запрограмовану нагороду, не виконуючи поставлене завдання. Перегляд відео та траєкторій часто виявляє поведінку, приховану у сукупному поверненні.
Симуляція дозволяє дослідження, але створює розрив між реальністю та моделлю. Випадково варіюйте релевантну фізику та сприйняття, калібруйте за реальними вимірюваннями та використовуйте консервативний перенос. Записані дані або офлайн‑RL уникають онлайн‑досліджень, проте не можуть надійно оцінювати дії, які не підтримуються політикою поведінки. Виробничі системи мають обмежувати набір дій, їх швидкість, ресурси та діапазон роботи; вимагати затвердження для дій з великим впливом; і включати перевірений безпечний контролер або зупинку. Моніторьте вхідні дані політики, розподіл дій, нагороду, реальні результати та втручання, з можливістю відкату до протестованої версії політики.
Конкретний приклад управління
Для маршрутизації роботів на складі визначте стан за місцезнаходженням, навантаженням, зарядом батареї, близьким трафіком та чергою завдань; дії — за дозволеними переміщеннями та рішеннями про заряджання; нагороду — за виконану роботу, енергію, затори та обмеження безпеки. Спочатку навчайте у каліброваній симуляції з випадковим попитом та збоями датчиків, потім тіньовим режимом застосовуйте до реальних рішень. Ніколи не дозволяйте навченій політиці обходити уникнення зіткнень. Оцінюйте пропускну здатність разом із майже‑промахами, блокуваннями, аварійними ситуаціями з батареєю та найгіршими затримками. Проект успішний лише тоді, коли багаторівнева система покращує операції, не передаючи неприпустимий ризик дослідження людям або обладнанню.
Практичний приклад: DRL для охолодження дата‑центру
Дата‑центр обмежує агента RL затвердженими точками охолодження та навчає його у симуляторі, каліброваному за історичними даними про погоду, навантаження, температури та реакцію обладнання. Нагорода включає енергію, проте жорсткі обмеження окремо захищають температуру, вологість та цикл роботи обладнання. Модель‑прогнозне керування та існуючі правила слугують базовими лініями. Оцінка охоплює пори року, шум датчиків, затримку виконавчого механізму, втрату обладнання, незвичні навантаження та кілька ініціалізацій, повідомляючи про енергію, порушення, дисперсію та відновлення.
Навчена політика працює у тіньовому режимі перед випробуванням у обмеженій зоні. Зовнішній безпечний контролер обрізає дії, а оператори можуть втручатися. Швидкість дій, охоплення станів, невизначеність моделі та реальні результати об’єкта моніторяться; невідповідність симулятора або повторні втручання викликають відкат. Оновлене обладнання або логіка керування створюють нову версію середовища та верифікацію. Заощадження енергії приймаються лише тоді, коли надійність, тепловий резерв, технічне обслуговування та реакція на збої залишаються принаймні такими ж сильними, як у базовій лінії.
Докази впровадження та готовність до експлуатації
Виробниче рішення потребує більше, ніж успішна демонстрація. Визначте цільових користувачів, робоче середовище, вхідні та вихідні дані, залежності, власника та наслідки кожної важливої несправності. Встановіть відтворювану базову лінію та версійну оцінювальну вибірку перед налаштуванням. Тестуйте звичайні випадки, граничні умови, некоректні або відсутні дані, зсув розподілу, відмову залежностей, неправильне використання та групи або середовища, які, ймовірно, залишаться без належної підтримки. Вимірюйте якість завдання разом з калібруванням або невизначеністю, затримкою, пропускною здатністю, витратами ресурсів, доступністю, конфіденційністю та безпекою. Записуйте кожне перетворення та поріг, щоб незалежний рецензент міг відтворити результат і розрізнити докази від привабливого прототипу.
Перед запуском призначте відповідальність за випуск, винятки, зміни, відкат та виведення з експлуатації. Використовуйте поетапний розгортання, зберігайте безпечний резерв і перевіряйте моніторинг за допомогою навмисно введених збоїв. Операційна телеметрія має виявляти якість вхідних даних, поведінку вихідних результатів, версію моделі або правила, стан залежностей, людські втручання та підтверджені результати без збору непотрібних конфіденційних даних. Визначте пороги сповіщень та відповідального за реакцію, а потім перегляньте реальні докази після впровадження, а не припускайте, що офлайн‑продуктивність залишиться незмінною. Переоцінюйте щоразу, коли змінюються джерела даних, користувачі, моделі, постачальники, політики, апаратне забезпечення або цілі. Підтримувана система також потребує задокументованих процедур відновлення, навчання на інцидентах, видалення та зберігання, а також чіткої точки, в якій її слід вимкнути або замінити.
Часті запитання
Чи є глибоке підкріплювальне навчання тим же, що й глибоке навчання?
Ні. Глибоке навчання надає функціональні апроксиматори; підкріплювальне навчання забезпечує взаємодію, нагороду та ціль послідовних рішень.
Чи означає висока нагорода, що агент навчився бажаній поведінці?
Не обов’язково. Це означає, що політика знайшла поведінку, яка добре оцінюється за заданою нагородою та у середовищі. Однак все ще потрібні незалежні тести безпеки та відповідності цілям.
Основні джерела












