Основи ШІ
Що таке Data Science?

 Додайте Unite.AI до бажаних джерел у Google
Data science — це практика перетворення даних у обґрунтовані знання, прогнози або рішення. Вона поєднує експертизу предметної області, статистику, обчислення, інженерію даних, візуалізацію та комунікацію. Модель може бути частиною роботи, але дисципліна починається ще до моделювання і продовжується після розгортання.
Найважливіше питання — не «Який алгоритм слід використати?». Воно звучить: «Яке рішення ми підтримуємо, які докази дадуть відповідь, і як ми дізнаємося, що результат залишається корисним?»
Ключові висновки
- Data science — це сквозний процес роботи з доказами, а не синонім машинного навчання.
- Визначення проблеми, вимірювання та управління даними часто визначають успіх більше, ніж складність моделі.
- Прогностичні та причинно‑наслідкові питання вимагають різних припущень та дизайну оцінки.
- Розгорнутий аналіз потребує моніторингу, документації та комунікації, відповідних його користувачам.
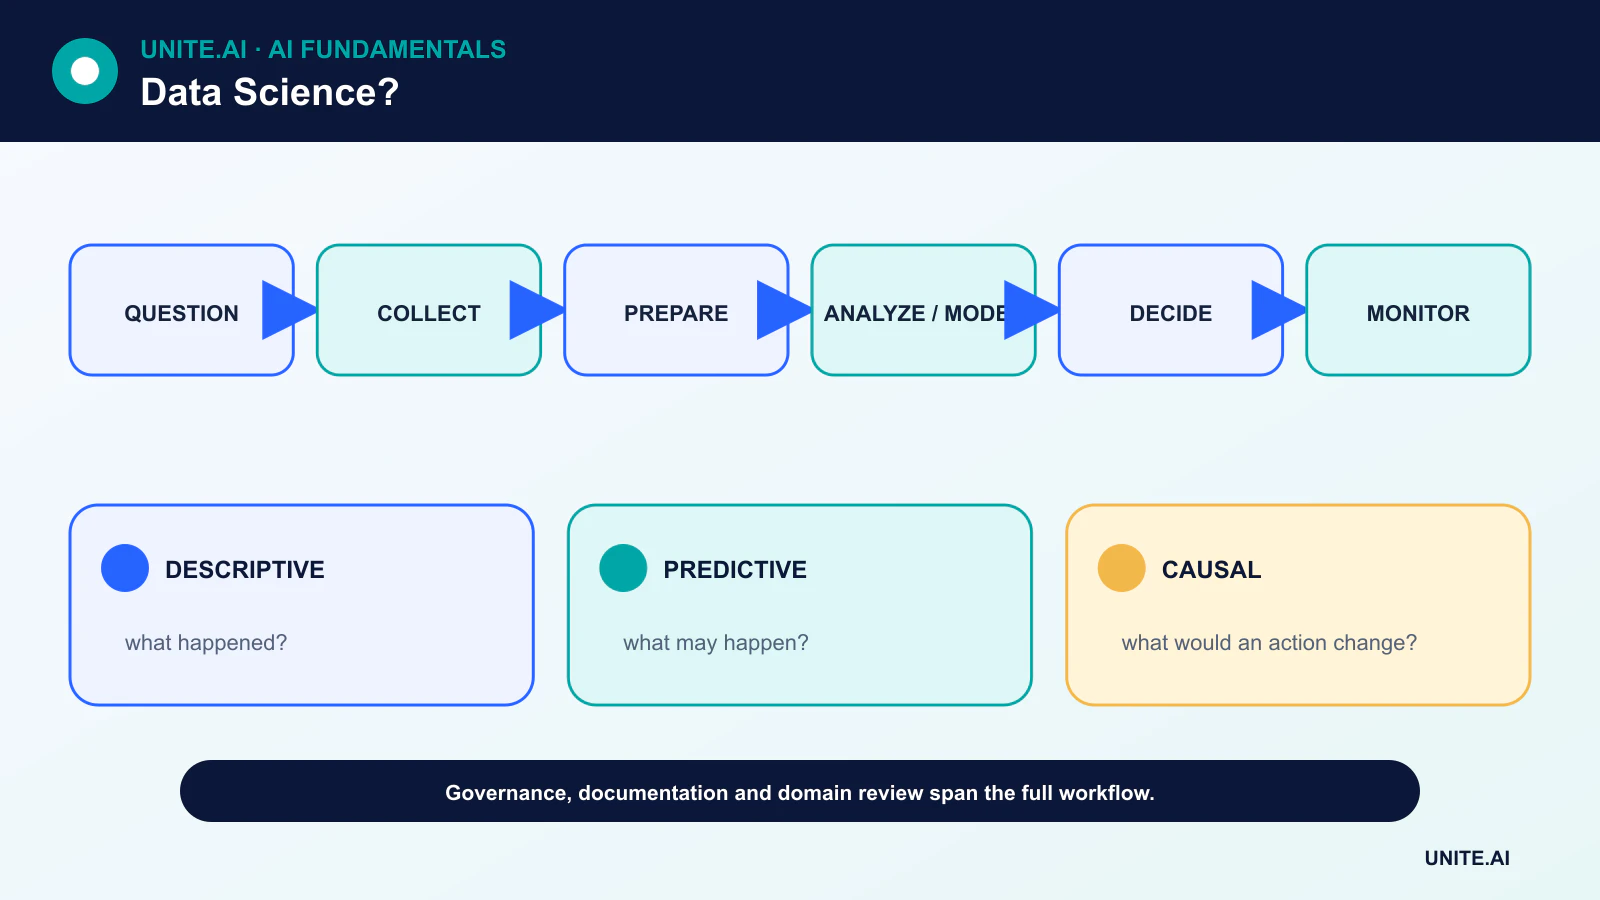
Почніть з рішення та оцінюваного параметра
Проєкт має визначити користувача, рішення, втручання та вартість помилки. Для описового питання ціль може бути показником або тенденцією. Для прогнозування це може бути майбутній попит або ризик. Для причинного питання оцінюваний параметр описує ефект визначеного втручання за заданих припущень.
Неясні цілі типу «знайти інсайти» унеможливлюють оцінку. Вимірювана мета створює межу для збору даних і запобігає розширенню аналізу на усі доступні поля.
Збирайте, керуйте та розумійте дані
Команди інвентаризують джерела, власність, згоду, збереження, походження та доступ. Вони розрізняють структуровані та неструктуровані дані, визначають одиниці та часові мітки і перевіряють, чи представляють записи населення та період, що цікавить.
Очищення — це не лише видалення рядків з пропущеними значеннями. Воно включає усунення дублікатів, неможливих значень, неоднозначності міток, зсуву схеми, цензурування та об’єднання, які змінюють одиницю аналізу. Кожне перетворення має бути відтворюваним і задокументованим.
Досліджуйте перед моделюванням
Експлоривний аналіз вивчає розподіли, пропуски, взаємозв’язки та потенційні артефакти вимірювань. Візуалізація може виявити викиди та відмінності підгруп, які приховує середнє значення. Дослідження має інформувати гіпотези, не будучи сприйнятим як підтверджувальний доказ.
Інженерія ознак, зниження розмірності та навчання представлень можуть покращити моделювання, але перетворення мають підбиратися лише на навчальних даних, щоб уникнути витоку.
Обирайте методи відповідно до питання
Статистичне оцінювання кількісно визначає невизначеність навколо цікавих величин. Машинне навчання корисне, коли головна мета — прогностична точність на нових даних. Експерименти та методи причинно‑наслідкового висновку потрібні, коли мета — оцінити ефект втручання.
Базова модель має бути достатньо простою для розуміння. Більш складні моделі повинні виправдати додаткові витрати кращою продуктивністю на відкладених даних, каліброваною невизначеністю, операційною цінністю або необхідною можливістю, такою як обробка зображень чи мови.
Оцінюйте, комунікуйте та моніторте
Оцінка має відповідати рішенню. Класифікатор може вимагати точність, повноту, калібрування та аналіз підгруп, а не лише точність; система прогнозування потребує часово‑усвідомленого бек‑тестингу. Перепідгонка та витік — це помилки процесу, а не лише властивості моделі.
Комунікація включає припущення, невизначеність, обмеження та рекомендовані дії. Після використання моделі або панелі інструментів команди моніторять якість вхідних даних, зсув результатів, поведінку користувачів та downstream‑вплив. Відкладений процес прийняття рішень потребує архіву та чіткого власника, так само як розгорнутий потребує оператора.
Життєвий цикл Data Science та аналітичні питання
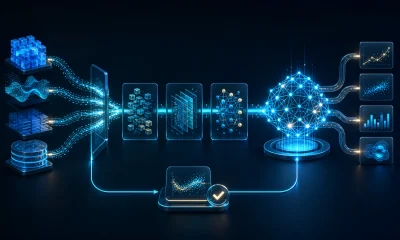
Data science поєднує предметні знання, статистику, обчислення та комунікацію, щоб перетворити дані на докази для рішень. Почніть з розрізнення опису, діагностики, прогнозування та причинного висновку. Панель, що повідомляє, що сталося, модель, що прогнозує, хто відмовиться, і експеримент, що оцінює, чи змінює втручання відток, відповідають різним питанням. Визначте одиницю, населення, часове вікно, результат, дію та вартість помилок перед витягом даних. Багато провальних проєктів вирішують вимірюваний проксі, який не може підтримати заплановане рішення.
Отримання даних потребує походження, дозволів, дизайну вибірки та контракту даних. Дослідження перевіряє розподіли, пропуски, дублікати, викиди, взаємозв’язки, зміни вимірювань та потенційний витік. Вибір методів очищення — це аналітичні припущення: видалення рядків з пропущеними даними, імпутація значень або обмеження викидів можуть змінити населення та висновок. Версіонуйте сирі дані незмінно та перетворення у вигляді коду, створіть словник даних з одиницями та значенням. Розділіть дані для оцінки до навчання перетворень або повторного тестування гіпотез.
Моделювання, інференція та відтворюваність
Статистична інференція кількісно визначає невизначеність за припущень; прогностичне моделювання оцінює продуктивність поза вибіркою; причинний аналіз вимагає ідентифікації через дизайн або обґрунтовані припущення. Обирайте методи, що відповідають питанню та процесу генерації даних. Порівнюйте зі простими базовими моделями, використовуйте групову або часово‑усвідомлену валідацію та повідомляйте про невизначеність і чутливість. Висока кореляція або важливість ознаки не встановлює причинність. Множинне тестування, свобода дослідника та селективна подача результатів можуть створювати переконливі патерни, тому передреєстрація або чітко розділений підтверджувальний етап можуть допомогти.
Відтворюваність включає код, середовище, знімок даних, випадкові зерна, визначення запитів та запис ручних рішень. Автоматизовані тести мають охоплювати схеми, бізнес‑інваріанти, перетворення та метрики. Ноутбуки корисні для досліджень, але виробнича робота потребує модульних, перевіряних конвеєрів. Пір‑рев’ю має кидати виклик припущенням, витоку, валідності цілі та узагальнюваності результатів. Комунікуйте розміри ефекту, невизначеність, обмеження та контр‑докази, а не лише статистичну значимість чи оцінку моделі.
Розгортання та вплив рішення
Якщо аналіз керує повторюваним процесом, призначте власників, моніторьте актуальність даних та якість результатів, а також визначте відкат або завершення. Захищайте персональну та конфіденційну інформацію шляхом мінімізації, контролю доступу, збереження та безпечних результатів. Оцінюйте ефекти підгруп та реакцію користувачів на модель; зворотні зв’язки можуть змінити майбутні дані. Вимірюйте, чи рішення покращило реальну мету, а не лише чи модель була розгорнута. Data science успішна, коли докази надійно та прозоро змінюють дії — а не коли організація накопичує панелі, функції чи експерименти без власника.
Практичний приклад: вимірювання втручання для підвищення утримання
Команда продукту спостерігає зниження утримання та визначає активного користувача, когорту, вікно, виключення та рішення. Аналітики перевіряють інструментацію, пропущені події та мікс придбання перед моделюванням. Описові когорти виявляють, де відбувається спад, прогностична модель пріоритезує учасників дослідження, а рандомізований експеримент онбордингу оцінює, чи запропонована зміна підвищує утримання. Це три окремих аналізи з різними припущеннями та результатами.
Ноутбук, запити, знімок даних, визначення метрики та план експерименту версіонуються та проходять пір‑рев’ю. Результати повідомляють розмір ефекту та невизначеність з обмеженнями щодо попиту на підтримку та доступності. Панель моніторить експеримент, але не замінює попередньо оголошений аналіз. Якщо втручання успішне, розгортання залишається поетапним і перевіряє довгострокову поведінку. Робота вважається цінною лише тоді, коли вона підтримує відтворюване рішення, а не тому, що був створений складний модель або візуально привабливий графік.
Докази впровадження та готовність до експлуатації
Виробниче рішення потребує більше, ніж успішна демонстрація. Визначте цільових користувачів, операційне середовище, вхідні та вихідні дані, залежності, власника та наслідки кожної важливої помилки. Встановіть відтворювану базову лінію та версіонований набір для оцінки перед налаштуванням. Тестуйте звичайні випадки, граничні умови, некоректний або відсутній вхід, зсув розподілу, відмову залежностей, неправильне використання та групи чи середовища, які найчастіше залишаються без підтримки. Вимірюйте якість завдання разом з калібруванням або невизначеністю, затримкою, пропускною здатністю, вартістю ресурсів, доступністю, конфіденційністю та безпекою. Фіксуйте кожне перетворення та поріг, щоб незалежний рецензент міг відтворити результат і розрізнити докази від привабливого прототипу.
Перед запуском призначте повноваження для випуску, виключень, змін, відкату та завершення. Використовуйте поетапне розгортання, зберігайте безпечний резерв та перевіряйте моніторинг за допомогою навмисно введених збоїв. Операційна телеметрія має виявляти якість вхідних даних, поведінку виходів, версію моделі чи правила, стан залежностей, людські втручання та підтверджені результати без збору зайвих конфіденційних даних. Визначте пороги сповіщень та відповідального, а потім перегляньте реальні докази після розгортання, а не припускайте, що офлайн‑продуктивність залишиться. Переоцінюйте щоразу, коли змінюються джерела даних, користувачі, моделі, постачальники, політики, обладнання або цілі. Підтримувана система також потребує задокументованого відновлення, навчання на інцидентах, процедур видалення та збереження, а також чіткої точки, коли її слід вимкнути або замінити.
Часті питання
Чи є Data Science тим же, що і Data Analytics?
Терміни частково перекриваються. Data science часто включає створення продуктів даних та прогностичних систем, тоді як аналітика може більше зосереджуватись на описовій та діагностичній підтримці рішень. Використання в організаціях різниться.
Чи потребує кожен проєкт Data Science ШІ?
Ні. Добре спроектований запит, діаграма, експеримент або статистичний оцінок може бути кориснішим та більш надійним, ніж складна модель.
Основні джерела