Основи ШІ
Що таке сховище даних? Архітектура, ETL та випадки використання

 Додайте Unite.AI до бажаних джерел у Google
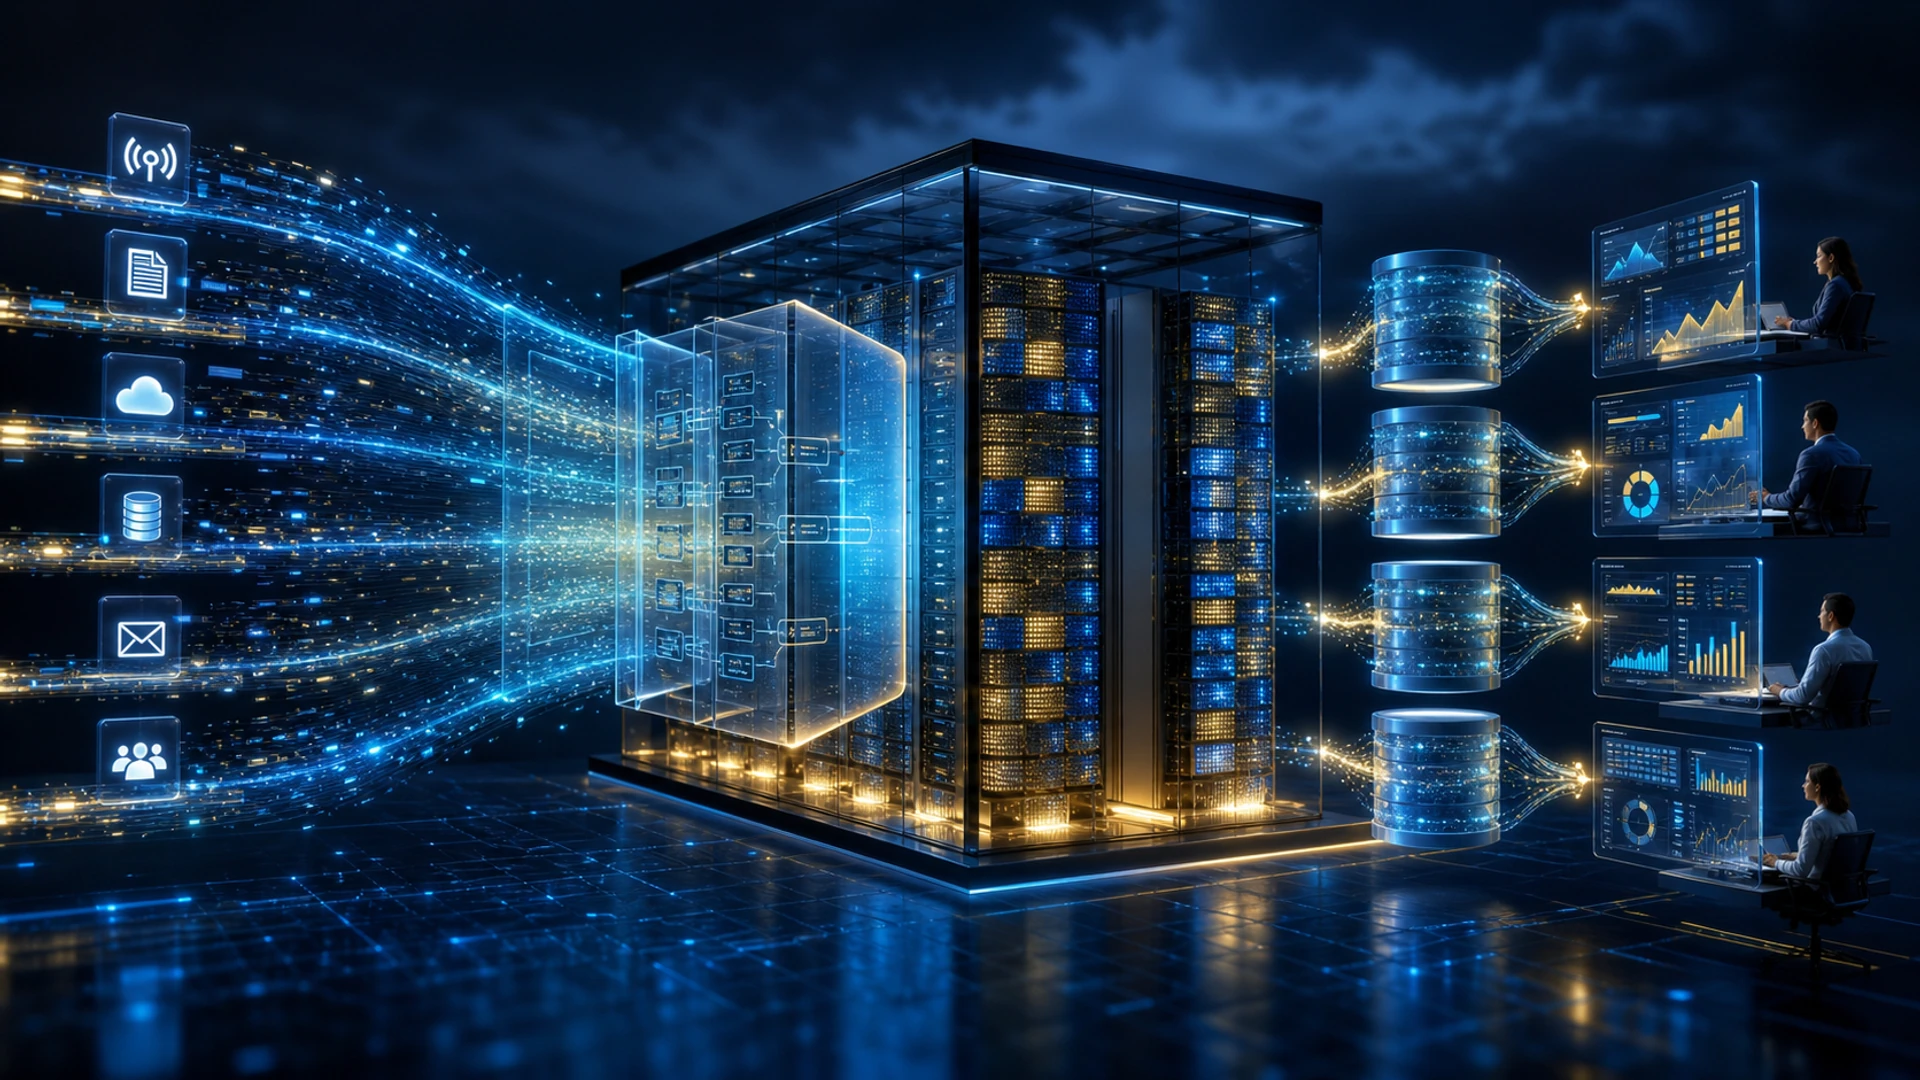
Сховище даних — це аналітична система даних, яка інтегрує інформацію з операційних джерел і організовує її для звітності, бізнес‑аналітики та повторюваного аналізу. Воно відокремлює багато аналітичних навантажень від додатків, які реєструють транзакції.
Сучасні сховища можуть бути колонковими, розподіленими, безсерверними або підключеними до об’єктного сховища. Основна робота залишається незмінною: кероване завантаження, змодельоване значення, історія, продуктивність запитів, безпека, якість та надійна доставка користувачам.
Основні висновки
- Операційні системи оптимізують поточні транзакції; сховища оптимізують історичний аналіз за різними джерелами.
- ETL виконує трансформацію перед завантаженням, тоді як ELT спочатку завантажує, а трансформації виконуються всередині аналітичної платформи.
- Вимірні, нормалізовані та широкотабличні моделі обслуговують різні навантаження та потреби управління.
- Довіра залежить від лінійності, тестів, актуальності, контролю доступу, семантичних визначень та моніторингу витрат.
Джерела, завантаження та збергання
Дані можуть надходити пакетами, через захоплення змін даних, потоки, файли та API. Шар приземлення зберігає контекст джерела; трансформації стандартизує типи, видаляє дублікати записів, обробляє запізнілі події та створює повторно використовувані аналітичні сутності.
Це розширює процес ETL. ELT використовує обчислювальні ресурси сховища для трансформації, тоді як ETL може скорочувати або перевіряти дані перед завантаженням. Правильний вибір залежить від затримки, конфіденційності, масштабованості та інструментального ланцюжка.
Моделювання даних для запитань
Вимірні моделі організовують вимірювані факти навколо описових вимірів, таких як клієнт, продукт та час. Нормалізовані базові моделі можуть зберігати корпоративні зв’язки, тоді як денормалізовані марти спрощують типові запити.
Семантичний шар забезпечує метрики послідовними визначеннями. Без нього команди можуть отримувати кілька виглядаючих коректно показників доходу чи утримання з однакових рядків. Structured data все ще потребують узгодженого значення.
Сховище, озеро даних та lakehouse
Озеро даних зазвичай зберігає файли та різноманітні необроблені або оброблені дані в об’єктному сховищі. Сховище надає керовані аналітичні таблиці та служби запитів. Дизайн lakehouse додає метадані таблиць, транзакції та управління до сховища озера.
Це архітектурні патерни, а не гарантії. Організації часто поєднують їх за допомогою data fabric або спільного шару управління. Навантаження, навички, сумісність та вартість життєвого циклу важливіші за назву.
Якість, безпека та операції
Визначте власників, контракти, цілі актуальності, лінійність, тести, збереження та доступ до рядків або колонок. Відокремте персональні дані, використовуйте принцип найменших привілеїв і аудитуйте чутливі запити. Заповнення пропусків та зміни схеми потребують контрольованих, спостережуваних процедур.
Вимірюйте успішні оновлення, затримку даних, невдачі тестів, продуктивність запитів, впровадження, вплив інцидентів та вартість на навантаження. Сховище корисне, коли користувачі можуть простежити метрику до керованих даних і відтворити результат.
Вимірне моделювання та семантика
Таблиця фактів фіксує події або періодичні вимірювання з заданим рівнем деталізації, наприклад один рядок замовлення або один пристрій за годину. Виміри надають описовий контекст. Оголошення рівня деталізації перед вибором колонок запобігає змішуванню рівнів, що призводить до подвійного підрахунку. Додані (additive) показники можна підсумовувати по всіх вимірах; напівдодані показники потребують обережності щодо часу.
Сурогатні ключі відокремлюють історію сховища від змінних ідентифікаторів джерела. Повільно змінювані виміри визначають, як обробляти зміни атрибутів: перезапис, збереження нового історичного рядка або збереження обмежених попередніх значень. Правильний метод відповідає аналітичному питанню та вимогам зберігання.
Семантична метрика повинна визначати формулу, фільтри, поведінку у часі, валюту, виключення, власника та тести. Центральні визначення зменшують несумісність, проте управління має дозволяти пропоновані зміни та версіонування. Єдиний семантичний шар стає вузьким місцем, якщо користувачі не можуть відповідально його переглядати чи розширювати.
Сучасне сховище та архітектура запитів
Колонкове сховище зберігає значення колонки разом, підвищуючи компресію та сканування лише потрібних полів. Розбиття (partitioning) відсіює великі ділянки за датою чи іншим ключем; кластеризація розміщує пов’язані значення разом; матеріалізовані представлення та кеші повторно використовують результати. Погані вибори розбиття створюють крихітні файли, дисбаланс або дорогі повні сканування.
Масово паралельні двигуни запитів розподіляють сканування, з’єднання та агрегування між робітниками. Переміщення даних під час з’єднань може домінувати у часі виконання, тому розподіл, статистика та порядок з’єднань важливі. Автоматичне масштабування та безсерверні сервіси спрощують управління потужністю, але вимагають контролю витрат, пріоритетів навантажень та обмежень на неконтрольовані запити.
Формати таблиць lakehouse додають метадані, знімки, еволюцію схеми та транзакційну семантику над об’єктними файлами. Вони підвищують сумісність, але вводять обов’язки щодо каталогу та обслуговування. Відкриті формати зменшують прив’язку лише тоді, коли обчислювальні движки, управління та операційні процедури можуть їх фактично використовувати.
Надійні конвеєри та дані‑продукти
Конвеєри повинні бути ідемпотентними або вміти узгоджувати дублікати. Водяні позначки та час події обробляють запізнілі надходження; заповнення пропусків відтворює історичні трансформації; контракти схеми визначають сумісні зміни. Тести даних охоплюють унікальність, повноту, допустимі значення, зв’язки та бізнес‑інваріанти — а не лише факт виконання завдання.
Ставте важливі набори даних як продукти з власниками, документацією, очікуваннями сервісу, можливістю виявлення, підтримкою та користувачами. Лінійність з’єднує поля джерела через трансформації до звітів, що прискорює оцінку впливу змін та розслідування інцидентів. Політики доступу мають поширюватися або переоцінюватися при копіюванні даних.
Програма сховища досягає успіху, коли рішення стають більш надійними та швидкими, а не коли зростає обсяг сховища. Виводьте з експлуатації невикористовувані таблиці, відкривайте витрати на запити та сховище, переглядайте чутливий доступ і вимірюйте, чи довіряють команди та повторно використовують керовані метрики замість підтримки приватних електронних таблиць.
Практичний приклад: проектування сховища аналітики продажів
Визначте рівень деталізації факту як один завершений рядок замовлення, потім зв’яжіть виміри продукту, клієнта, каналу, промоції, географії та дати за допомогою сурогатних ключів. Тримайте події статусу замовлення у окремій таблиці фактів, а не змішуючи знімки та транзакції. До доходу, кількості, знижки, податку та вартості потрібні явні правила щодо валюти, повернень, скасувань та визнання. Визначення метрики має давати однаковий результат у панелях, ноутбуках та фінансових звірках.
Завантаження фіксує зміни джерела, розміщує незмінні необроблені дані, перевіряє схему та трансформує їх у протестовані проміжні та вимірні моделі. Запізнілі оновлення повинні виправляти відповідний історичний період без дублювання фактів. Порівнюйте кількість рядків та грошові підсумки з системами‑джерелами, тестуйте унікальність і зв’язки, і фіксуйте лінійність від поля звіту до джерела. Заповнення пропусків використовує версійований код та ізольовану валідацію перед заміною довірених таблиць.
Доступ розділяє ідентифікатори клієнтів від широко доступних агрегатів і застосовує принцип найменших привілеїв за ролями та призначенням. Управління навантаженням забезпечує швидку реакцію керівних панелей, тоді як аналітики виконують дослідницькі запити. Моніторте актуальність, невдалі тести, вартість запитів, невикористані таблиці та семантичні зміни. Сховище успішне, коли керовані метрики підтримують повторювані рішення; просте централізування даних може централізувати плутанину, якщо власність, якість та визначення залишаються невирішеними.
Відновлення після катастрофи має визначати охоплення резервних копій, копії між регіонами, відновлення каталогу та дозволів, допустиму втрату даних і час відновлення. Тестуйте відновлення у ізольованому середовищі та перевіряйте метрики, а не лише файли. Ключі шифрування, конфігурація ідентифікації, код оркестрації та семантичні визначення є частиною відновлюваної системи. Сховище, яке може відновити петабайти, але не може відтворити політику доступу чи довірені розрахунки, не відновило свою аналітичну службу.
Практичний чек‑лист впровадження
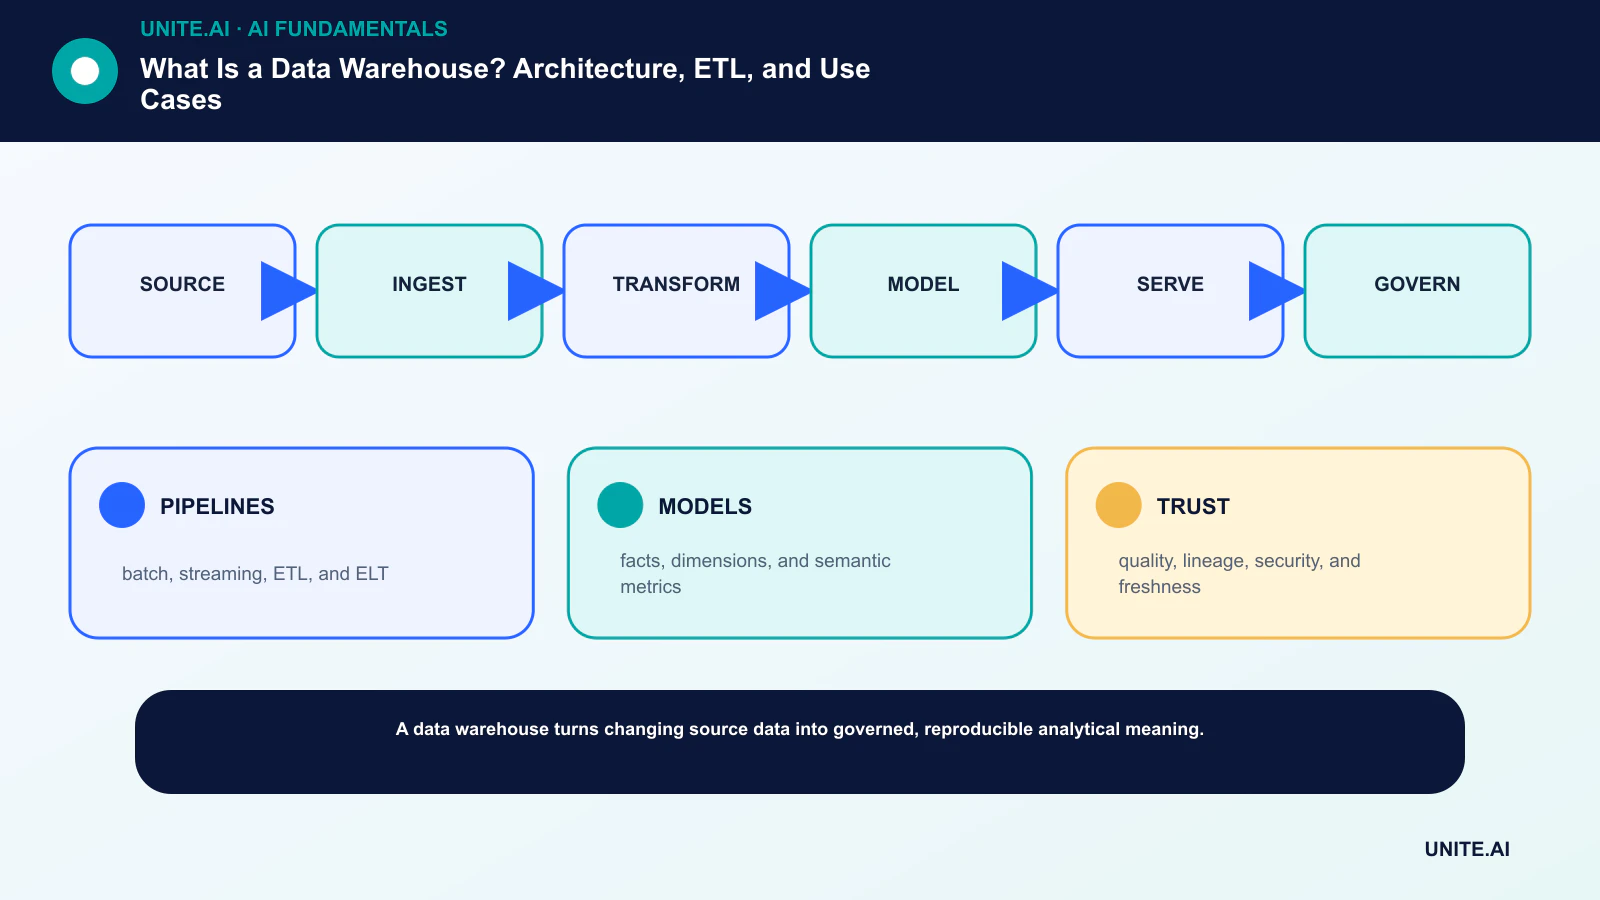
Перетворіть концепцію у чіткий, тестований робочий процес: джерело → завантаження → трансформація → модель → обслуговування → управління. Призначте відповідального власника, задокументуйте дані та залежності, встановіть просту базову лінію, визначте критерії прийняття та зупинки, протестуйте типові відмови та визначте моніторинг, відкат і перегляд перед розширенням обсягу. Фіксуйте версії та припущення, щоб інша команда могла відтворити результат і зрозуміти, що змінилося.
Перед запуском проведіть задокументований огляд готовності разом із людьми, які будують, експлуатують, захищають і на які впливає система. Тестуйте звичайні випадки, граничні умови, відмови залежностей та зловживання; зберігайте докази та невирішені ризики. Визначте, хто може затвердити випуск, змінити поріг, перевизначити результат або зупинити роботу. Перегляньте рішення після надходження реальних даних, оскільки технічно успішний пілот не гарантує надійної продуктивності у масштабі.
- КОНВЕЄРИ: пакетна, потокова, ETL та ELT.
- МОДЕЛІ: факти, виміри та семантичні метрики.
- ДОВІРА: якість, лінійність, безпека та актуальність.
Поширені запитання
Чи є сховище даних лише великою базою даних?
Це база даних або аналітична платформа, створена для інтегрованого історичного аналізу. Її моделювання, завантаження, управління та патерни навантажень відрізняються від бази даних транзакційних додатків.
Чи повинна компанія використовувати ETL чи ELT?
Багато організацій використовують обидва підходи. Трансформуйте рано, коли це потрібно для конфіденційності, валідації або пропускної здатності; трансформуйте після завантаження, коли обчислення сховища та швидка ітерація є вигідними.
Основні джерела