พื้นฐาน AI
การเรียนรู้แบบถ่ายโอนคืออะไร?

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google
การเรียนรู้แบบถ่ายโอน ใช้ความรู้ที่ได้เรียนรู้จากปัญหาหนึ่งเพื่อปรับปรุงการเรียนรู้ในปัญหาที่เกี่ยวข้องแทน การเริ่มต้นพารามิเตอร์ทั้งหมดแบบสุ่มไม่จำเป็น ผู้ปฏิบัติงานจะเริ่มจากโมเดลหรือการแสดงผลที่ผ่านการฝึกล่วงหน้าและปรับให้เข้ากับงานเป้าหมาย
วิธีการนี้มีประโยชน์เป็นพิเศษเมื่อชุดข้อมูลเป้าหมายมีขนาดเล็ก การทำป้ายกำกับมีค่าใช้จ่ายสูง หรือการฝึกล่วงหน้าต้องการการคำนวณมากกว่าที่ทีมเป้าหมายจะยอมรับได้ การฝึกโมเดลตั้งแต่เริ่มต้นเป็นทางเลือกแทนการเรียนรู้แบบถ่ายโอน—ไม่ใช่ประเภทของการเรียนรู้แบบถ่ายโอน
ประเด็นสำคัญ
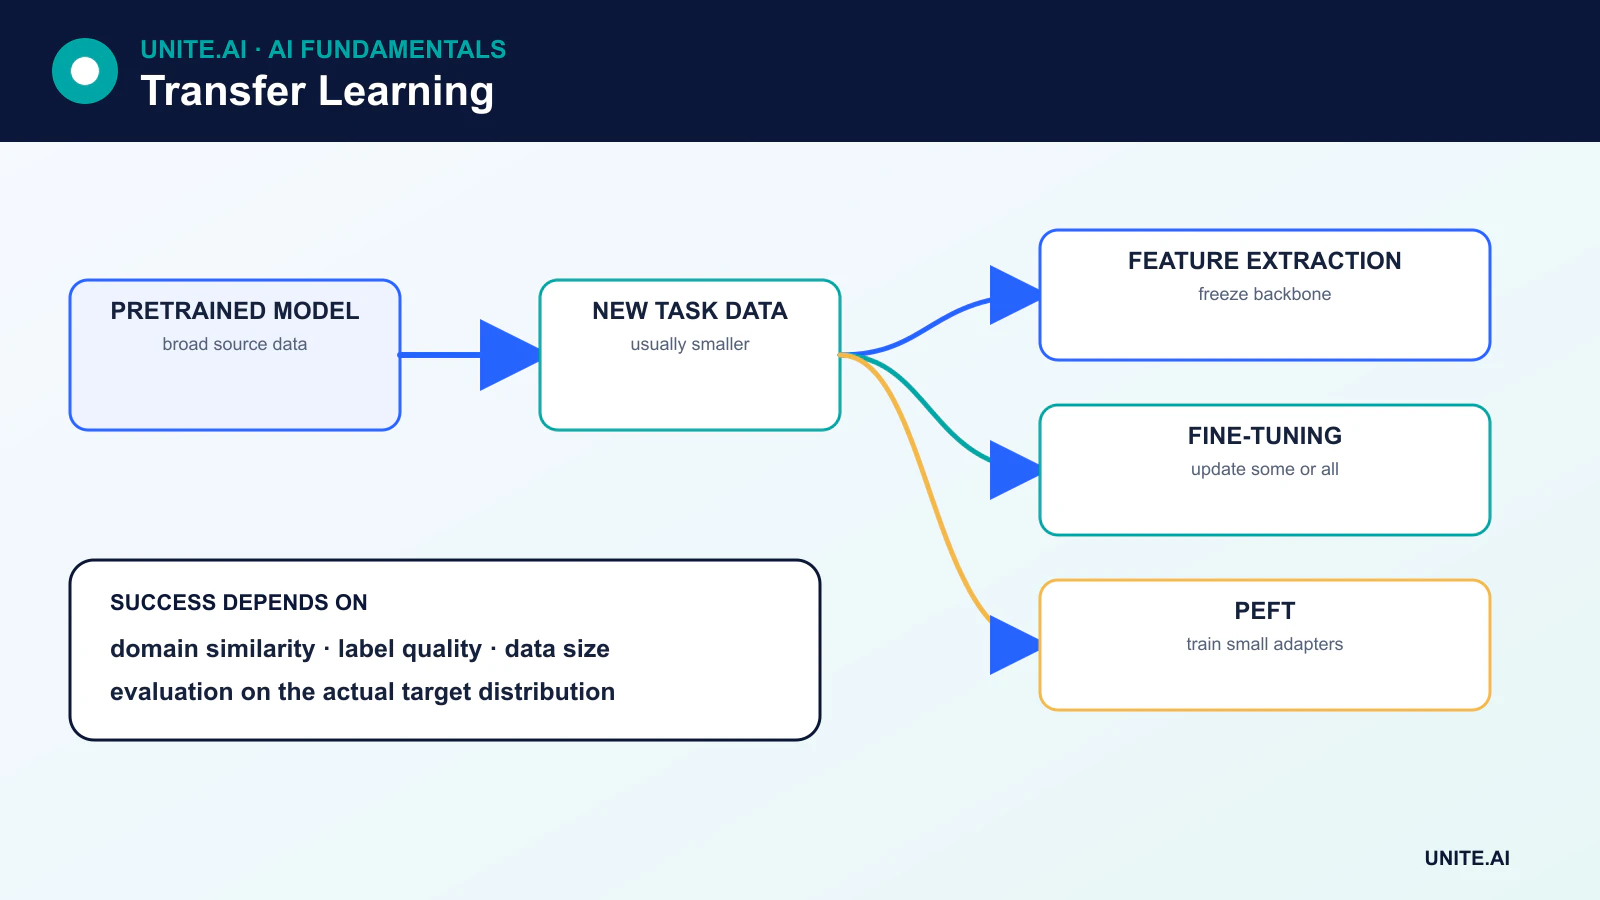
- การสกัดคุณลักษณะทำให้ฐานที่ผ่านการฝึกล่วงหน้าอยู่ในสถานะคงที่และฝึกหัวใหม่ที่เฉพาะงาน
- การปรับจูนละเอียดปรับพารามิเตอร์ที่ผ่านการฝึกล่วงหน้าบางส่วนหรือทั้งหมดโดยใช้ข้อมูลโดเมนเป้าหมาย
- วิธีการที่มีประสิทธิภาพด้านพารามิเตอร์ เช่น adapters และ LoRA ปรับส่วนเล็กของโมเดล
- การถ่ายโอนอาจล้มเหลวเมื่อโดเมนต้นทางและเป้าหมายแตกต่างกัน, สิทธิ์การใช้งานขัดแย้ง, หรือโมเดลต้นทางมีอคติที่ไม่เหมาะสม
ทำไมการเรียนรู้แบบถ่ายโอนจึงได้ผล
โมเดลมักเรียนรู้การแสดงผลที่มีประโยชน์เกินกว่าข้อมูลที่ใช้ฝึกโดยตรง ชั้นแรกของโมเดลภาพอาจจับรูปแบบท้องถิ่นที่นำกลับมาใช้ใหม่ได้; โมเดลภาษาอาจเรียนรู้ไวยากรณ์ ความหมาย และความสัมพันธ์กว้างจากการทำนายแบบอัตโนมัติ การทำงานเป้าหมายสามารถสร้างบนการแสดงผลเหล่านั้นแทนที่จะต้องเรียนรู้ใหม่จากตัวอย่างที่จำกัด
ประโยชน์ขึ้นอยู่กับความคล้ายคลึงระหว่างงานต้นทางและเป้าหมาย, ขนาดและคุณภาพของการฝึกล่วงหน้า, และวิธีการปรับโมเดล การนำกลับมาใช้ใหม่ไม่รับประกัน: คุณลักษณะที่ถ่ายโอนอาจไม่มีความเกี่ยวข้องหรืออาจเป็นอันตรายได้
การสกัดคุณลักษณะ
ในการสกัดคุณลักษณะ, ฐานที่ผ่านการฝึกล่วงหน้าจะถูกคงที่เพื่อไม่ให้พารามิเตอร์เปลี่ยนแปลง ผลลัพธ์ของมันจะเป็นอินพุตให้กับตัวจำแนกใหม่, ตัวถดถอย, หรือหัวงานเฉพาะอื่น ๆ เฉพาะหัวใหม่เท่านั้นที่ได้รับการฝึก
วิธีนี้เร็วและใช้ข้อมูลอย่างมีประสิทธิภาพ, ลดความเสี่ยงของการทำลายการแสดงผลที่ผ่านการฝึกล่วงหน้าที่มีประโยชน์ มันอาจเกิดการฝึกน้อยเกินไปเมื่อโดเมนเป้าหมายแตกต่างอย่างมากจากการฝึกล่วงหน้า ชั้นเช่น batch normalization ต้องการการดูแลเป็นพิเศษเนื่องจากสถิติที่เก็บไว้และพฤติกรรมการฝึกอาจส่งผลต่อการปรับแม้ว่าน้ำหนักส่วนใหญ่จะคงที่
การปรับจูนละเอียด
การปรับจูนละเอียด ปรับพารามิเตอร์ที่ผ่านการฝึกล่วงหน้าโดยใช้ข้อมูลเป้าหมาย กระบวนการทำงานทั่วไปคือ:
- โหลดโมเดลที่ผ่านการฝึกล่วงหน้าและแทนที่หรือเพิ่มหัวผลลัพธ์
- คงฐานไว้และฝึกหัวใหม่
- ยกเลิกการคงชั้นที่เลือก—หรือโมเดลทั้งหมด—และดำเนินต่อด้วยอัตราการเรียนรู้ที่ต่ำลง
- ตรวจสอบการฝึกเกิน, การลืม, และประสิทธิภาพในโดเมนเป้าหมาย
ไม่มีกฎสากลที่ระบุว่าต้องปรับเฉพาะชั้นสุดท้ายเท่านั้น ตัวเลือกที่ดีที่สุดขึ้นอยู่กับสถาปัตยกรรม, ขนาดข้อมูลเป้าหมาย, ความคล้ายคลึงของโดเมน, ชั้นการทำให้เป็นมาตรฐาน, หน่วยความจำ, และการคำนวณ การปรับจูนละเอียดเต็มรูปแบบอาจให้ความจุมากขึ้นแต่ต้องใช้ทรัพยากรเพิ่มและอาจทำให้เกิดการลืมอย่างรุนแรง
การปรับจูนละเอียดที่มีประสิทธิภาพด้านพารามิเตอร์
ตัวแปลงขนาดใหญ่ transformers ทำให้การปรับจูนละเอียดเต็มรูปแบบมีค่าใช้จ่ายสูง การปรับจูนละเอียดที่มีประสิทธิภาพด้านพารามิเตอร์ (PEFT) ปรับหรือเพิ่มชุดพารามิเตอร์เล็ก ๆ ในขณะที่ส่วนใหญ่ของโมเดลฐานยังคงคงที่
- Adapters แทรกโมดูลที่ฝึกได้ขนาดเล็กเข้าไปในเครือข่าย
- LoRA แทนการอัปเดตน้ำหนักด้วยเมทริกซ์ low-rank, ลดจำนวนพารามิเตอร์ที่ฝึกได้และหน่วยความจำของ optimizer
- Prompt and prefix tuning เรียนรู้อินพุตต่อเนื่องที่เฉพาะงานหรือพรีฟิกซ์ภายใน
PEFT สามารถเก็บการปรับหลายงานไว้รอบโมเดลฐานเดียว, แม้ว่าการให้บริการการคาดการณ์, ความเข้ากันได้ของ adapters, และการจัดการน้ำหนักที่รวมกันยังต้องการการออกแบบอย่างระมัดระวัง
การเรียนรู้แบบถ่ายโอนข้ามประเภทข้อมูล
ตัวจำแนกภาพมักเริ่มจากโมเดลที่ผ่านการฝึกล่วงหน้าบนชุดข้อมูลภาพขนาดใหญ่ ระบบภาษาเริ่มจากโมเดลพื้นฐานและปรับผ่านการปรับจูนละเอียดแบบมีผู้ควบคุม, การเพิ่มประสิทธิภาพตามความชอบ, การดึงข้อมูล, หรือการใช้เครื่องมือ โมเดลเสียง, ออดิโอ, โปรตีน, และโมเดลหลายโหมดก็ใช้รูปแบบที่คล้ายกัน
การถ่ายโอนยังสามารถเกิดขึ้นโดยไม่ต้องเปลี่ยนโมเดลต้นฉบับ โมเดลที่คงที่สามารถสร้าง embedding สำหรับตัวจำแนกต่อเนื่อง, ระบบ การค้นหาเวกเตอร์แบบคล้ายกัน, หรือกระบวนการดึงข้อมูลได้
การเปลี่ยนแปลงโดเมนและการถ่ายโอนเชิงลบ
Domain shift เกิดขึ้นเมื่ออินพุตเป้าหมายแตกต่างจากข้อมูลต้นทาง ตัวอย่างเช่น โมเดลภาพทางการแพทย์อาจเจออุปกรณ์, ประชากร, หรือโปรโตคอลการเก็บข้อมูลที่ไม่มีในขั้นตอนการฝึกล่วงหน้า Negative transfer หมายถึงการนำกลับมาใช้ทำให้ประสิทธิภาพของเป้าหมายแย่ลงกว่าฐานจากศูนย์ที่เหมาะสม
ทีมควรเปรียบเทียบกลยุทธ์การปรับ, ประเมินกลุ่มย่อยที่มีความหมาย, และเก็บชุดทดสอบโดเมนเป้าหมายไว้ หากงานต้นทางไม่ตรงกันดี โมเดลเฉพาะโดเมนขนาดเล็กอาจทำผลงานดีกว่าโมเดลทั่วไปขนาดใหญ่
การให้สิทธิ์, แหล่งที่มา, และความปลอดภัย
โมเดลที่ดาวน์โหลดได้ไม่ได้หมายความว่าจะปลอดภัยต่อการใช้งานโดยอัตโนมัติ ควรตรวจสอบใบอนุญาต, การใช้ที่อนุญาต, การเปิดเผยข้อมูลการฝึก, ข้อจำกัดของ model-card, และห่วงโซ่ของการพึ่งพา โมเดลอาจทำซ้ำอคติ, จำข้อมูลที่ละเอียดอ่อน, หรือมีโค้ดที่เป็นอันตรายในรูปแบบซีเรียลไลซ์ ใช้รูปแบบที่เชื่อถือได้, สแกนสิ่งประดิษฐ์, และโหลดน้ำหนักที่ไม่เชื่อถือในสภาพแวดล้อมแยกออก
เมื่อควรใช้การเรียนรู้แบบถ่ายโอน
การเรียนรู้แบบถ่ายโอนเป็นตัวเลือกเริ่มต้นที่แข็งแกร่งเมื่อมีโมเดลที่ผ่านการฝึกล่วงหน้าที่เกี่ยวข้องและข้อมูลเป้าหมายมีจำกัด การฝึกตั้งแต่เริ่มต้นอาจเหมาะสมเมื่อโดเมนมีความเฉพาะเจาะจงสูง, ใบอนุญาตไม่เข้ากัน, ขนาดโมเดลเกินขีดจำกัดการใช้งาน, หรืองานง่ายไม่ได้ประโยชน์จากการแสดงผลที่ผ่านการฝึกล่วงหน้าขนาดใหญ่ การตัดสินใจควรตรวจสอบด้วยข้อมูลเชิงประจักษ์แทนการสันนิษฐานจากขนาดโมเดล
สิ่งที่ถ่ายโอนและวิธีปรับให้เข้ากับมัน
การเรียนรู้แบบถ่ายโอนใช้การแสดงผลที่เรียนรู้จากงานหรือชุดข้อมูลต้นทางสำหรับงานเป้าหมาย ในด้านภาพ คุณลักษณะแรกมักจับขอบและพื้นผิว; ในด้านภาษา โมเดลที่ผ่านการฝึกล่วงหน้ารหัสลักษณะสถิติทั่วโทเคนและบริบท การถ่ายโอนทำงานเมื่อการแสดงผลต้นทางมีข้อมูลที่เกี่ยวข้องกับเป้าหมาย, แต่ความแตกต่างของโดเมน, ป้าย, รูปแบบ, และการเก็บข้อมูลอาจทำให้เกิดการถ่ายโอนเชิงลบ เริ่มด้วยฐานที่ผ่านการฝึกล่วงหน้า, ตรวจสอบใบอนุญาตการฝึกและเอกสาร, และเปรียบเทียบกับการฝึกโมเดลขนาดเล็กเฉพาะงานตั้งแต่เริ่มต้น
การสกัดคุณลักษณะคง backbone และฝึกหัวใหม่; การปรับจูนละเอียดบางส่วนยกเลิกการคงชั้นที่เลือก; การปรับจูนละเอียดเต็มอัพเดตโมเดลทั้งหมด วิธีที่มีประสิทธิภาพด้านพารามิเตอร์เพิ่ม adapters หรืออัปเดต low-rank, ลดพารามิเตอร์ที่ฝึกได้แต่ไม่จำเป็นต้องลดหน่วยความจำของการคาดการณ์ ใช้อัตราการเรียนรู้ที่ต่ำกว่าสำหรับน้ำหนักที่ผ่านการฝึกล่วงหน้า, รักษาพฤติกรรมการทำให้เป็นมาตรฐาน, และหลีกเลี่ยงการลืมอย่างรุนแรงด้วยตารางเวลา, การปกติ화, การฝึกซ้ำ, หรือการอัปเดตที่จำกัดตามความจำเป็น เลือก checkpoint บนข้อมูลตรวจสอบเป้าหมายและทดสอบหลาย seed เนื่องจากชุดข้อมูลเป้าหมายขนาดเล็กมีความแปรปรวนสูง
การแลกเปลี่ยนระหว่างข้อมูล, การประเมินผล, และการใช้งานจริง
ข้อมูลเป้าหมายควรเป็นตัวแทนของสภาพการใช้งานจริงและกลุ่มย่อยสำคัญ, ไม่ใช่แค่ตัวอย่างที่มีป้ายกำกับสะดวกสบาย ควรแบ่งตามหัวข้อ, แหล่งที่มา, เวลา, หรือสถานที่เพื่อป้องกันตัวอย่างที่เกี่ยวข้องข้ามส่วนแบ่ง ทดสอบทั้งสภาวะในโดเมนและสภาวะที่เปลี่ยนแปลง เปรียบเทียบตัวแปรที่คง, ปรับบางส่วน, และปรับเต็มในด้านคุณภาพ, การปรับเทียบ, ค่าใช้จ่ายการฝึก, ความหน่วง, และความทนทาน การปรับปรุงคะแนนเฉลี่ยอาจซ่อนการสูญเสียในคลาสหายากที่สืบทอดจากอคติของต้นทาง ตรวจสอบตัวอย่างความล้มเหลวสำหรับทางลัดเฉพาะต้นทาง, ช่องว่างของคำศัพท์, หรือความแตกต่างของเซนเซอร์
ติดตามโมเดลฐาน, น้ำหนัก, tokenizer หรือการเตรียมข้อมูล, adapter, ข้อมูล, และใบอนุญาตเป็นกราฟการพึ่งพาเดียว โมเดลฐานที่ให้บริการอาจเปลี่ยนพฤติกรรม; น้ำหนักเปิดอาจทำให้เกิดความรับผิดชอบด้านซัพพลายเชนและการแพตช์ ตรวจสอบศิลปวัตถุที่รวมหรือส่งออกและสแกนไฟล์โมเดลจากแหล่งที่ไม่เชื่อถือ ในการผลิต, ตรวจสอบการเปลี่ยนแปลงของเป้าหมายและประสิทธิภาพ, และรักษาความสามารถในการย้อนกลับทั้งการปรับและเวอร์ชันฐาน การถ่ายโอนลดข้อมูลเป้าหมายที่ต้องการ; แต่ไม่ขจัดการทำป้ายกำกับ, การประเมิน, ความเป็นส่วนตัว, หรือความเชี่ยวชาญด้านโดเมน
ตัวอย่างการทำงาน: ปรับโมเดลภาพให้เข้ากับคลินิกใหม่
คลินิกปรับตัวเข้ารหัสภาพที่ผ่านการฝึกล่วงหน้าเพื่อจำแนกคุณภาพภาพก่อนการตรวจวินิจฉัย ตรวจสอบใบอนุญาตและรูปแบบของโมเดลต้นทาง, เก็บข้อมูลอุปกรณ์และเงื่อนไขการเก็บข้อมูลในท้องถิ่น, และแบ่งตามผู้ป่วย ตัวแปรการสกัดคุณลักษณะคง, adapter, ปรับบางส่วน, และปรับเต็มถูกเปรียบเทียบกับฐานท้องถิ่นขนาดเล็ก ตัวชี้วัดรวมถึงการเรียกคืนของคลาส, การปรับเทียบ, พฤติกรรมของกลุ่มย่อย, การคำนวณ, และความอ่อนไหวต่ออุปกรณ์, สถานที่, และศิลปวัตถุหายาก
โมเดลที่ปรับแล้วไม่สามารถทำการวินิจฉัยได้และส่งต่อภาพที่ความมั่นใจต่ำหรือไม่รองรับไปยังช่างเทคนิค การตรวจสอบการส่งออกยืนยันการเตรียมข้อมูลในท้องถิ่นและความเท่าเทียมเชิงตัวเลข รุ่นโมเดล, adapter, อุปกรณ์, และเวอร์ชันชุดข้อมูลถูกเชื่อมโยงในบันทึก การตรวจสอบพบสแกนเนอร์ใหม่, การเปลี่ยนแปลงโปรโตคอล, และการเปลี่ยนแปลงผลลัพธ์, ในขณะที่ตัวอย่างที่ตรวจสอบเป็นระยะช่วยประมาณประสิทธิภาพจริง การอัปเกรดโมเดลต้นทางถือเป็นการพึ่งพาใหม่ที่ต้องการการตรวจสอบ; การเรียนรู้แบบถ่ายโอนไม่ได้ให้เหตุผลอัตโนมัติในการใช้หลักฐานเก่า
หลักฐานการนำไปใช้และความพร้อมในการปฏิบัติการ
การตัดสินใจผลิตต้องการมากกว่าการสาธิตที่ประสบความสำเร็จ กำหนดผู้ใช้เป้าหมาย, สภาพแวดล้อมการทำงาน, อินพุต, เอาต์พุต, การพึ่งพา, เจ้าของ, และผลของความล้มเหลวสำคัญแต่ละประการ สร้างฐานที่ทำซ้ำได้และชุดประเมินที่เวอร์ชันก่อนการปรับทูน ทดสอบกรณีทั่วไป, สภาวะขอบเขต, อินพุตที่ผิดรูปหรือหายไป, การเปลี่ยนแปลงการกระจาย, การหยุดทำงานของการพึ่งพา, การใช้งานผิดวิธี, และกลุ่มหรือสภาพแวดล้อมที่อาจไม่ได้รับการบริการอย่างเพียงพอ วัดคุณภาพงานพร้อมกับการปรับเทียบหรือความไม่แน่นอน, ความหน่วง, ปริมาณการทำงาน, ต้นทุนทรัพยากร, การเข้าถึง, ความเป็นส่วนตัว, และความปลอดภัย บันทึกการแปลงและเกณฑ์ทุกอย่างเพื่อให้ผู้ตรวจสอบอิสระสามารถทำซ้ำผลลัพธ์และแยกแยะหลักฐานจากต้นแบบที่ดึงดูด
ก่อนเปิดใช้งาน, มอบอำนาจสำหรับการปล่อย, ข้อยกเว้น, การเปลี่ยนแปลง, การย้อนกลับ, และการยกเลิก ใช้การเปิดตัวเป็นขั้นตอน, รักษาการสำรองที่ปลอดภัย, และตรวจสอบการเฝ้าระวังด้วยความล้มเหลวที่ใส่เข้าไปโดยเจตนา โทรเมตรีการปฏิบัติงานควรเปิดเผยคุณภาพอินพุต, พฤติกรรมเอาต์พุต, เวอร์ชันของโมเดลหรือกฎ, สภาพการพึ่งพา, การแทรกแซงของมนุษย์, และผลลัพธ์ที่ยืนยันโดยไม่เก็บข้อมูลที่ละเอียดอ่อนที่ไม่จำเป็น กำหนดเกณฑ์การแจ้งเตือนและผู้รับผิดชอบการตอบสนอง, จากนั้นตรวจสอบหลักฐานจากโลกจริงหลังการใช้งานแทนการสันนิษฐานว่าประสิทธิภาพออฟไลน์จะคงอยู่ ประเมินใหม่เมื่อแหล่งข้อมูล, ผู้ใช้, โมเดล, ผู้จำหน่าย, นโยบาย, ฮาร์ดแวร์, หรือเป้าหมายเปลี่ยนแปลง ระบบที่ดูแลต้องมีการบันทึกการกู้คืน, การเรียนรู้จากเหตุการณ์, ขั้นตอนการลบและการเก็บรักษา, และจุดชัดเจนที่ควรปิดหรือแทนที่
อ้างอิงหลัก