
พื้นฐาน AI
การเรียนรู้แบบ Federated Learning คืออะไร?

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google
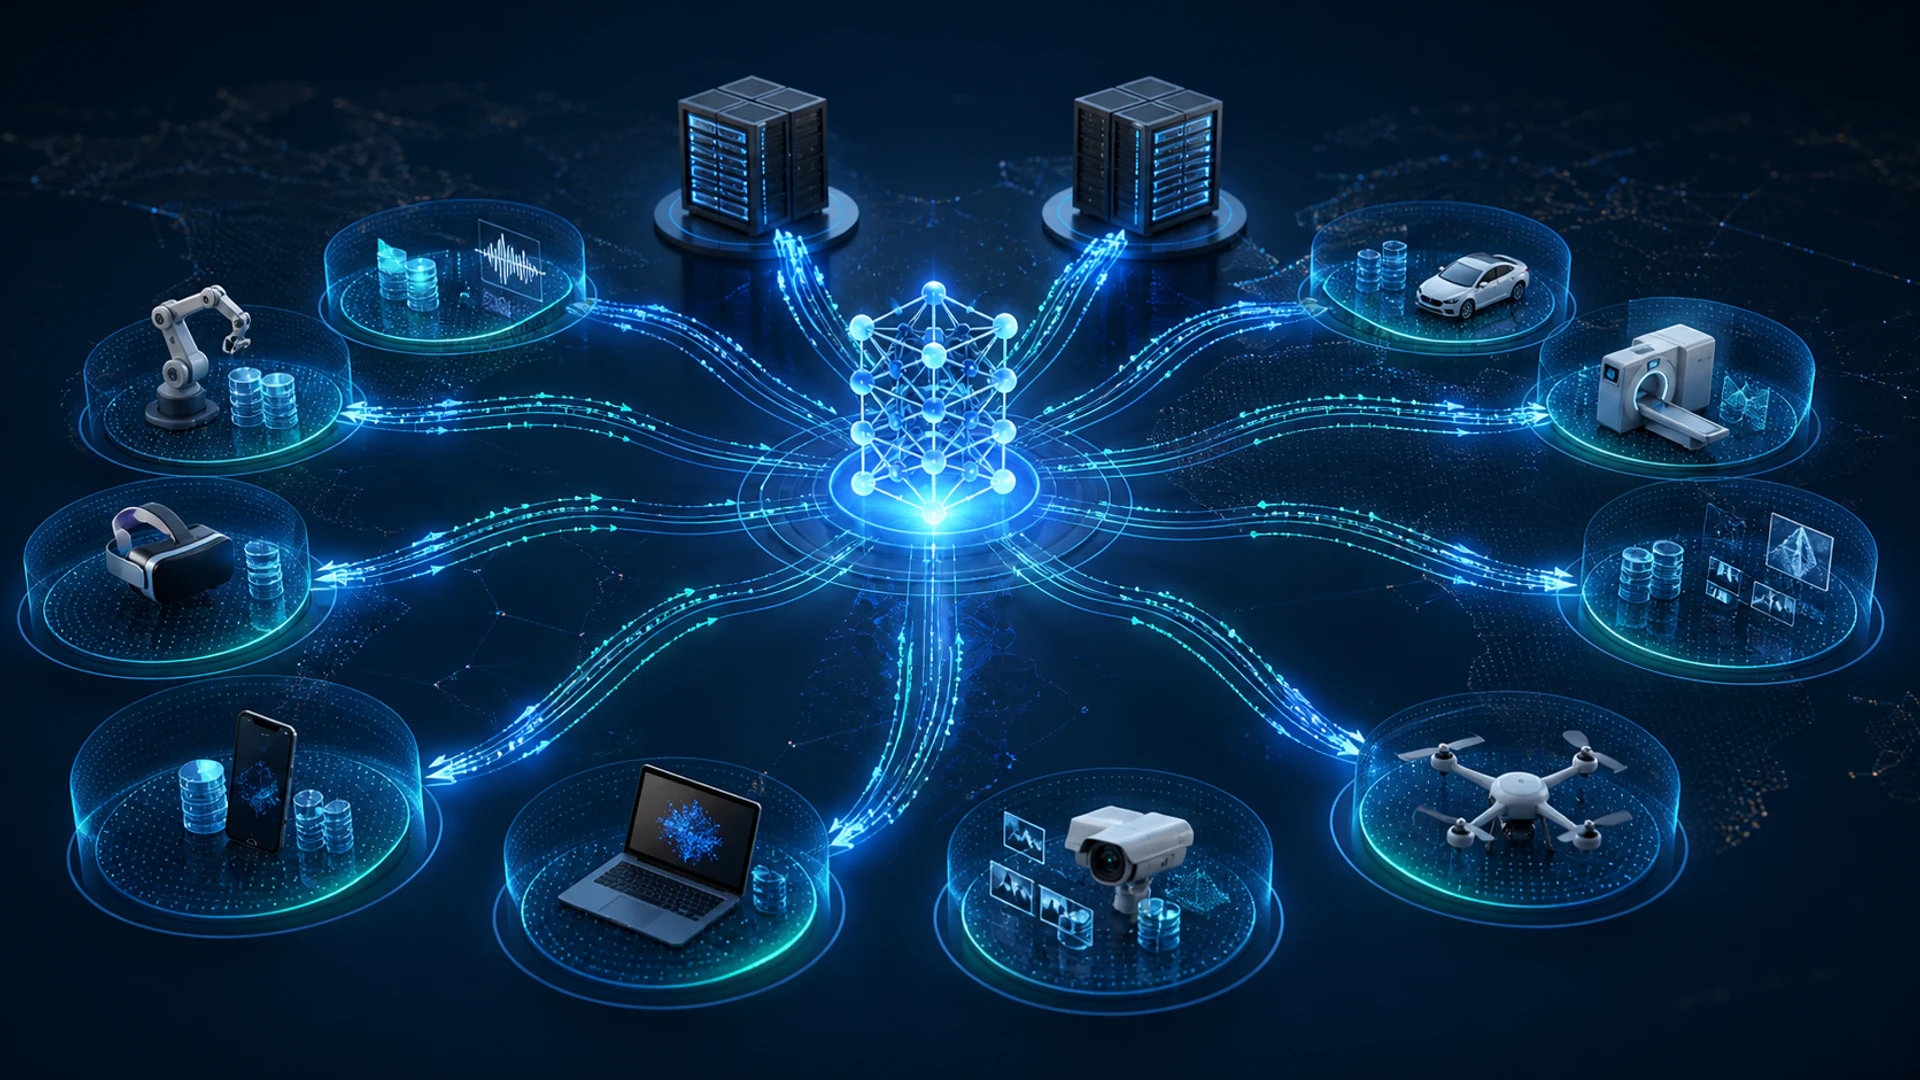
Federated learning ฝึกโมเดลร่วมกันบนอุปกรณ์หรือองค์กรหลายแห่งโดยคงข้อมูลการฝึกดิบของแต่ละผู้เข้าร่วมไว้ในเครื่องของตนเอง ตัวประสานงานจะกระจายพารามิเตอร์ของโมเดล, ลูกค้าจะคำนวณการอัปเดตบนข้อมูลของตนเอง, และขั้นตอนการรวมผลจะผสานการอัปเดตเหล่านั้นเข้าด้วยกัน
การเก็บบันทึกไว้ในเครื่องเป็นประโยชน์, แต่ไม่ได้หมายความว่ามีความเป็นส่วนตัวหรือความปลอดภัยอย่างสมบูรณ์ การอัปเดตโมเดลอาจทำให้ข้อมูลรั่วไหล, ลูกค้าที่ถูกโจมตีอาจทำให้การฝึกถูกปนเปื้อน, และตัวประสานงานยังต้องมีการรับรองความถูกต้อง, ความปลอดภัยในการส่งข้อมูล, การควบคุมการเข้าถึงและโมเดลความเชื่อมั่นที่กำหนดไว้
ประเด็นสำคัญ
- การเรียนรู้แบบกระจายย้ายการคำนวณไปยังข้อมูลที่กระจายอยู่; ไม่ได้ย้ายชุดข้อมูลดิบไปยังผู้ฝึกศูนย์เดียว
- ระบบข้ามอุปกรณ์มีอุปกรณ์จำนวนมากที่เชื่อมต่อเป็นครั้งคราว, ในขณะที่ระบบข้ามซิลโลมีองค์กรจำนวนน้อยกว่าแต่มีความเสถียรมากกว่า
- การรวมผลอย่างปลอดภัยและความเป็นส่วนตัวเชิงต่างจัดการความเสี่ยงที่แตกต่างกันและสามารถผสานรวมกันได้
- ข้อมูลที่ไม่เป็น IID, แบนด์วิดท์จำกัด, การเข้าร่วมที่ไม่เสถียรและการอัปเดตที่เป็นอันตรายเป็นข้อจำกัดหลักในการออกแบบ
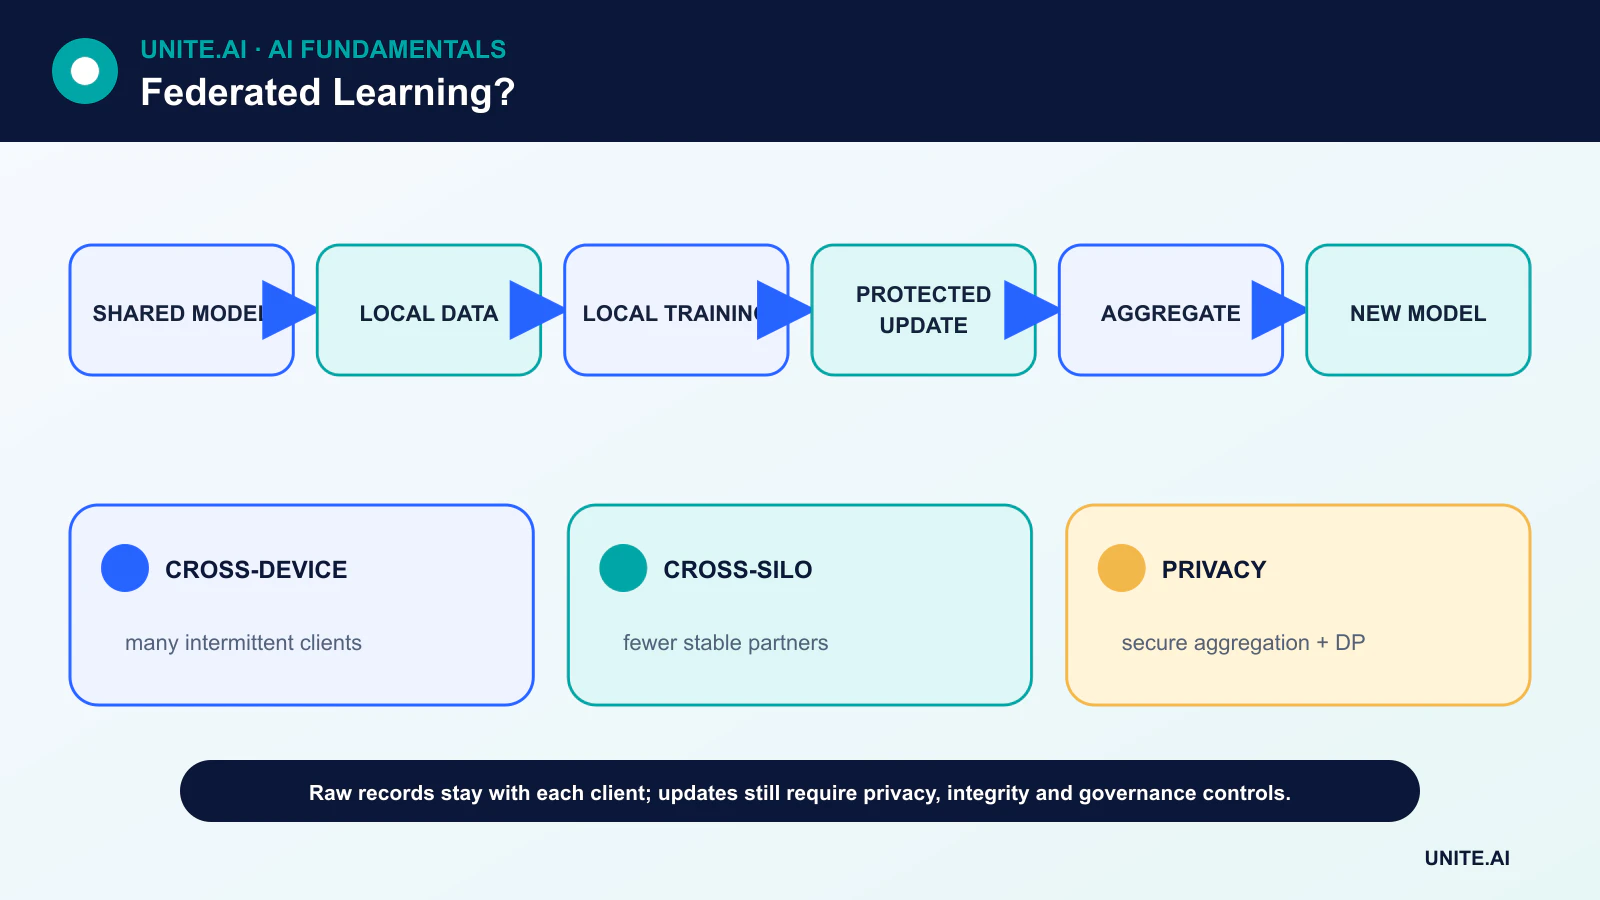
วงจรการเฉลี่ยแบบกระจาย
รอบการทำงานทั่วไปเริ่มต้นเมื่อผู้ประสานงานเลือกลูกค้าที่มีสิทธิและส่งโมเดลปัจจุบันให้แก่พวกเขา แต่ละลูกค้าจะฝึกโมเดลในเครื่องเองเป็นจำนวนขั้นตอนที่จำกัด, ผลลัพธ์คือการอัปเดตพารามิเตอร์หรือกราเดียนท์ ผู้ประสานงานจะรวมการอัปเดตที่มีสิทธิ—มักใช้ค่าน้ำหนักตามจำนวนตัวอย่างในเครื่อง—และเผยแพร่โมเดลร่วมใหม่
เพียงส่วนหนึ่งของลูกค้าเท่านั้นที่อาจเข้าร่วมในแต่ละรอบ โปรโตคอลต้องรองรับการตัดการเชื่อมต่อ, ความไม่ตรงกันของเวอร์ชันและอุปกรณ์ที่ไม่สามารถฝึกได้ขณะชาร์จ, มีงานหรือออฟไลน์ การสื่อสารอาจเป็นภาระหลักเหนือการคำนวณ, ดังนั้นการบีบอัดการอัปเดตและการลดจำนวนรอบการสื่อสารมักสำคัญกว่าความเร็วของตัวเร่งประมวลผลดิบ
การเรียนรู้ข้ามอุปกรณ์เทียบกับข้ามซิลโล
การเรียนรู้แบบกระจายข้ามอุปกรณ์อาจเกี่ยวข้องกับโทรศัพท์, เซนเซอร์หรือเบราว์เซอร์ที่เป็นของบุคคลหลายคน ลูกค้ามีจำนวนมาก, ความเชื่อถืออ่อนแอและพร้อมใช้งานเป็นครั้งคราว การเรียนรู้แบบกระจายข้ามซิลโลมักเชื่อมต่อกับกลุ่มโรงพยาบาล, ธนาคารหรือหน่วยธุรกิจจำนวนจำกัดที่มีโครงสร้างพื้นฐานเสถียรและการกำกับดูแลตามสัญญา
สภาพแวดล้อมทั้งสองต้องการสมมติฐานที่แตกต่างกันเกี่ยวกับตัวตน, การตรวจสอบและความล้มเหลว โครงการข้ามซิลโลสามารถเจรจาโครงสร้างข้อมูลร่วมและกระบวนการตรวจสอบ; บริการข้ามอุปกรณ์อาจต้องจัดการกับซอฟต์แวร์เวอร์ชันนับล้านและชุดข้อมูลในเครื่องที่ไม่สมดุลอย่างมาก
การรวมผลอย่างปลอดภัย, ความเป็นส่วนตัวเชิงต่าง และการเข้ารหัส
การรวมผลอย่างปลอดภัยเป็นโพรโทคอลการเข้ารหัสที่ทำให้เซิร์ฟเวอร์สามารถกู้คืนผลรวมได้โดยไม่ต้องอ่านการอัปเดตของแต่ละลูกค้า ความเป็นส่วนตัวเชิงต่างจำกัดว่าผลลัพธ์ที่เผยแพร่จะพึ่งพาข้อมูลหรือผู้เข้าร่วมใดบ้างโดยการตัดส่วนการสนับสนุนและเพิ่มสัญญาณรบกวนที่ปรับเทียบ
กลไกใดก็ไม่สามารถแก้ไขความเสี่ยงทั้งหมดได้ การรวมผลอย่างปลอดภัยไม่ได้ทำให้ผลรวมเป็นอันตรายต่อผู้ใช้, และความเป็นส่วนตัวเชิงต่างสร้างการแลกเปลี่ยนระหว่างความแม่นยำและความเป็นส่วนตัวที่ต้องคำนึงถึงด้วยงบประมาณความเป็นส่วนตัวที่ชัดเจน การเข้ารหัสปกป้องข้อมูลระหว่างการส่งหรือการจัดเก็บ; แต่ไม่ได้ป้องกันการสรุปผลจากโมเดลโดยตรง
ข้อมูลที่ไม่เป็น IID และคุณภาพของโมเดล
ข้อมูลของลูกค้ามักไม่เป็นอิสระและมีการกระจายแบบเดียวกัน โมเดลแป้นพิมพ์จะเห็นคำศัพท์ของแต่ละบุคคล; โรงพยาบาลให้บริการประชากรที่แตกต่างกัน; โรงงานใช้เครื่องจักรที่หลากหลาย ความแตกต่างเหล่านี้อาจทำให้การบรรลุเป้าหมายช้าลงและอาจทำให้ประสิทธิภาพที่แย่ของกลุ่มลูกค้าเล็ก ๆ ไม่ปรากฏ
การประเมินควรรวมถึงเมตริกระดับโลก, การกระจายตามลูกค้าหรือกลุ่ม, การปรับเทียบและการวิเคราะห์ความล้มเหลว ชุดทดสอบศูนย์อาจสะดวกแต่ไม่เพียงพอ สิ่งนี้เชื่อมโยงการเรียนรู้แบบกระจายกับ คุณภาพข้อมูลการเรียนรู้ของเครื่อง และการกำกับดูแล ข้อมูลเชิงโครงสร้างและไม่มีโครงสร้าง
ภัยคุกคามและการควบคุมการดำเนินงาน
ลูกค้าที่เป็นอันตรายอาจส่งการอัปเดตที่ปนเปื้อน, ลูกค้า sybil สามารถบิดเบือนการรวมผล, และเซิร์ฟเวอร์ที่ถูกโจมตีอาจกระจายโมเดลที่มุ่งเป้า การป้องกันรวมถึงการลงทะเบียนที่รับรอง, การตรวจจับความผิดปกติ, การรวมผลที่ทนทาน, การตรวจสอบความถูกต้องของการอัปเดต, การจำกัดอัตราและการรับรองซอฟต์แวร์ที่ทำซ้ำได้เมื่อเป็นไปได้
การเรียนรู้แบบกระจายเป็นส่วนหนึ่งของโครงการ ความปลอดภัยไซเบอร์ ที่กว้างขึ้น ทีมงานควรบันทึกว่าใครควบคุมผู้ประสานงาน, เมตาดาต้าใดที่ถูกรวบรวม, วิธีที่ผู้เข้าร่วมสามารถออกจากระบบ, วิธีการย้อนกลับโมเดลและสิ่งที่จะเกิดขึ้นเมื่อการทดสอบความเป็นส่วนตัวหรือคุณภาพล้มเหลว
การเพิ่มประสิทธิภาพแบบกระจายและความหลากหลายของข้อมูล
การเรียนรู้แบบกระจายส่งโมเดลหรือภารกิจอัปเดตไปยังลูกค้าที่เข้าร่วม, ฝึกในเครื่องและรวมการอัปเดตโดยไม่ต้องรวมตัวอย่างดิบไว้ศูนย์ ในการเฉลี่ยแบบกระจาย, ลูกค้าที่เลือกจะทำหลายขั้นตอนการเพิ่มประสิทธิภาพในเครื่องและเซิร์ฟเวอร์คำนวณค่าเฉลี่ยที่มีน้ำหนักตามจำนวนตัวอย่าง การรอบการสื่อสาร, epoch ภายในเครื่อง, การเลือกและอัตราการเรียนรู้เป็นการแลกเปลี่ยนระหว่างแบนด์วิดท์และการบรรลุผล การตั้งค่าข้ามอุปกรณ์มีอุปกรณ์โทรศัพท์หรือเซนเซอร์ที่ไม่น่าเชื่อถือจำนวนมาก; การตั้งค่าข้ามซิลโลมีองค์กรจำนวนน้อยกว่าแต่มีการคำนวณ, ตัวตนและการกำกับดูแลที่แข็งแกร่งกว่า
ข้อมูลของลูกค้ามักไม่เป็นอิสระและไม่สม่ำเสมอ: ผู้ใช้แตกต่างกันในพฤติกรรม, การกระจายป้ายกำกับ, ปริมาณและความพร้อมใช้งาน การฝึกในเครื่องอาจเบี่ยงเบนในทิศทางที่ไม่เข้ากัน, ทำให้ค่าเฉลี่ยง่าย ๆ ไม่เสถียรหรือเอนเอียงไปทางลูกค้าที่มีปริมาณสูงและใช้งานบ่อย อัลกอริทึมอาจใช้เทอมใกล้เคียง, การเพิ่มประสิทธิภาพเซิร์ฟเวอร์แบบปรับตัว, การจัดกลุ่ม, การปรับให้เป็นส่วนบุคคล หรือการควบคุมตัวแปร การประเมินควรรายงานประสิทธิภาพระดับโลกและระดับลูกค้า, ลูกค้าหาง, ความถี่การเข้าร่วม, การบรรลุผล, การสื่อสารและพลังงาน ค่าเฉลี่ยที่ดีอาจปกปิดว่ากลุ่มลูกค้าที่มีขนาดเล็กหรือหายากได้รับโมเดลที่แย่ลง
ความเป็นส่วนตัว, ความปลอดภัย, และวิศวกรรมระบบ
การเก็บข้อมูลไว้ในเครื่องไม่ได้รับประกันความเป็นส่วนตัวโดยอัตโนมัติ Gradient และการอัปเดตอาจทำให้ข้อมูลสมาชิกหรือคุณลักษณะรั่วไหล, ในขณะที่โมเดลสุดท้ายอาจจดจำตัวอย่างได้ การรวมผลอย่างปลอดภัยซ่อนการอัปเดตของแต่ละบุคคลจากเซิร์ฟเวอร์, และความเป็นส่วนตัวเชิงต่างจำกัดการมีส่วนร่วมของข้อมูลโดยการตัดและเพิ่มสัญญาณรบกวน, แต่ทั้งสองทำให้ประโยชน์และความซับซ้อนในการดำเนินงานเปลี่ยนไป ระบุโมเดลภัยคุกคาม, หน่วยความเป็นส่วนตัว, งบประมาณและส่วนประกอบที่เชื่อถือได้ การเข้ารหัสระหว่างการส่งเป็นสิ่งจำเป็นแต่ไม่สามารถป้องกันลูกค้าที่เป็นอันตราย, การอัปเดตที่ปนเปื้อน, ผู้ประสานงานที่ถูกโจมตี, หรือการโจมตีแบบสรุปผลได้
การป้องกันรวมถึงลูกค้าที่ได้รับการรับรอง, การรวมผลที่ทนทาน, การตรวจสอบความผิดปกติ, การจำกัดการอัปเดต, การใช้ enclave ปลอดภัยในบางการออกแบบ, และการตรวจสอบกับข้อมูลที่สะอาด ผู้โจมตีแบบ Sybil สามารถสร้างลูกค้าจำนวนมาก; ช่องหลังสามารถคงอยู่หลังการเฉลี่ย; การละทิ้งการอัปเดตที่สงสัยอาจทำให้พฤติกรรมที่หายากแต่ถูกต้องถูกตัดออก ควรเวอร์ชันโค้ดของลูกค้า, รองรับรอบที่ขัดจังหวะ, ป้องกันการเล่นซ้ำ, และออกแบบให้รองรับผู้ล่าช้าและข้อจำกัดของอุปกรณ์ ความยินยอม, การเก็บรักษา, กฎระเบียบภูมิภาค, และการลบยังคงใช้กับข้อมูลในเครื่องและการอัปเดตที่ได้จากข้อมูล
ตัวอย่างการปรับใช้และการกำกับดูแล
แป้นพิมพ์บนมือถือสามารถฝึกการปรับปรุงคำถัดไปในเครื่องได้, แต่การเปิดตัวควรใช้กลุ่มผู้ใช้ที่มีอุปกรณ์และได้รับความยินยอม, เก็บการอัปเดตที่คลิปและได้รับการปกป้อง, และเปรียบเทียบกับฐานข้อมูลคงที่ ตรวจสอบประสิทธิภาพของภาษาและสำเนียง, แบตเตอรี่, การใช้ข้อมูล, และความเสี่ยงการจดจำก่อนการปล่อย ลูกค้าต้องการงานฝึกที่ลงลายเซ็นและการอัปเดตโมเดล; เซิร์ฟเวอร์ต้องการการกำหนดค่ารอบที่ตรวจสอบได้และการย้อนกลับ การเรียนรู้แบบกระจายเป็นสถาปัตยกรรมสำหรับการเรียนรู้แบบกระจายภายใต้ข้อจำกัด, ไม่ได้เป็นการทดแทนข้อมูลที่เป็นตัวแทน, วิศวกรรมความเป็นส่วนตัว, หรือความรับผิดชอบ
ตัวอย่างการทำงาน: การเรียนรู้แบบกระจายข้ามโรงพยาบาล
โรงพยาบาลฝึกโมเดลคุณภาพภาพร่วมกันโดยไม่ต้องรวมสแกนเข้าด้วยกัน โปรโตคอลทั่วไปกำหนดเมตาดาต้าอุปกรณ์, ป้ายกำกับ, การเตรียมข้อมูล, ความมีสิทธิของลูกค้า, epoch ภายในเครื่อง, การคลิปและการรวมผลอย่างปลอดภัย สถานพยาบาลเก็บข้อมูลผู้ป่วยและส่งการอัปเดตที่ได้รับการปกป้อง, ในขณะที่ผู้ประสานงานประเมินแต่ละรอบบนชุดข้อมูลที่แยกไว้ในเครื่อง ผลลัพธ์รายงานประสิทธิภาพระดับสถานพยาบาลและส่วนท้าย, ไม่ใช่เพียงค่าเฉลี่ยตามปริมาณ, เนื่องจากโรงพยาบาลขนาดเล็กและประเภทอุปกรณ์อาจถูกมองข้าม
โมเดลภัยคุกคามครอบคลุมการอัปเดตที่เป็นอันตราย, การรั่วไหลของสมาชิก, ลูกค้าที่ถูกโจมตี, และการเข้าถึงของผู้ประสานงาน ความเป็นส่วนตัวเชิงต่างถูกกำหนดด้วยงบประมาณที่บันทึกและทดสอบประโยชน์ โมเดลและแพคเกจงานได้รับการลงลายเซ็น; สถานพยาบาลสามารถถอนตัวและการอัปเดตสามารถตรวจสอบได้ รอบที่ปนเปื้อนหรือไม่เสถียรจะไม่แทนที่โมเดลที่ใช้งานโดยอัตโนมัติ โครงการเก็บฐานข้อมูลพื้นฐานในเครื่องและการตรวจสอบทางคลินิก, และถือสถาปัตยกรรมแบบกระจายเป็นหนึ่งในมาตรการความเป็นส่วนตัวภายในขอบเขตของความยินยอม, ความปลอดภัย, และภาระหน้าที่การกำกับดูแล
หลักฐานการดำเนินการและความพร้อมใช้งาน
การตัดสินใจในระดับการผลิตต้องการมากกว่าการสาธิตที่ประสบความสำเร็จ กำหนดผู้ใช้เป้าหมาย, สภาพแวดล้อมการทำงาน, อินพุต, เอาต์พุต, ขึ้นต่อ, เจ้าของ, และผลของความล้มเหลวสำคัญแต่ละรายการ สร้างฐานข้อมูลที่ทำซ้ำได้และชุดการประเมินที่มีเวอร์ชันก่อนการปรับแต่ง ทดสอบกรณีทั่วไป, เงื่อนไขขอบเขต, อินพุตที่ผิดรูปหรือหายไป, การเปลี่ยนแปลงการกระจาย, การขัดข้องของส่วนขึ้นต่อ, การใช้ผิดวิธี, และกลุ่มหรือสภาพแวดล้อมที่อาจไม่ได้รับการสนับสนุนอย่างเพียงพอ วัดคุณภาพของงานพร้อมกับการปรับเทียบหรือความไม่แน่นอน, ความหน่วง, ปริมาณการทำงาน, ต้นทุนทรัพยากร, การเข้าถึง, ความเป็นส่วนตัว, และความปลอดภัย บันทึกการแปลงและเกณฑ์ทุกขั้นตอนเพื่อให้ผู้ตรวจสอบอิสระสามารถทำซ้ำผลลัพธ์และแยกแยะหลักฐานจากต้นแบบที่ดึงดูด
ก่อนการเปิดใช้งาน, มอบอำนาจสำหรับการปล่อย, ข้อยกเว้น, การเปลี่ยนแปลง, การย้อนกลับ, และการยกเลิก ใช้การเปิดตัวแบบขั้นตอน, รักษาการสำรองที่ปลอดภัย, และตรวจสอบการเฝ้าระวังด้วยความล้มเหลวที่ใส่เข้าไปโดยเจตนา เทเลเมตรีการดำเนินงานควรเปิดเผยคุณภาพอินพุต, พฤติกรรมเอาต์พุต, เวอร์ชันของโมเดลหรือกฎ, สถานะส่วนขึ้นต่อ, การแทรกแซงของมนุษย์, และผลลัพธ์ที่ยืนยันโดยไม่เก็บข้อมูลที่ละเอียดอ่อนที่ไม่จำเป็น กำหนดเกณฑ์การแจ้งเตือนและเจ้าของการตอบสนอง, จากนั้นตรวจสอบหลักฐานจากโลกจริงหลังการปรับใช้แทนการสันนิษฐานว่าประสิทธิภาพออฟไลน์จะคงอยู่ ประเมินใหม่เมื่อแหล่งข้อมูล, ผู้ใช้, โมเดล, ผู้ขาย, นโยบาย, ฮาร์ดแวร์, หรือเป้าหมายเปลี่ยนแปลง ระบบที่ดูแลต้องมีขั้นตอนการกู้คืนที่บันทึกไว้, การเรียนรู้จากเหตุการณ์, การลบและการเก็บรักษา, และจุดชัดเจนที่ควรปิดหรือแทนที่
คำถามที่พบบ่อย
การเรียนรู้แบบกระจายรับประกันว่าข้อมูลส่วนตัวจะไม่รั่วไหลหรือไม่?
ไม่ การเรียนรู้แบบกระจายช่วยลดการเคลื่อนย้ายข้อมูลดิบ, แต่การอัปเดตและโมเดลสุดท้ายยังอาจเปิดเผยข้อมูลได้ ความเป็นส่วนตัวต้องอาศัยโมเดลภัยคุกคามและการควบคุมทางเทคนิคและองค์กรเพิ่มเติม
เมื่อการฝึกแบบศูนย์กลางง่ายกว่า?
เมื่อข้อมูลสามารถรวมศูนย์ได้อย่างถูกกฎหมายและปลอดภัย, การฝึกแบบศูนย์กลางมักง่ายต่อการดีบัก, ทำซ้ำและเฝ้าระวัง การเรียนรู้แบบกระจายจึงมีเหตุผลเมื่อการกระจายเป็นความต้องการจริง, ไม่ใช่เพียงเป้าหมายการตลาด
อ้างอิงหลัก












