
พื้นฐาน AI
คอมพิวเตอร์วิทัศน์คืออะไร?

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google
Computer vision คือสาขาที่สร้างระบบเพื่อสกัดข้อมูลที่เป็นประโยชน์จากภาพและวิดีโอ โมเดลวิชันอาจทำการจำแนกภาพทั้งหมด, ระบุตำแหน่งวัตถุ, ป้ายกำกับทุกพิกเซล, อ่านข้อความ, ประเมินท่าทาง, ติดตามการเคลื่อนไหว, หรือเชื่อมเนื้อหาภาพกับภาษา
ระบบวิชันสมัยใหม่ไม่ได้เพียงแค่ทำกระบวนการตรวจจับขอบแบบแรกของการรับรู้ของมนุษย์ พวกมันเรียนรู้การแสดงผลเฉพาะงานจากข้อมูล โดยมักใช้ convolutional neural networks, vision transformers หรือโมเดลพื้นฐานแบบหลายโมดัล
ประเด็นสำคัญ
- การจำแนก, การตรวจจับ, การแบ่งส่วน, OCR, การติดตาม, และการสร้างเป็นงานวิชันที่แตกต่างกัน
- CNNs มีการสร้างความเป็นท้องถิ่นและการแชร์น้ำหนัก; Vision transformers ใช้ attention ข้ามแพทช์ของภาพ
- ป้ายกำกับสามารถมาจากมนุษย์, การกำกับแบบอ่อน, ข้อมูลสังเคราะห์, หรือวัตถุประสงค์การเรียนรู้แบบอัตโนมัติ
- ความแม่นยำอย่างเดียวไม่เพียงพอ: ความทนทาน, ความหน่วง, ความเป็นส่วนตัว, ความลำเอียง, และค่าใช้จ่ายจากความล้มเหลวมีความสำคัญ
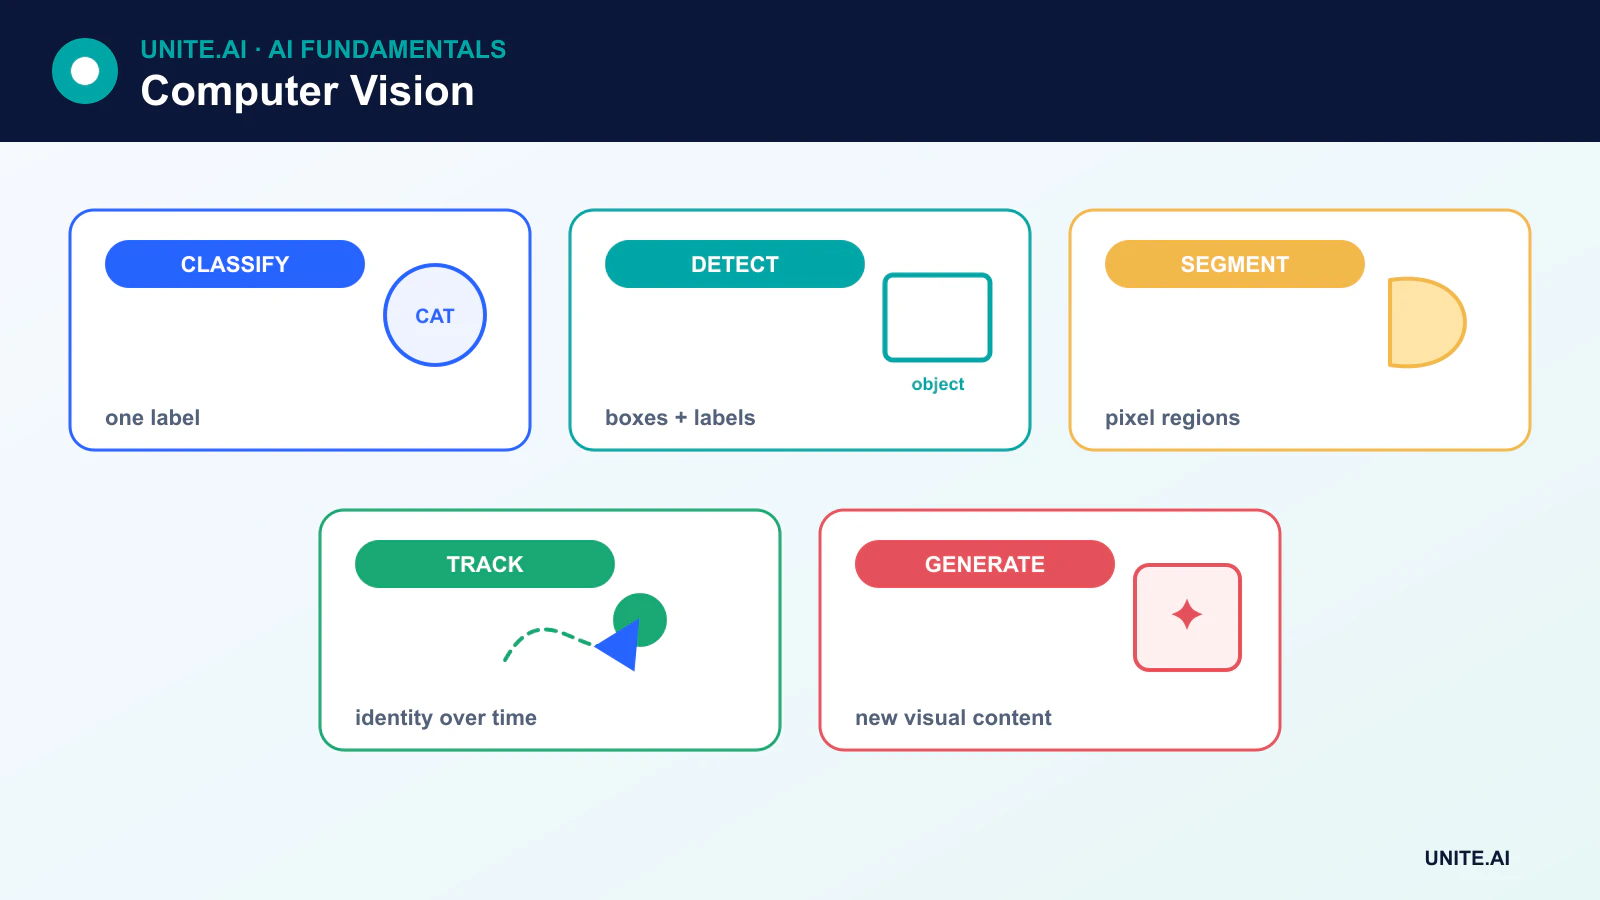
งานคอมพิวเตอร์วิทัศน์หลัก
- Image classification การจำแนกภาพกำหนดหนึ่งหรือหลายป้ายกำกับให้กับภาพ ดูวิธีการทำงานของการจำแนกภาพ
- Object detection การตรวจจับวัตถุทำนายประเภทและกรอบจำกัดสำหรับหลายวัตถุ
- Semantic segmentation การแบ่งส่วนเชิงความหมายป้ายกำกับแต่ละพิกเซลตามคลาส, ในขณะที่การแบ่งส่วนแบบอินสแตนซ์แยกวัตถุแต่ละชิ้น
- Optical character recognition (OCR) การรู้จำอักขระเชิงแสง (OCR) ตรวจจับและถอดข้อความ
- Pose estimation การประมาณท่าทางทำนายจุดสำคัญของร่างกายหรือวัตถุ
- Tracking การติดตามเชื่อมโยงการตรวจจับข้ามเฟรมวิดีโอ
- Image generation and editing การสร้างและแก้ไขภาพสร้างหรือแปลงเนื้อหาภาพ, มักใช้โมเดล diffusion
วิธีที่ภาพกลายเป็นอินพุตของโมเดล
ภาพดิจิทัลเป็นข้อมูลเชิงตัวเลขอยู่แล้ว: เทนเซอร์ที่บรรจุค่าพิกเซลในมิติเชิงพื้นที่และช่องสัญญาณ การเตรียมข้อมูลอาจปรับขนาด, ทำให้เป็นมาตรฐาน, ครอบหรือเพิ่มข้อมูลภาพ วิดีโอเพิ่มมิติเวลา ในขณะที่ภาพการแพทย์และวิทยาศาสตร์อาจเพิ่มความลึก, ความยาวคลื่น หรือโหมดอื่น ๆ
คอมพิวเตอร์วิทัศน์แบบคลาสสิกใช้คุณลักษณะขอบ, มุม, และพื้นผิวที่ออกแบบด้วยมือ โมเดลลึกสมัยใหม่มักเรียนรู้คุณลักษณะร่วมกับงาน แม้ว่าวิธีคลาสสิกยังมีประโยชน์เมื่อข้อมูลจำกัด, กฎเข้าใจชัดเจน, หรือคำนวณต้องน้อยที่สุด
CNNs และคุณลักษณะท้องถิ่นที่เรียนรู้
CNN จะใช้เคอร์เนลที่เรียนรู้ทั่วบริเวณใกล้เคียง ชั้นแรก ๆ สามารถตอบสนองต่อรูปแบบท้องถิ่น, ส่วนบล็อกต่อ ๆ ไปจะผสานเป็นการแสดงผลที่เกี่ยวข้องกับงาน การทำ Pooling หรือการดำเนินการแบบ stride ลดความละเอียดเชิงพื้นที่, และการเชื่อมต่อแบบ residual ทำให้เครือข่ายลึกง่ายต่อการปรับค่า
ตัวจำแนก CNN สมัยใหม่มักใช้ global pooling แทนการใช้ชั้น fully connected จำนวนมาก ตัวตรวจจับและเครือข่ายการแบ่งส่วนเพิ่มหัวพิเศษหรือเส้นทาง decoder ที่คงข้อมูลเชิงพื้นที่ไว้
Vision transformers และโมเดลพื้นฐาน
Vision transformer แบ่งภาพเป็นแพทช์, ฝังเวกเตอร์, แล้วใช้ attention เพื่อจำลองความสัมพันธ์ระหว่างแพทช์ การใช้ Transformers สามารถสเกลได้อย่างมีประสิทธิภาพกับชุดข้อมูลขนาดใหญ่และการฝึกล่วงหน้า, ในขณะที่ CNN มักให้สมมติฐานในตัวและประสิทธิภาพที่ดีกว่าในสเกลเล็ก
โมเดลหลายโมดัลจัดแนวภาพกับข้อความเพื่อให้ผู้ใช้สามารถค้นหา, ใส่คำอธิบาย, ตอบคำถาม, หรือชี้นำการแบ่งส่วนด้วยภาษา โมเดลเหล่านี้ขยายความสามารถแต่ก็สืบทอดข้อบกพร่องจากข้อมูลเว็บขนาดใหญ่รวมถึงอคติ, เนื้อหาที่มีลิขสิทธิ์, และการครอบคลุมที่ไม่สมดุลของประชากรและสภาพแวดล้อม
ป้ายกำกับ, การเรียนรู้แบบอัตโนมัติ, และข้อมูลสังเคราะห์
การสร้างกล่องขอบ, มาสก์, จุดสำคัญ, และคำอธิบายอาจมีค่าใช้จ่ายสูง การเรียนรู้แบบอัตโนมัติสกัดวัตถุประสงค์จากภาพเอง, ในขณะที่การกำกับแบบอ่อนใช้ป้ายกำกับที่มีเสียงหรือเป็นทางอ้อม ข้อมูลสังเคราะห์สามารถเพิ่มสถานการณ์หายาก, แต่ช่องว่างของการจำลองอาจทำให้ประสิทธิภาพของข้อมูลสังเคราะห์ไม่สามารถถ่ายโอนไปยังโลกจริงได้
คุณภาพของการทำเครื่องหมายต้องวัดได้ ป้ายกำกับที่คลุมเครือ, ขอบเขตไม่สอดคล้อง, และวัตถุที่หายไปจะตั้งขีดจำกัดให้กับประสิทธิภาพและอาจซ่อนความล้มเหลวของกลุ่มย่อย
วิธีประเมินระบบวิชัน
การจำแนกใช้เมตริกเช่น ความแม่นยำ, precision, recall, F1, และ calibration การตรวจจับมักใช้ intersection over union และ mean average precision การแบ่งส่วนใช้ intersection over union หรือเมตริกแบบ Dice การติดตามเพิ่มเมตริกอัตลักษณ์และเส้นทาง
เมตริกต้องสอดคล้องกับการนำไปใช้ โมเดลอาจได้คะแนนดีบนชุดทดสอบที่คัดสรรแล้วแต่ยังล้มเหลวในสภาพฝน, แสงน้อย, มุมกล้องแปลก, อุปกรณ์ใหม่, หรือประชากรที่ไม่คุ้นเคย การประเมินควรรวมการเปลี่ยนแปลงการกระจาย, สภาวะโจมตี, และความหน่วงของการทำงาน
ความเป็นส่วนตัว, ความลำเอียง, และการนำไปใช้
ใบหน้า, ป้ายทะเบียน, บ้าน, สแกนทางการแพทย์, และวิดีโอในที่ทำงานอาจเปิดเผยข้อมูลที่ละเอียดอ่อน การเก็บรวบรวมและการเก็บรักษาควรทำตามพื้นฐานทางกฎหมายและจริยธรรมที่กำหนด, พร้อมการควบคุมการเข้าถึงและการลดข้อมูล การวิเคราะห์ใบหน้าและการระบุตัวตนทางชีวมิติควรได้รับการตรวจสอบเป็นพิเศษเพราะข้อผิดพลาดและการเฝ้าระวังอาจสร้างอันตรายที่ไม่เท่าเทียม
การนำไปใช้ที่ขอบ (Edge) สามารถลดความหน่วงและการถ่ายโอนข้อมูล Edge AI, การควอนต้า, การตัดทอน, และตัวเร่งพิเศษสามารถทำให้ระบบวิชันใช้งานได้จริงบนกล้อง, ยานพาหนะ, หุ่นยนต์, และอุปกรณ์เคลื่อนที่, แต่การบีบอัดต้องประเมินใหม่เพื่อความแม่นยำและความลำเอียง
จากพิกเซลสู่ภารกิจภาพ
คอมพิวเตอร์วิทัศน์เปลี่ยนภาพหรือวิดีโอให้เป็นผลลัพธ์ตามงานเช่น การจำแนก, การตรวจจับ, การแบ่งส่วน, การติดตาม, ท่าทาง, ความลึก, optical flow, หรือการจดจำข้อความ คำจำกัดความของงานกำหนดการทำเครื่องหมาย: ป้ายภาพไม่สามารถฝึกการระบุตำแหน่งที่แม่นยำได้, และกล่องขอบไม่สามารถอธิบายมาสก์การแบ่งส่วนได้อย่างครบถ้วน เรขาคณิตของกล้อง, เลนส์, การเปิดรับแสง, แสงสว่าง, การเคลื่อนที่, การบีบอัด, และมุมมองกำหนดการกระจายของข้อมูล กำหนดสภาพแวดล้อมการทำงานและผลของข้อผิดพลาดก่อนเลือกโมเดล เพราะชุดภาพมาตรฐานอาจไม่สอดคล้องกับเซ็นเซอร์หรือฉากที่ใช้งานจริง
ขั้นตอนการทำงานจะถอดรหัสและจัดแนวสื่อ, ปรับขนาดหรือแบ่งเป็นแผง, ทำให้ค่ามาตรฐาน, ใช้การเพิ่มข้อมูลที่คงป้ายกำกับ, รันโมเดล, แล้วทำ post‑process logits, กล่อง, มาสก์ หรือการติดตาม ตัวตรวจจับวัตถุใช้เกณฑ์ความเชื่อมั่นและการกดทับ; ตัวติดตามเชื่อมโยงการตรวจจับตามเวลา; การแบ่งส่วนอาจต้องทำความสะอาดเชิงรูปทรง ควรรักษาการแปลงพิกัดเพื่อให้ผลลัพธ์สอดคล้องกับภาพต้นฉบับ แบ่งข้อมูลตามบุคคล, กล้อง, สถานที่, หรือช่วงการบันทึกเพื่อหลีกเลี่ยงเฟรมที่เกือบเหมือนกันปรากฏในชุดฝึกและทดสอบพร้อมกัน
การประเมิน, ความลำเอียง, ความเป็นส่วนตัว, และการดำเนินงาน
เมตริกต้องสอดคล้องกับงานและการใช้งาน การจำแนกต้องการ precision และ recall เฉพาะคลาส; การตรวจจับใช้ intersection‑over‑union และ average precision หลายเกณฑ์; การแบ่งส่วนใช้ IoU หรือ Dice; การติดตามเพิ่ม identity switches; ความหน่วงและระยะเวลาที่พลาดเหตุการณ์มีความสำคัญสำหรับวิดีโอ รายงานผลตามแสง, ระยะ, อุปกรณ์, การบัง, สีผิว, อายุ, และเงื่อนไขที่เกี่ยวข้องอื่น ๆ ตรวจสอบ calibration และข้อผิดพลาดที่ความมั่นใจสูง ข้อมูลสังเคราะห์หรือข้อมูลเพิ่มสามารถเติมช่องว่างได้แต่ต้องเปรียบเทียบกับข้อมูลการใช้งานจริงและต้องไม่รั่วไหลของฉากทดสอบ
วิชันสามารถเก็บข้อมูลผู้โดยสาร, สถานที่, ชีวมิติ, และพฤติกรรมที่ละเอียดอ่อนได้ ควรลดการจับและการเก็บรักษา, ปกป้องสตรีม, จำกัดการใช้ต่อไป, และให้การแจ้งหรือขอความยินยอมตามที่กฎหมายกำหนด ทดสอบแพตช์โจมตี, การเล่นซ้ำ, การบัง, ความล้มเหลวของกล้อง, และการเปลี่ยนแปลงโดเมน ตรวจสอบสุขภาพเซ็นเซอร์, สถิติอินพุต, อัตราผลลัพธ์, และผลลัพธ์ที่ยืนยัน; รักษาการตรวจสอบโดยมนุษย์สำหรับการตัดสินใจสำคัญ การเบลอหรือการครอปอาจลดการเปิดเผยแต่ก็อาจลบหลักฐานได้ คะแนนห้องปฏิบัติการสูงไม่เป็นเหตุผลให้ยืนยันการระบุตัวตน, อารมณ์, หรือเจตนานอกเหนือจากงานที่ตรวจสอบแล้ว
ตัวอย่างการทำงาน: การตรวจจับคนเดินเท้าที่ทางข้ามคลังสินค้า
กล้องเฝ้าตรวจสอบทางข้ามยานพาหนะที่จำกัด, และโมเดลตรวจจับคนแทนการระบุตัวตน ข้อมูลครอบคลุมวันและคืน, สภาพอากาศ, เสื้อผ้า, การบัง, ผู้ใช้รถเข็น, ตำแหน่งกล้อง, และฉากว่างเปล่า, แบ่งตามช่วงการบันทึก ตัวตรวจจับได้รับการประเมินตาม recall ของเหตุการณ์, การเตือนเท็จ, การระบุตำแหน่ง, ระยะเวลาการเตือนล่วงหน้า, และประสิทธิภาพตามระยะทาง วิศวกรรมความปลอดภัยกำหนดความหน่วงสูงสุดที่ยอมรับได้และการควบคุมทางกายภาพอิสระ
การเตือนจากวิชันอาจทำให้ยานพาหนะช้าลง, แต่การหยุดฉุกเฉินและกำแพงไม่ได้พึ่งพาโมเดลที่เรียนรู้ การอุดกั้นกล้อง, เฟรมค้าง, การสูญเสียเครือข่าย, และ timeout ของโมเดลสร้างความผิดพลาดอย่างชัดเจน การเก็บรักษาวิดีโอดิบถูกลดลงและบันทึกการเข้าถึง การตรวจสอบติดตามสุขภาพเซ็นเซอร์, อัตราการเตือน, เหตุการณ์ที่ตรวจสอบ, และเหตุการณ์ใกล้พลาดตามเงื่อนไข การย้ายตำแหน่งกล้องหรือการเปลี่ยนแผนผังใด ๆ จะกระตุ้นการตรวจสอบใหม่ เพราะความคล้ายคลึงของภาพที่ปรากฏอาจไม่รับประกันเรขาคณิตหรือความเสี่ยงเดียวกัน
หลักฐานการใช้งานและความพร้อมในการดำเนินงาน
การตัดสินใจผลิตต้องการมากกว่าการสาธิตที่ประสบความสำเร็จ กำหนดผู้ใช้เป้าหมาย, สภาพแวดล้อมการทำงาน, อินพุต, เอาต์พุต, ขึ้นต่อ, เจ้าของ, และผลของความล้มเหลวที่สำคัญแต่ละประการ สร้าง baseline ที่ทำซ้ำได้และชุดประเมินเวอร์ชันก่อนการปรับจูน ทดสอบกรณีทั่วไป, เงื่อนไขขอบเขต, อินพุตที่ผิดรูปหรือหายไป, การเปลี่ยนแปลงการกระจาย, การขัดข้องของส่วนพึ่งพา, การใช้ในทางที่ผิด, และกลุ่มหรือสภาพแวดล้อมที่อาจไม่ได้รับการบริการอย่างเพียงพอ วัดคุณภาพงานพร้อมกับ calibration หรือ uncertainty, ความหน่วง, throughput, ต้นทุนทรัพยากร, การเข้าถึง, ความเป็นส่วนตัว, และความปลอดภัย บันทึกการแปลงและเกณฑ์ทุกขั้นตอนเพื่อให้ผู้ตรวจสอบอิสระสามารถทำซ้ำผลลัพธ์และแยกแยะหลักฐานจากต้นแบบที่ดึงดูด
ก่อนเปิดตัว, มอบอำนาจการปล่อย, ข้อยกเว้น, การเปลี่ยนแปลง, การย้อนกลับ, และการถอดถอน ใช้การเปิดตัวเป็นขั้นตอน, เก็บ fallback ที่ปลอดภัย, และตรวจสอบการเฝ้าระวังด้วยการทำความล้มเหลวโดยเจตนา Telemetry การทำงานควรเปิดเผยคุณภาพอินพุต, พฤติกรรมเอาต์พุต, เวอร์ชันโมเดลหรือกฎ, สถานะส่วนพึ่งพา, การแทรกแซงของมนุษย์, และผลลัพธ์ที่ยืนยันโดยไม่เก็บข้อมูลที่ละเอียดอ่อนที่ไม่จำเป็น กำหนดเกณฑ์การเตือนและเจ้าของการตอบสนอง, แล้วตรวจสอบหลักฐานจากโลกจริงหลังการใช้งานแทนการสันนิษฐานว่าประสิทธิภาพออฟไลน์จะคงอยู่ ประเมินใหม่เมื่อแหล่งข้อมูล, ผู้ใช้, โมเดล, ผู้จำหน่าย, นโยบาย, ฮาร์ดแวร์, หรือเป้าหมายเปลี่ยนแปลง ระบบที่ดูแลต้องมีเอกสารการกู้คืน, การเรียนรู้จากเหตุการณ์, ขั้นตอนการลบและการเก็บรักษา, และจุดชัดเจนที่ควรปิดหรือแทนที่
คำถามที่พบบ่อย
คอมพิวเตอร์วิทัศน์เหมือนกับการจดจำภาพหรือไม่?
ไม่ การจดจำภาพโดยทั่วไปหมายถึงการจำแนกหรือการระบุตัวตน คอมพิวเตอร์วิทัศน์ยังรวมถึงการระบุตำแหน่ง, การแบ่งส่วน, การวัด, การติดตาม, การสร้างภาพ 3 มิติ, การสร้างเนื้อหา, และการให้เหตุผลเกี่ยวกับข้อมูลภาพ
ระบบวิชันมองเห็นเหมือนมนุษย์หรือไม่?
ไม่ โมเดลประมวลผลข้อมูลเชิงตัวเลขตามสถาปัตยกรรมและวัตถุประสงค์การฝึกของมัน มันอาจทำคะแนนดีกว่ามนุษย์ในเกณฑ์เฉพาะ แต่กลับล้มเหลวต่อการเปลี่ยนแปลงเล็ก ๆ ที่คนสามารถจัดการได้ง่าย
แหล่งอ้างอิงหลัก












