
พื้นฐาน AI
Albumentations คืออะไร? การเพิ่มภาพสำหรับคอมพิวเตอร์วิทัศน์

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google
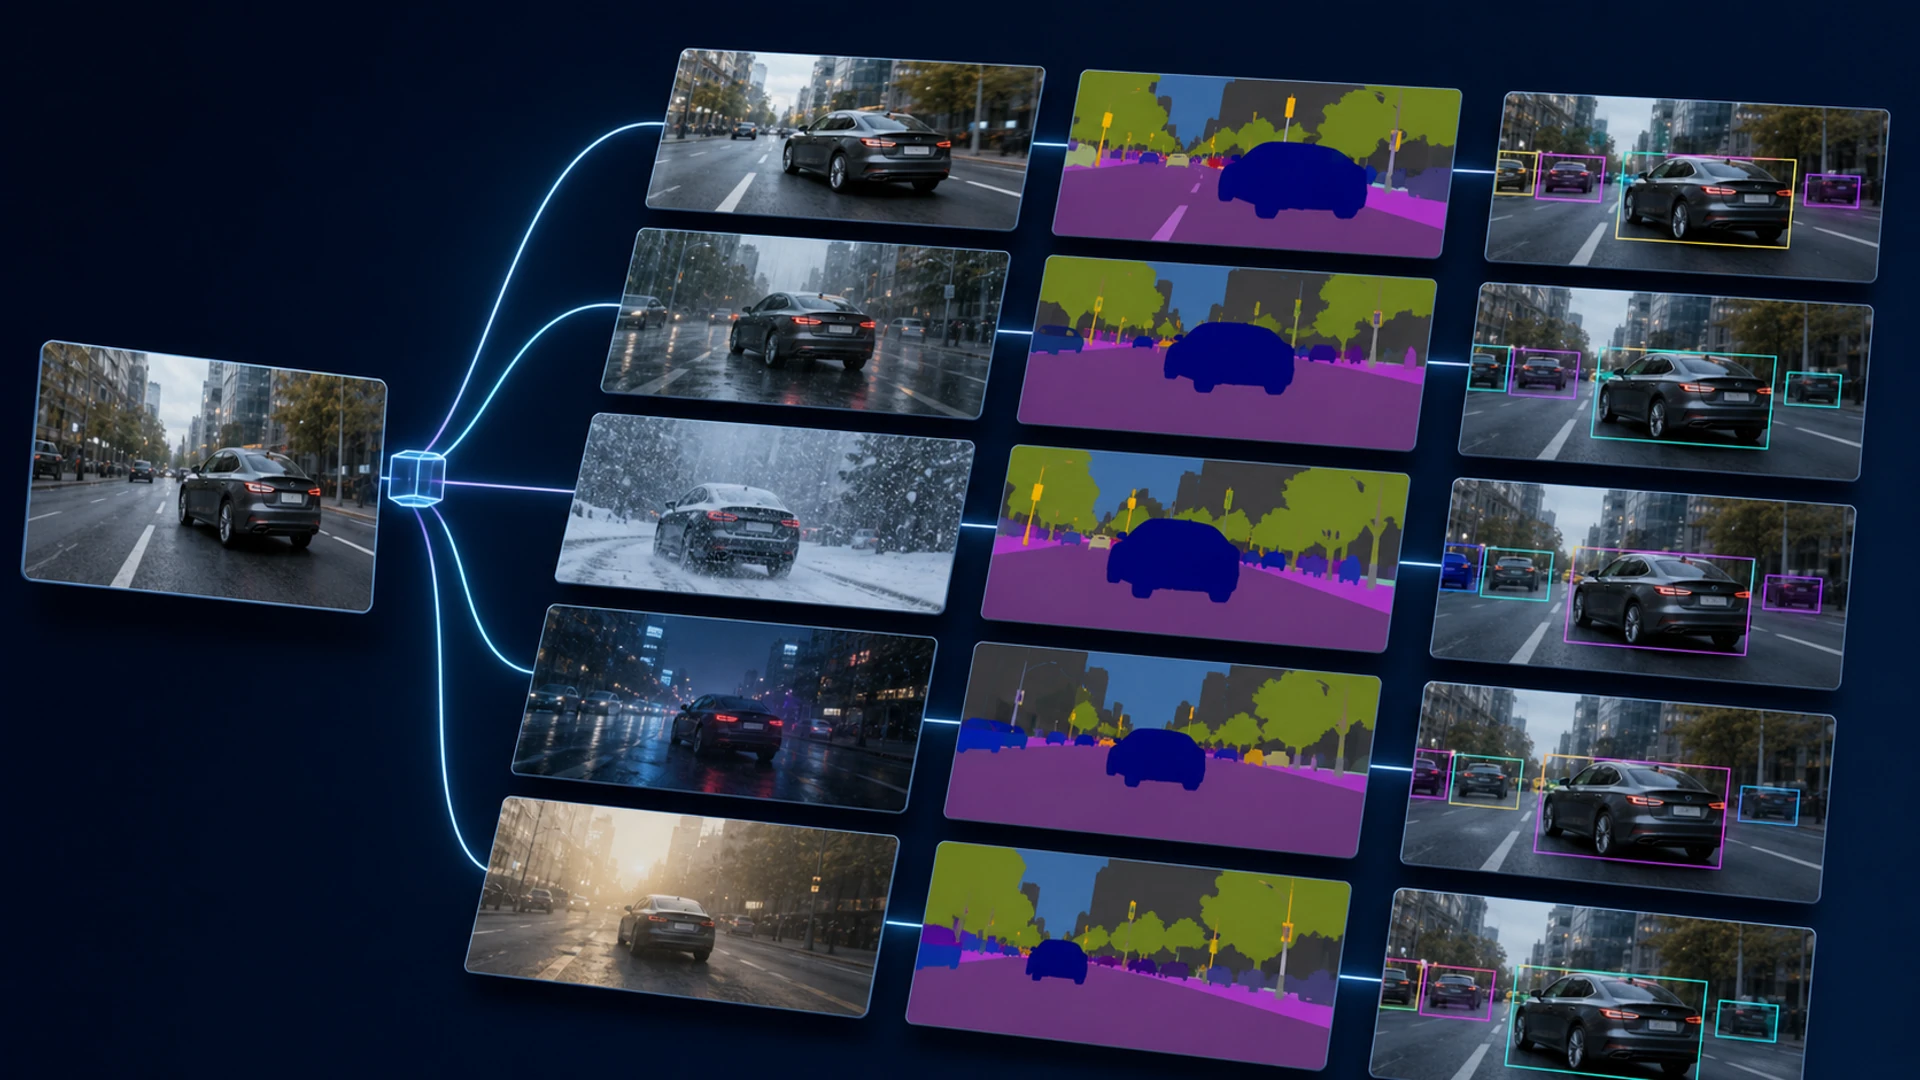
Albumentations เป็นไลบรารี Python แบบเปิดต้นฉบับสำหรับการเพิ่มภาพ มันใช้การแปลงเชิงเรขาคณิตและโฟโตเมตริกแบบสุ่มในขณะที่ทำให้เป้าหมายที่เกี่ยวข้อง—เช่น มาสก์การแบ่งส่วน, กล่องขอบเขต, และจุดสำคัญ—สอดคล้องกับภาพ
การเพิ่มภาพเป็นการสันนิษฐานเกี่ยวกับความไม่เปลี่ยนแปลง: มันบอกโมเดลว่าการเปลี่ยนแปลงที่เลือกควรไม่ทำให้ป้ายงานเปลี่ยนแปลง ไลบรารีที่เร็วทำให้การทดลองง่ายขึ้น แต่เพียงความรู้ด้านโดเมนและการตรวจสอบเท่านั้นที่สามารถกำหนดได้ว่าการแปลงนั้นเป็นที่ยอมรับหรือไม่
จุดสำคัญ
- จัดเรียงการแปลงแบบมีความน่าจะเป็นเป็น pipeline การฝึกที่ทำซ้ำได้
- แปลงภาพและเป้าหมายเชิงพื้นที่พร้อมกัน; ตรวจสอบกฎของกล่องและจุดสำคัญอย่างชัดเจน
- ใช้การเพิ่มภาพแบบสุ่มกับข้อมูลการฝึกเท่านั้น ไม่ใช่กับการกระจายการตรวจสอบหรือทดสอบที่ไม่ได้แก้ไข
- วัดผลกระทบต่อแต่ละคลาสและกลุ่มย่อย เพราะการเพิ่มภาพที่เข้มข้นอาจช่วยกรณีหนึ่งแต่ทำอันตรายต่ออีกกรณีหนึ่ง
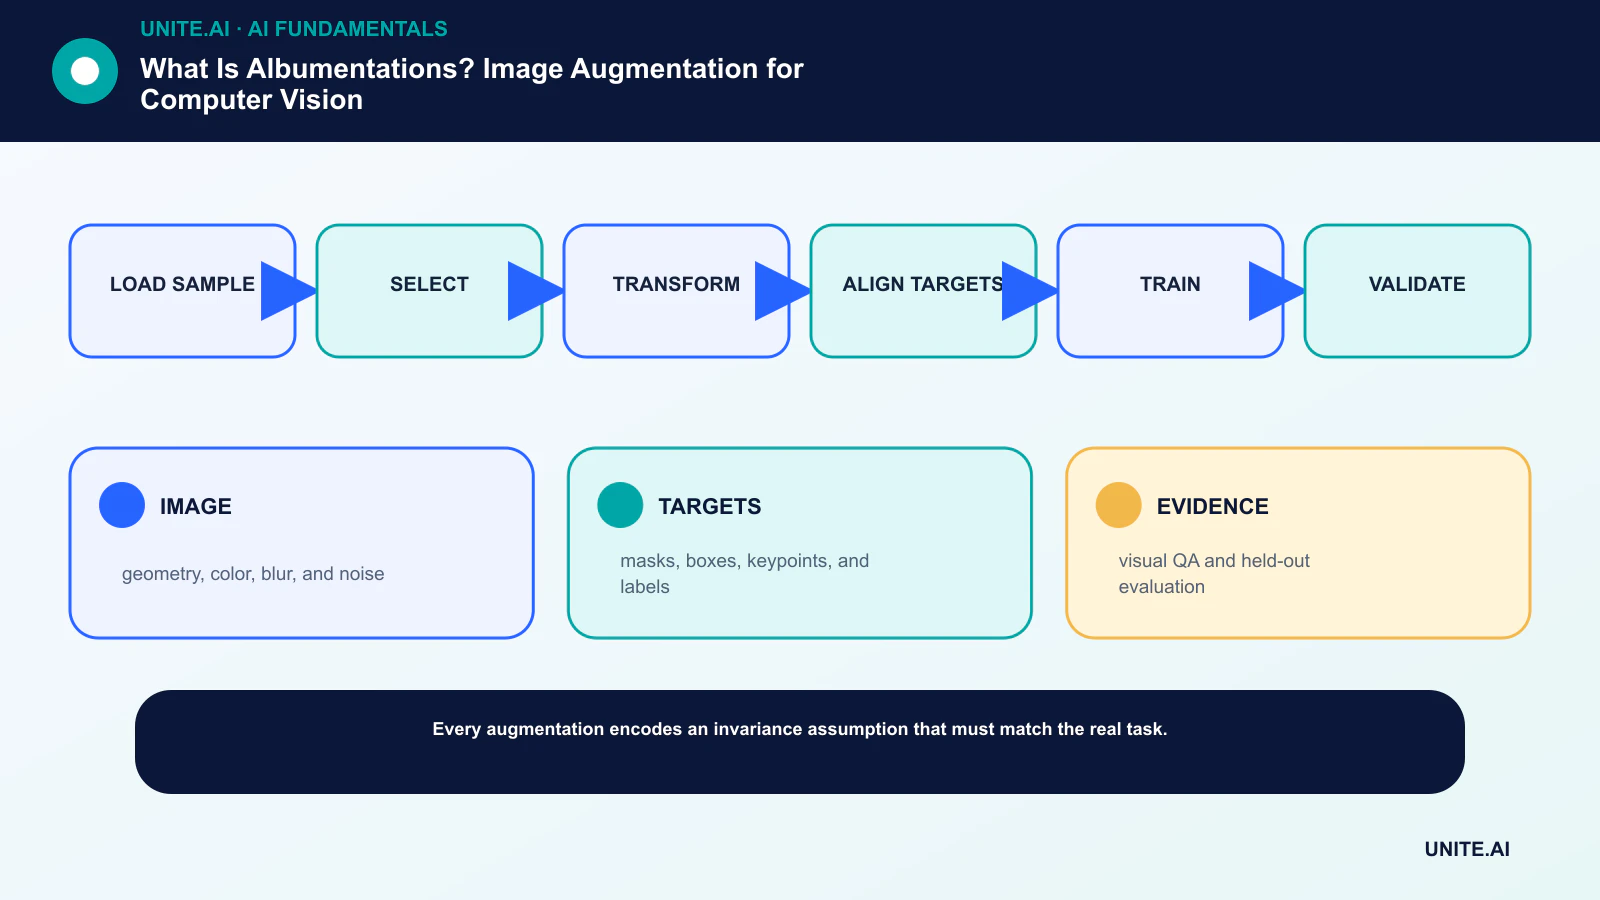
วิธีการทำงานของ pipeline Albumentations
pipeline รับภาพและเป้าหมายที่ระบุชื่อ, สุ่มเลือกการแปลงตามความน่าจะเป็นของแต่ละรายการ, และคืนค่าเป็นพจนานุกรมของผลลัพธ์ที่อัปเดต การแปลงเชิงเรขาคณิตสามารถตัด, หมุน, พลิก, หรือบิดเบือนได้; การแปลงโฟโตเมตริกสามารถเปลี่ยนสี, คอนทราสต์, เบลอ, หรือสัญญาณรบกวน
ไลบรารีนี้รวมเข้ากับสแต็กการฝึกได้โดยยังคงมุ่งเน้นที่การเพิ่มภาพ สำหรับ คอมพิวเตอร์วิทัศน์ การแยกนี้ทำให้สามารถเปรียบเทียบนโยบายข้อมูลได้อย่างอิสระจากกรอบโมเดล
รักษาความถูกต้องเชิงเรขาคณิตของป้ายกำกับ
การตัดที่เปลี่ยนภาพต้องตัดมาสก์ของภาพด้วยและอัปเดตหรือเอากล่องและจุดสำคัญที่ได้รับผลกระทบออก กำหนดรูปแบบพิกัด, ฟิลด์ป้ายกำกับ, ความมองเห็นขั้นต่ำ, การคลิปและกฎการกรอง, แล้วแสดงผลชุดข้อมูลก่อนการฝึก
การทำอินเทอร์โพเลชันจะแตกต่างตามเป้าหมาย: ภาพอาจใช้การทำ bilinear interpolation, ในขณะที่มาสก์คลาสทั่วไปต้องการ nearest‑neighbor interpolation เพื่อหลีกเลี่ยงการสร้างค่าประเภทใหม่ การจัดการเป้าหมายที่ไม่ถูกต้องอาจทำให้ชุดข้อมูลเสียหายโดยไม่รู้ตัว
เลือกการแปลงจากโลกของการใช้งานจริง
การพลิกแนวนอนอาจเหมาะกับภาพสัตว์ป่าแต่ไม่เหมาะกับข้อความ, ป้ายจราจร, ความเป็นซ้าย‑ขวาในทางการแพทย์, หรืออุปกรณ์ที่ไม่สมมาตร การเปลี่ยนสีอาจเพิ่มความทนทานต่อแสงแต่ก็อาจลบคุณลักษณะการวินิจฉัยเมื่อสีมีความหมาย
เริ่มต้นด้วยความแปรปรวนที่เป็นไปได้, เพิ่มหนึ่งกลุ่มต่อครั้ง, และตรวจสอบตัวอย่างที่ยาก เชื่อมโยงการเลือกกับสมมติฐานการ overfitting แทนที่จะสมมติว่าการเพิ่มความหลากหลายสังเคราะห์มากขึ้นจะดีกว่าเสมอ
ความสามารถในการทำซ้ำและการประเมินผล
บันทึกเวอร์ชันของไลบรารี, การตั้งค่า pipeline, ความน่าจะเป็น, กลยุทธ์ random‑seed, ลำดับการเตรียมข้อมูล, และการทำ normalization ความสุ่มควรทำให้ตัวอย่างการฝึกเปลี่ยนแปลงได้ขณะการทดลองยังคงทำซ้ำได้ในระดับการรัน
รักษาภาพ validation และ test ให้เป็นตัวแทนและไม่ทำ augmentation ยกเว้นการเตรียมข้อมูลแบบ deterministic เปรียบเทียบความแม่นยำ, การ calibration, ความผิดพลาดต่อคลาส, และความทนทาน Confusion matrices สามารถเปิดเผยว่าการเพิ่มภาพทำให้ข้อผิดพลาดเปลี่ยนแปลงไปโดยไม่ลดลงหรือไม่
การจัดเรียง, ความน่าจะเป็น, และเป้าหมาย
Compose ทำการเรียงลำดับของการแปลง, แต่ละรายการมีความน่าจะเป็น OneOf หรือ SomeOf จะสุ่มเลือกจากทางเลือกหลายแบบ, และความน่าจะเป็นซ้อนกันกำหนดการกระจายจริง นโยบายการเพิ่มภาพที่มีประสิทธิภาพจึงเป็นโปรแกรมสโตคาสติก; บันทึกและตรวจสอบความถี่ที่สุ่มได้แทนการอ่านความน่าจะเป็นแต่ละรายการแยกกัน
เป้าหมายเพิ่มเติมทำให้หลายภาพหรือมาสก์แชร์รูปทรงเรขาคณิต ซึ่งมีประโยชน์สำหรับคู่สเตอริโอ, ภาพก่อน‑หลัง, หรือการทำ annotation หลายชุด การสนับสนุน bounding‑box ต้องการรูปแบบที่ระบุเช่น Pascal VOC, COCO, YOLO, หรือพิกัดของ Albumentations รูปแบบ keypoint อาจรวมมุมหรือสเกล, และการแปลงต้องรักษา semantics เหล่านั้นไว้
การตัดอาจลบเป้าหมายทั้งหมด ตัดสินใจว่าจะทำการ resample, เก็บตัวอย่างพื้นหลัง, หรือกรองออก เพราะแต่ละทางเลือกจะเปลี่ยนการกระจายของคลาส pipeline detection และ segmentation ควรบันทึกกล่องที่ถูกละทิ้ง, ส่วนที่มองเห็นได้, และตัวอย่างว่างเพื่อเปิดเผยความเสียหายของป้ายที่ซ่อนอยู่
การออกแบบนโยบายตามงาน
การจำแนกประเภทมักยอมรับการตัด, การเปลี่ยนสี, การเบลอ, และการบังภาพเมื่อคลาสยังคงมองเห็นได้ Detection ต้องการวัตถุและกล่องที่แปลงพร้อมกัน Segmentation ต้องการรูปทรงมาสก์ที่แม่นยำ Pose estimation ต้องรักษา keypoint และอาจต้องสลับป้ายซ้าย‑ขวาหลังการพลิก
การถ่ายภาพทางการแพทย์อาจห้ามการพลิก, การเปลี่ยนสีรุนแรง, หรือการทำ interpolation ที่เปลี่ยนความเข้มของสัญญาณ Remote sensing ต้องคำนึงถึงทิศทาง, ฤดูกาล, แถบเซนเซอร์, และสเกลเชิงพื้นที่ การวิเคราะห์เอกสารต้องรักษาความอ่านง่ายและการจัดวาง โดเมนกำหนดสมมติฐานความไม่เปลี่ยนแปลง; ไลบรารีเพียงทำตามนั้น
วิธีผสมเช่น MixUp, CutMix, Mosaic, หรือ copy‑paste สร้างป้ายแบบผสมและอาจเกิดขึ้นใน data loader หรือ framework แทน Albumentations การโต้ตอบกับการแปลงพื้นฐาน, normalization, และ batching ควรทดสอบ นโยบายที่เข้มข้นอาจทำให้การบรรลุเป้าหมายช้าลงหรือเปลี่ยน calibration แม้ความแม่นยำสุดท้ายจะดีขึ้น
ประสิทธิภาพ, การดีบัก, และการออกแบบการทดลอง
การเพิ่มภาพทำงานบน CPU เว้นแต่จะใช้เส้นทางอื่น วัดอัตราผ่านของ data‑loader, จำนวน worker, ค่า decode, การคัดลอกหน่วยความจำ, และเวลาที่ GPU ว่าง การแปลงที่เร็วมีคุณค่าเฉพาะเมื่อไม่ทำให้ semantics เปลี่ยนแปลง แคชขั้นตอน decode หรือ preprocessing ที่ไม่เปลี่ยนแปลงเมื่อพื้นที่จัดเก็บและการทำซ้ำอนุญาต
แสดงกริดของตัวอย่างดั้งเดิมและที่แปลงพร้อม overlay ของทุกเป้าหมาย เพิ่มการทดสอบอัตโนมัติสำหรับการรอบพิกัด, ค่ามาสก์, รูปร่าง, dtype, และการ replay แบบ deterministic ตั้ง seed ที่ระดับที่เหมาะสม; การทำ augmentation แบบเดียวกันในทุก worker อาจลดความหลากหลายโดยไม่ได้ตั้งใจ
ทำการ ablation เทียบกับ baseline คงที่: ไม่มี augmentation, การแปลงพื้นฐานที่สมเหตุสมผล, แล้วตามด้วยนโยบายที่เข้มข้น ทำซ้ำ seed และรายงานความแปรปรวน ประเมินข้อมูลสะอาด, ความเสียหายที่เกี่ยวข้อง, และกลุ่มย่อยแยกกัน เก็บนโยบายไว้เฉพาะเมื่อประโยชน์ยังคงอยู่หลังการทดสอบแบบ hold‑out และภาพที่แปลงยังคงน่าเชื่อถือต่อผู้เชี่ยวชาญด้านโดเมน
การออกแบบและตรวจสอบ pipeline Albumentations
เริ่มจากความแปรปรวนที่คาดว่าจะเกิดหลังการใช้งานจริง: มุมกล้อง, การตัด, สเกล, การส่องสว่าง, การบีบอัด, การเบลอ, สภาพอากาศ, การบัง, และสัญญาณรบกวนของเซนเซอร์ เลือกการแปลงที่รักษาป้ายและสอดคล้องกับกลไกเหล่านั้น การพลิกแนวนอนอาจเหมาะกับสัตว์แต่ไม่เหมาะกับข้อความ, การจัดทิศทางจราจร, หรือกายวิภาคที่ไม่สมมาตร การเปลี่ยนสีรุนแรงอาจทำลายข้อมูลที่มีความสำคัญต่อการวินิจฉัยแม้ภาพยังดูสมเหตุสมผล
Albumentations จัดเรียงการแปลงและทำการเปลี่ยนแปลงเชิงพื้นที่อย่างสอดคล้องกับภาพ, มาสก์, bounding‑boxes, และ keypoints เมื่อกำหนดค่าอย่างถูกต้อง ระบุรูปแบบพิกัด, ความมองเห็นขั้นต่ำ, การทำ interpolation, และการจัดการมาสก์อย่างชัดเจน แสดงผลตัวอย่างที่เพิ่มหลายร้อยตัวพร้อม annotation overlay, ทดสอบกรณีว่างและขอบเขต, แล้วบันทึกพารามิเตอร์สุ่มเพื่อการดีบัก แบ่งข้อมูลตามหัวข้อหรือฉากก่อนทำ augmentation เพื่อไม่ให้ภาพที่เกี่ยวข้องรั่วไหลระหว่าง train และ test
เปรียบเทียบไม่มี augmentation, การเพิ่มภาพแบบง่าย, และนโยบายที่เสนอบนชุดทดสอบที่ไม่ได้แก้ไขและชุด stress ที่สมจริง ติดตามความแม่นยำต่อคลาส, การ localization, calibration, และตัวอย่างที่ล้มเหลว ไม่ใช่แค่ loss การฝึก การเพิ่มภาพเกินไปอาจทำให้โมเดล underfit การกระจายจริง, ในขณะที่การเพิ่มภาพอ่อนอาจกระตุ้นการเรียนรู้แบบ shortcut เวอร์ชัน pipeline พร้อมกับโมเดล, บันทึก seed ของการรันประเมิน, และหลีกเลี่ยงการใช้การแปลงแบบสุ่มใน validation หรือ inference ยกเว้นเมื่อมีการประเมิน test‑time augmentation อย่างตั้งใจ
สำหรับ detection และ segmentation, ตรวจสอบการคลิปพิกัด, พื้นที่กล่องขั้นต่ำ, การมองเห็นของ keypoint, และการทำ interpolation ที่ใช้กับมาสก์เชิงประเภท การทำ nearest‑neighbor interpolation มักจำเป็นสำหรับ ID ของคลาส, ในขณะที่ bilinear interpolation อาจสร้างป้ายที่ไม่ถูกต้อง โปรไฟล์ data loader ด้วย: การแปลงที่รุนแรงอาจทำให้ CPU augmentation กลายเป็นคอขวดการฝึก แคชเฉพาะการแปลงที่ deterministic และรักษาความสุ่มตามที่ตั้งใจข้าม epoch และ worker
รายการตรวจสอบการนำไปใช้จริง
เปลี่ยนแนวคิดให้เป็น workflow ที่มีขอบเขตและทดสอบได้: โหลดตัวอย่าง → เลือก → แปลง → จัดแนวเป้าหมาย → ฝึก → ตรวจสอบ ตั้งเจ้าของที่รับผิดชอบ, เอกสารข้อมูลและการพึ่งพา, สร้าง baseline อย่างง่าย, กำหนดเกณฑ์การยอมรับและหยุด, ทดสอบความล้มเหลวที่เป็นตัวแทน, และกำหนดการเฝ้าติดตาม, rollback, และการตรวจสอบก่อนขยายขอบเขต บันทึกเวอร์ชันและสมมติฐานเพื่อให้ทีมอื่นสามารถทำซ้ำผลลัพธ์และเข้าใจการเปลี่ยนแปลงได้
ก่อนเปิดใช้งาน, ดำเนินการตรวจสอบ readiness อย่างเป็นเอกสารกับผู้ที่สร้าง, ดำเนินการ, ปกป้อง, และได้รับผลกระทบจากระบบ ทดสอบกรณีปกติ, เงื่อนไขขอบเขต, ความล้มเหลวของการพึ่งพา, และการใช้งานผิดวิธี; เก็บรักษาหลักฐานและความเสี่ยงที่ยังไม่ได้แก้ไข กำหนดว่าใครสามารถอนุมัติการปล่อย, ปรับค่า threshold, แทนที่ผลลัพธ์, หรือหยุดการทำงานได้ ทบทวนการตัดสินใจหลังจากข้อมูลจริงเข้ามา เพราะการทดลอง pilot ที่ประสบความสำเร็จทางเทคนิคไม่ได้รับประกันประสิทธิภาพที่เชื่อถือได้ในระดับกว้าง
- IMAGE: รูปร่าง, สี, เบลอ, และสัญญาณรบกวน
- TARGETS: มาสก์, กล่อง, จุดสำคัญ, และป้ายกำกับ
- EVIDENCE: การตรวจสอบคุณภาพด้วยภาพและการประเมินแบบแยกส่วน
คำถามที่พบบ่อย
การเพิ่มภาพทำให้เกิด ground truth ใหม่หรือไม่?
ไม่ การเพิ่มภาพสร้างตัวอย่างการฝึกที่แปลงแล้วภายใต้สมมติฐานว่าป้ายยังคงถูกต้อง การแปลงที่ไม่สมจริงหรือป้ายไม่ถูกต้องจะทำให้เกิด noise
ควรทำการเพิ่มภาพในชุดตรวจสอบหรือไม่?
ใช้การปรับขนาดและ normalization แบบ deterministic ตามที่โมเดลต้องการ, แต่ให้การกระจายการประเมินคงที่ การเพิ่มภาพในช่วง test‑time เป็นวิธี inference แยกต่างหากและควรรายงานอย่างชัดเจน
แหล่งอ้างอิงหลัก












