มุมมองของ Anderson
จะรู้ได้อย่างไรว่าระบบสังเคราะห์ภาพกำลังสร้างผลงานต้นฉบับอย่างแท้จริง

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google

ประเด็นสำคัญคะแนน Rarity Score ของ KAIST และ NAVER…
ดูเพิ่มเติม
- คะแนน Rarity Score ของ KAIST และ NAVER วัดความเป็นต้นฉบับของภาพผ่านระยะห่างไปยังเพื่อนบ้านที่ใกล้ที่สุด
- ตัวชี้วัดที่มีอยู่ เช่น Truncation Trick ให้น้ำหนักกับความสมจริงมากกว่าความแปลกใหม่ในภาพที่สร้างขึ้น
- Rarity Score สามารถระบุผลลัพธ์ที่สร้างสรรค์อย่างแท้จริงจากระบบอย่าง DALL-E 2
งานวิจัยใหม่จากเกาหลีใต้เสนอวิธีตรวจสอบว่าระบบสังเคราะห์ภาพสร้างภาพใหม่อย่างแท้จริง หรือเพียงดัดแปลงข้อมูลฝึกเล็กน้อย ซึ่งอาจทำให้เป้าหมายของสถาปัตยกรรมเหล่านี้ในการสร้างภาพใหม่และเป็นต้นฉบับไม่บรรลุผล
บทความระบุว่ากรณีหลังเกิดขึ้นบ่อยมาก เพราะตัวชี้วัดที่ใช้ปรับปรุงความสามารถในการสร้างภาพระหว่างฝึกมีแนวโน้มบังคับให้ระบบชอบภาพที่ใกล้เคียงภาพต้นทางจริงในชุดข้อมูล
ท้ายที่สุด หากภาพที่สร้างขึ้นดูคล้ายข้อมูลต้นทาง ก็มีแนวโน้มได้คะแนนความสมจริงดีกว่าความเป็นต้นฉบับ เพราะมันซื่อตรงต่อต้นแบบ แม้อาจไม่สร้างสรรค์
ในสาขาที่ยังใหม่และยังไม่ผ่านการทดสอบจนเข้าใจผลทางกฎหมาย เรื่องนี้อาจ กลายเป็นประเด็นกฎหมายสำคัญ หากพบว่าภาพสังเคราะห์เชิงพาณิชย์แตกต่างจากต้นทางที่มักมีลิขสิทธิ์ไม่เพียงพอ ปัจจุบันข้อมูลเหล่านี้ ได้รับอนุญาตให้แพร่เข้าสู่ วงการวิจัยผ่านชุดข้อมูลยอดนิยมที่เก็บจากเว็บ ความเป็นไปได้ของข้อเรียกร้องการละเมิดเช่นนี้ เพิ่งได้รับความสนใจเมื่อไม่นานมานี้ ในกรณี GitHub Co-Pilot AI ของ Microsoft
สำหรับผลลัพธ์ที่สอดคล้องกันและมีความหมายชัดเจนขึ้นจากระบบอย่าง DALL-E 2 ของ OpenAI, Imagen ของ Google และ CogView จากจีน รวมถึง DALL-E mini ที่มีความสามารถต่ำกว่า ยังมีวิธีตรวจสอบความเป็นต้นฉบับของภาพอย่างน่าเชื่อถือ ภายหลังการสร้าง อยู่น้อยมาก
การค้นหาภาพ DALL-E 2 ใหม่ที่ได้รับความนิยมบางภาพ มักนำไปสู่เพียงสำเนาของภาพเดียวกันอีกหลายแห่ง ทั้งนี้ขึ้นอยู่กับเครื่องมือค้นหา

การอัปโหลดภาพ DALL-E 2 ทั้งชุดเก้าภาพนำไปสู่ภาพชุดอื่นจาก DALL-E 2 เท่านั้น เพราะโครงสร้างตารางเป็นลักษณะเด่นที่สุด เมื่อแยกภาพแรกออกมาอัปโหลด จาก โพสต์ Twitter นี้ ของบัญชี Weird Dall-E Generations เมื่อวันที่ 8 มิถุนายน 2022 Google กลับยึดติดกับลูกบาสเกตบอลในภาพ ทำให้การค้นหาด้วยภาพเข้าสู่ทางตันทางความหมาย สำหรับภาพเดียวกัน อย่างน้อย Yandex ดูเหมือนวิเคราะห์โครงสร้างระดับพิกเซลและจับคู่คุณลักษณะจริงๆ
แม้ Yandex มีแนวโน้มใช้ คุณลักษณะ ของภาพจริงมากกว่า Google Search กล่าวคือ คุณลักษณะ ที่สกัดหรือคำนวณจากภาพ ไม่จำเป็นต้องเป็นลักษณะใบหน้าของบุคคล และใช้ลักษณะ ทางสายตา มากกว่าความหมายเพื่อหาภาพคล้ายกัน แต่เครื่องมือค้นหาภาพทั้งหมดต่างมี เป้าหมายหรือแนวปฏิบัติบางอย่าง ที่อาจทำให้ตรวจพบการลอกเลียนแบบจาก ต้นทาง>ภาพที่สร้าง ผ่านการค้นเว็บได้ยาก
นอกจากนี้ ข้อมูลฝึกของโมเดลกำเนิดอาจไม่ได้เปิดเผยต่อสาธารณะทั้งหมด ยิ่งทำให้การตรวจสอบเชิงนิติวิทยาศาสตร์เกี่ยวกับความเป็นต้นฉบับของภาพยากขึ้น
ที่น่าสนใจคือ เมื่อค้นด้วยภาพสังเคราะห์ภาพหนึ่งที่ Google แสดงบน เว็บไซต์เฉพาะของ Imagen กลับไม่พบภาพที่เทียบเคียงกับเนื้อหาในภาพจากการพิจารณาตัวภาพและค้นหาภาพคล้ายกันอย่างเป็นกลาง ผลค้น Google Images ยังคงยึดติดกับความหมาย โดยไม่ยอมให้ค้นจากภาพล้วนๆ หากไม่เพิ่มคำค้น imagen google เป็นเงื่อนไขจำกัดเพิ่มเติม:

ตรงกันข้าม Yandex พบภาพจากโลกจริงจำนวนมากของชุมชนศิลปินสมัครเล่นที่คล้ายกันหรืออย่างน้อยสัมพันธ์กันทางสายตา:

โดยทั่วไป คงดีกว่าหากสามารถวัดความใหม่หรือความเป็นต้นฉบับของผลลัพธ์ระบบสังเคราะห์ภาพได้ โดยไม่ต้องสกัดคุณลักษณะจากทุกภาพที่เข้าถึงผ่านเว็บได้ในช่วงฝึกโมเดล หรือจากชุดข้อมูลปิดที่อาจใช้เนื้อหามีลิขสิทธิ์
เพื่อแก้ปัญหานี้ นักวิจัยจาก Kim Jaechul Graduate School of AI แห่ง Korea Advanced Institute of Science and Technology (KAIST AI) ร่วมกับบริษัทไอซีทีและการค้นหาระดับโลก NAVER Corp พัฒนา คะแนนความหายาก (Rarity Score) เพื่อช่วยระบุผลงานที่เป็นต้นฉบับมากขึ้นของระบบสังเคราะห์ภาพ

ภาพเหล่านี้สร้างด้วย StyleGAN-FFHQ คอลัมน์เรียงจากผลแย่ที่สุดไปดีที่สุดจากซ้ายไปขวา ตัวชี้วัด Truncation trick และความสมจริงมีเป้าหมายของตน ส่วนคะแนนความหายากใหม่ในแถวบนสุดค้นหาภาพที่ทั้งสอดคล้องและเป็นต้นฉบับ ไม่ใช่แค่สอดคล้องกัน เนื่องจากบทความจำกัดขนาดภาพ โปรดดูงานวิจัยต้นฉบับเพื่อรายละเอียดและความละเอียดที่สูงขึ้น ที่มา: https://arxiv.org/pdf/2206.08549.pdf
งานวิจัย ใหม่นี้มีชื่อว่า Rarity Score: A New Metric to Evaluate the Uncommonness of Synthesized Images หรือคะแนนความหายาก: ตัวชี้วัดใหม่สำหรับประเมินความไม่ธรรมดาของภาพสังเคราะห์ โดยนักวิจัยสามคนจาก KAIST และสามคนจาก NAVER Corp
ก้าวพ้นกลเม็ดง่ายๆ
ตัวชี้วัดเดิมที่งานวิจัยต้องการปรับปรุง ได้แก่ Truncation trick ซึ่ง เสนอในปี 2019 โดยความร่วมมือของ Heriot-Watt University ในสหราชอาณาจักรกับ DeepMind ของ Google
Truncation trick ใช้การแจกแจงแฝงสำหรับการสุ่มตัวอย่างต่างจากที่ใช้ฝึกโมเดลกำเนิด
ผู้พัฒนาประหลาดใจที่วิธีนี้ได้ผล แต่ยอมรับในงานเดิมว่าลดความหลากหลายของผลลัพธ์ ถึงกระนั้น มันมีประสิทธิภาพและได้รับความนิยมในฐานะกลเม็ดง่ายๆ เพื่อให้ภาพดูสมจริง โดยไม่ได้เรียนรู้ความเป็นไปได้ทั้งหมดในข้อมูล และอาจคล้ายต้นทางเกินกว่าที่ต้องการ
ผู้เขียนงานใหม่กล่าวถึง Truncation trick ว่า:
“วิธีนี้ไม่ได้มุ่งสร้างตัวอย่างหายากในชุดข้อมูลฝึก แต่สังเคราะห์ภาพทั่วไปได้อย่างเสถียรกว่า เราตั้งสมมติฐานว่าโมเดลกำเนิดปัจจุบันจะสร้างตัวอย่างที่ครอบคลุมการแจกแจงข้อมูลจริงได้มากขึ้น หากกระตุ้นให้ตัวสร้างผลิตตัวอย่างหายากอย่างมีประสิทธิภาพ”
เกี่ยวกับแนวโน้มพึ่งตัวชี้วัดดั้งเดิม เช่น Frechet Inception Distance (FID) ที่ ถูกวิจารณ์อย่างหนัก เมื่อเดือนธันวาคม 2021, Inception Score (IS) และ Kernel Inception Distance (KID) เป็นเครื่องชี้ความคืบหน้าระหว่างฝึก ผู้เขียนแสดงความเห็นเพิ่มเติมว่า*:
“รูปแบบการเรียนรู้นี้ทำให้ตัวสร้างไม่ค่อยสังเคราะห์ตัวอย่างหายากที่มีเอกลักษณ์และลักษณะเด่น ซึ่งมีสัดส่วนไม่มากในการแจกแจงภาพจริง ตัวอย่างหายากในชุดข้อมูลสาธารณะ ได้แก่ คนที่สวมเครื่องประดับต่างๆ ใน FFHQ, สัตว์สีขาวใน AFHQ และ รูปปั้นที่ไม่ธรรมดาใน Metfaces.
“ความสามารถสร้างตัวอย่างหายากสำคัญ ไม่เพียงเพราะเกี่ยวข้องกับขีดความสามารถสุดขอบของโมเดลกำเนิด แต่ยังเพราะเอกลักษณ์มีบทบาทสำคัญในการประยุกต์เชิงสร้างสรรค์ เช่น มนุษย์เสมือน
“อย่างไรก็ตาม ผลเชิงคุณภาพของงานวิจัยใหม่หลายชิ้นแทบไม่มีตัวอย่างหายากเหล่านี้ เราคาดว่าธรรมชาติของการเรียนรู้แบบแข่งขันบังคับให้การแจกแจงภาพที่สร้างคล้ายชุดข้อมูลฝึก ดังนั้นภาพที่มีเอกลักษณ์หรือความหายากชัดเจนจึงเป็นเพียงส่วนน้อยของภาพที่โมเดลสังเคราะห์”
เทคนิค
คะแนนความหายากใหม่ดัดแปลงแนวคิดที่เสนอใน งาน ก่อนหน้า คือใช้ เพื่อนบ้านใกล้ที่สุด K ตัว (KNN) แทนกลุ่มข้อมูลจริงสำหรับฝึกและข้อมูลสังเคราะห์ที่เป็นผลลัพธ์ในระบบสังเคราะห์ภาพ
ผู้เขียนอธิบายวิธีวิเคราะห์ใหม่นี้ว่า:
“เราตั้งสมมติฐานว่าตัวอย่างทั่วไปจะอยู่ใกล้กัน ส่วนตัวอย่างที่มีเอกลักษณ์และหายากจะกระจายห่างกันในปริภูมิคุณลักษณะ”
ภาพผลลัพธ์ด้านบนแสดงระยะเพื่อนบ้านใกล้ที่สุด (NND) จากน้อยไปมากในสถาปัตยกรรม StyleGAN ที่ฝึกด้วย FFHQ
“สำหรับทุกชุดข้อมูล ตัวอย่างที่มี NND ต่ำที่สุดแสดงภาพที่เป็นตัวแทนและพบได้ทั่วไป ในทางกลับกัน ตัวอย่างที่มี NND สูงที่สุดมีเอกลักษณ์มากและแตกต่างจากภาพทั่วไปที่มี NND ต่ำที่สุดอย่างมีนัยสำคัญ”
ในทางทฤษฎี การใช้ตัวชี้วัดนี้เป็นตัวแยกแยะหรือรวมไว้ในตัวแยกแยะที่ซับซ้อนกว่า อาจชี้นำระบบกำเนิดจากการเลียนแบบล้วนไปสู่อัลกอริทึมที่สร้างสรรค์ขึ้น พร้อมรักษาความสอดคล้องของแนวคิดสำคัญต่อภาพสมจริง เช่น ผู้ชาย, ผู้หญิง, รถยนต์, โบสถ์ เป็นต้น
การเปรียบเทียบและการทดลอง
ในการทดสอบ นักวิจัยเปรียบเทียบคะแนนความหายากกับ Truncation trick และ คะแนนความสมจริง ของ NVIDIA ปี 2019 พบว่าวิธีนี้สามารถแยกแยะผลลัพธ์ที่มีเอกลักษณ์ได้ในหลายกรอบระบบและหลายชุดข้อมูล
แม้ผลในงานวิจัยจะมากเกินกว่านำมาแสดงที่นี่ นักวิจัยดูเหมือนได้แสดงความสามารถของวิธีใหม่ในการระบุความหายากทั้งในภาพต้นทางจริงและภาพที่สร้างขึ้นในกระบวนการกำเนิด:
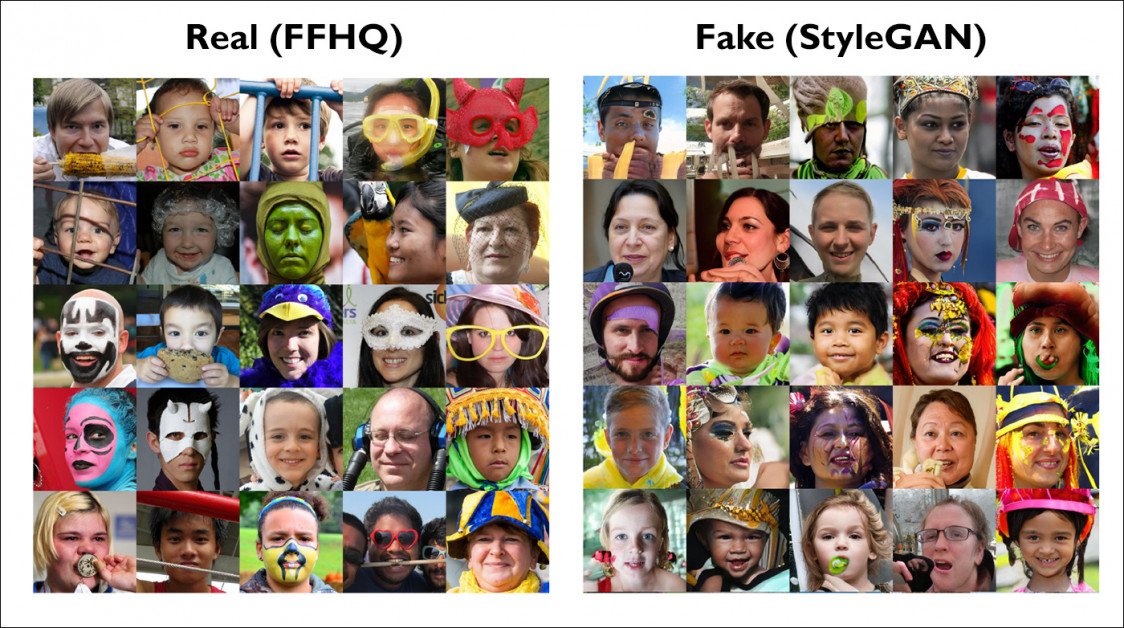
ตัวอย่างบางส่วนจากผลภาพจำนวนมากในงานวิจัย ดูแหล่งข้อมูลด้านบนเพื่อรายละเอียด ด้านซ้ายเป็นภาพจริงจาก FFHQ ซึ่งมีเพื่อนบ้านใกล้เคียงน้อยมากในชุดข้อมูลเดิม จึงใหม่และไม่ธรรมดา ด้านขวาเป็นภาพที่ StyleGAN สร้างซึ่งตัวชี้วัดใหม่ระบุว่าใหม่อย่างแท้จริง เนื่องจากบทความจำกัดขนาดภาพ โปรดดูงานต้นฉบับเพื่อรายละเอียดและความละเอียดที่สูงขึ้น
นักวิจัยกล่าวว่าคะแนนความหายากใหม่นี้ไม่ได้เพียงระบุผลลัพธ์ใหม่ในสถาปัตยกรรมเดียว แต่ยังเปรียบเทียบโมเดลกำเนิดต่างสถาปัตยกรรม เช่น autoencoder, VAE และ GAN ได้ด้วย
บทความระบุว่าคะแนนนี้ต่างจากตัวชี้วัดเก่า เพราะเน้นความสามารถของระบบกำเนิดในการสร้างภาพที่มีเอกลักษณ์และหายาก ขณะที่ตัวชี้วัดดั้งเดิมพิจารณาความหลากหลายระหว่างผลลัพธ์ระหว่างฝึกอย่างค่อนข้างจำกัด
เหนือกว่างานที่มีขอบเขตจำกัด
แม้นักวิจัยจะทดสอบระบบเฉพาะด้าน เช่น การจับคู่ตัวสร้างและชุดข้อมูลสำหรับสร้างภาพคนหรือแมว คะแนนความหายากอาจใช้กับการสังเคราะห์ภาพใดก็ได้ที่ต้องการระบุผลลัพธ์ซึ่งใช้การแจกแจงที่เรียนรู้จากข้อมูลฝึก แทนการเพิ่มความสมจริงและลดความหลากหลายด้วยการแทรกการแจกแจงแฝงจากภายนอก หรือใช้ทางลัดที่แลกความใหม่กับความสมจริง
ตัวชี้วัดนี้จึงอาจแยกผลลัพธ์ใหม่อย่างแท้จริงในระบบอย่าง DALL-E โดยใช้ระยะห่างที่ตรวจพบระหว่างผลลัพธ์ซึ่งดูเป็นค่าผิดกลุ่ม ข้อมูลฝึก และผลจากคำสั่งหรืออินพุตคล้ายกัน เช่น คำสั่งที่ใช้ภาพ
ในทางปฏิบัติ เรายังไม่เข้าใจชัดว่าระบบเรียนรู้แนวคิดทางภาพและความหมายจริงเพียงใด เพราะข้อมูลเกี่ยวกับชุดฝึกมักจำกัด แต่วิธีนี้อาจใช้ระบุช่วงเวลาแห่งแรงบันดาลใจจริงของระบบกำเนิดได้ คือจุดที่แนวคิดและข้อมูลอินพุตมีจำนวนเพียงพอให้เกิดสิ่งที่สร้างสรรค์อย่างแท้จริง แทนผลลัพธ์ที่ดัดแปลงมากเกินไปหรือใกล้ต้นทางเกินไป
* ผู้เขียนแปลงการอ้างอิงในเนื้อหาของนักวิจัยเป็นไฮเปอร์ลิงก์
เผยแพร่ครั้งแรกเมื่อวันที่ 20 มิถุนายน 2022