พื้นฐาน AI
การเขียนโค้ดและ AI: เส้นทางสำหรับผู้เริ่มต้นสู่ปัญญาประดิษฐ์

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google
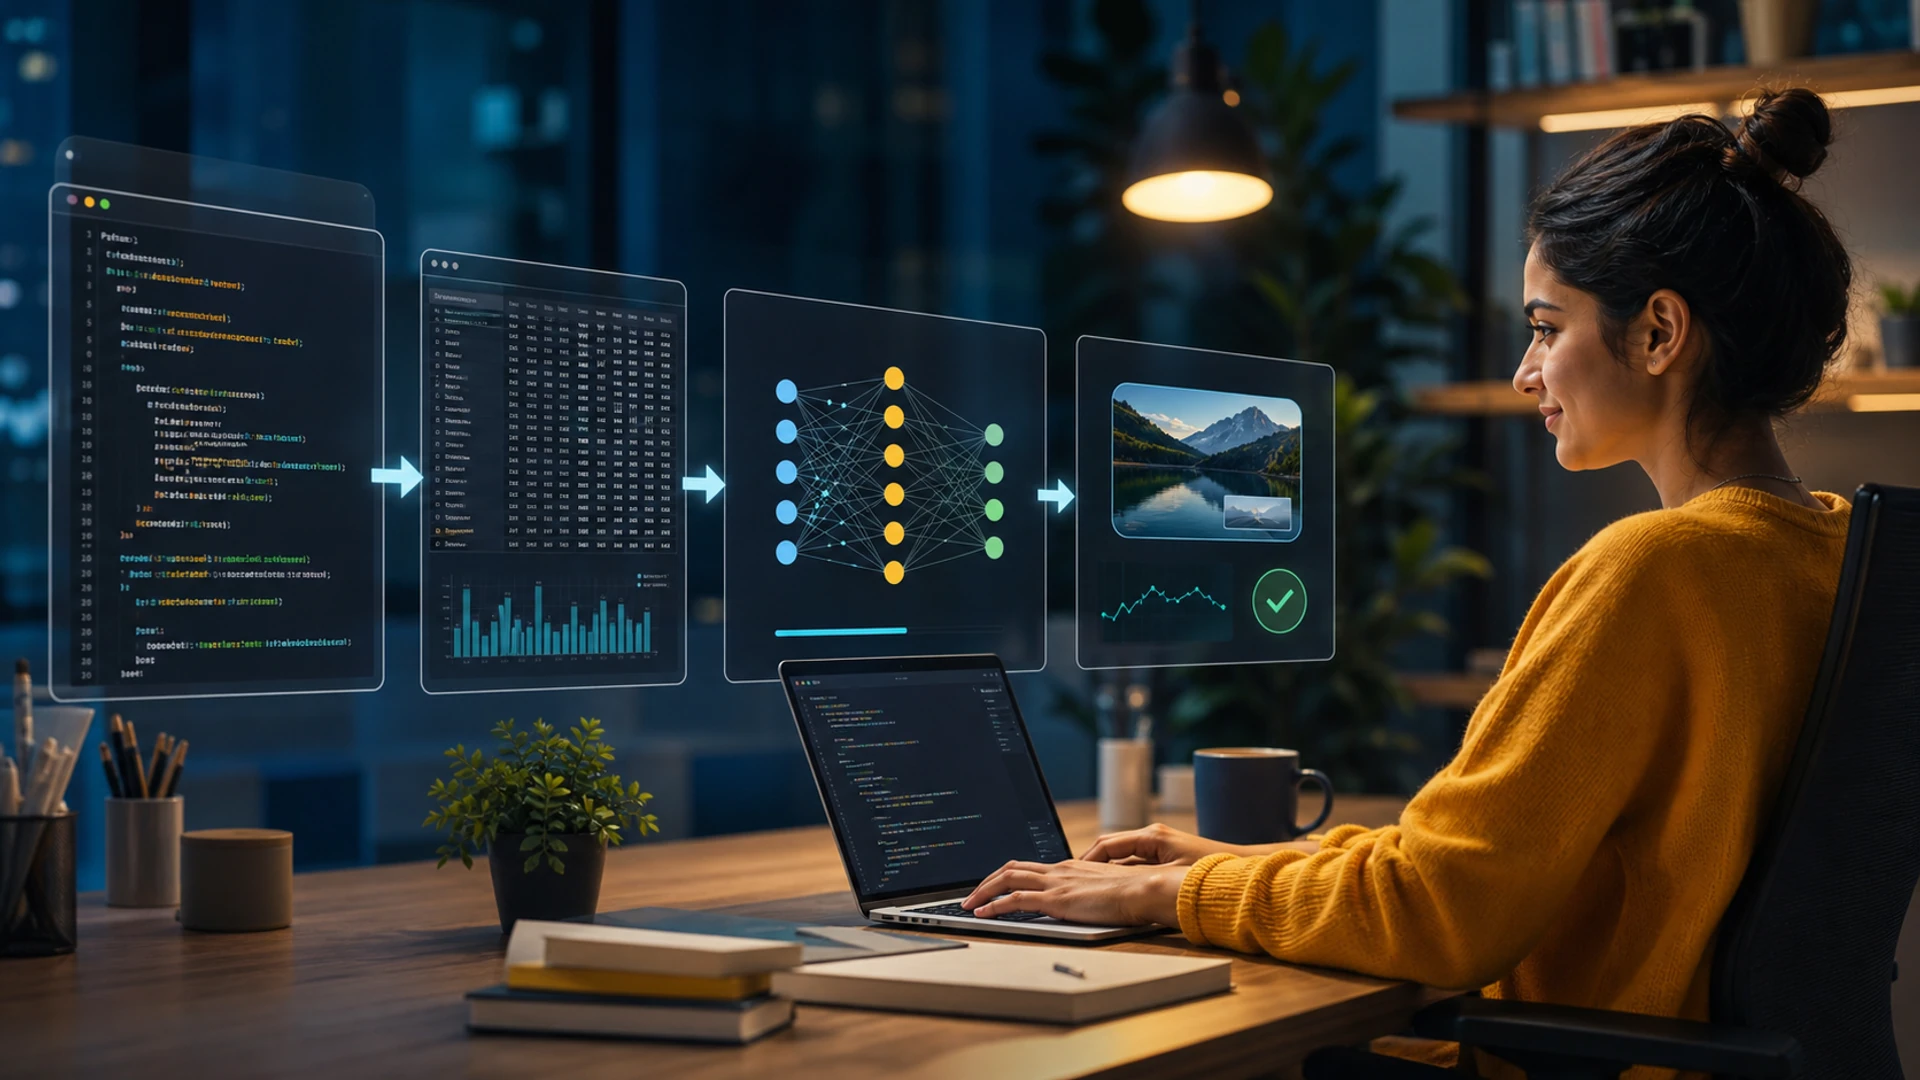
คุณสามารถเริ่มเรียนรู้ AI ได้แม้ไม่มีประสบการณ์การเขียนโปรแกรมระดับมืออาชีพมาก่อน แต่การสร้างระบบที่เชื่อถือได้ในที่สุดต้องอาศัยทักษะการเขียนโค้ด, ข้อมูล, และการประเมินผลที่เพียงพอเพื่อสังเกตว่าทูลส์กำลังทำอะไรอยู่ เส้นทางที่เร็วที่สุดคือการทำโครงการเล็ก ๆ ที่เชื่อมโยงกับพื้นฐาน แทนการท่องเที่ยวผ่านบทเรียนที่แยกจากกันเป็นจำนวนมาก
การเขียนโค้ดที่ได้รับความช่วยเหลือจาก AI สามารถอธิบายไวยากรณ์, สร้างตัวอย่าง, และช่วยดีบักได้ ให้ถือผลลัพธ์ของมันเป็นร่าง: รันมัน, ทดสอบมัน, อ่านเอกสาร, และทำความเข้าใจข้อมูลและสิทธิ์การเข้าถึงก่อนที่จะเชื่อถือ
Key takeaways
- เรียนรู้พื้นฐาน Python, โน้ตบุ๊ก, Git, คำสั่งบรรทัด, และวิธีอ่านข้อผิดพลาด
- สร้างโครงการการเรียนรู้แบบมีผู้สอนขนาดเล็กหนึ่งโครงการก่อนที่จะกระโดดไปสู่เอเจนต์หรือโมเดลขนาดใหญ่
- ใช้ข้อมูลการฝึก, validation, และทดสอบอย่างถูกต้อง; เปรียบเทียบกับ baseline อย่างง่าย
- ให้ AI ช่วยในลูปการให้ข้อเสนอแนะ, แต่ตรวจสอบโค้ด, แหล่งที่มา, ไลเซนส์, ความปลอดภัย, และผลลัพธ์ด้วยตนเอง
Stage 1: programming foundations
เรียนรู้ตัวแปร, โครงสร้างข้อมูล, เงื่อนไข, ลูป, ฟังก์ชัน, โมดูล, ไฟล์, สภาพแวดล้อม, และข้อยกเว้น ฝึกอ่านไฟล์ CSV, แปลงข้อมูล, เรียก API ที่มีเอกสาร, เขียนการทดสอบ, และใช้ Git เพื่อติดตามการเปลี่ยนแปลง
คุณไม่จำเป็นต้องมีคณิตศาสตร์ระดับสูงก่อนเขียนโค้ด, แต่ควรเรียนรู้ความน่าจะเป็นพื้นฐาน, เวกเตอร์, ค่าเฉลี่ย, การกระจาย, และกราฟเมื่อจำเป็น การคิดเชิงคอมพิวเตอร์ช่วยแปลงเป้าหมายที่คลุมเครือให้เป็นขั้นตอนที่สามารถทดสอบได้
Stage 2: a complete ML project
เลือกชุดข้อมูลสาธารณะขนาดเล็กและคำถามการทำนายที่ชัดเจน สำรวจข้อมูล, สร้างการแบ่งชุดอิสระ, สร้าง baseline, ฝึกโมเดลง่าย ๆ, ตรวจสอบข้อผิดพลาด, และบันทึกข้อจำกัด ใช้ scikit-learn ก่อนจะสร้างเครือข่ายประสาทเทียรกำหนดเองเมื่อเหมาะสม
โครงการนี้ทำให้แนวคิดการเรียนรู้ของเครื่องเป็นรูปธรรม: ฟีเจอร์, ป้ายกำกับ, การรั่วไหลของข้อมูล, การฝึกเกิน, ตัวชี้วัด, ความสามารถในการทำซ้ำ, และความแตกต่างระหว่างคะแนนโมเดลกับการตัดสินใจที่มีประโยชน์
Stage 3: deep learning and language models
เรียนรู้เทนเซอร์, แบตช์, การสูญเสีย, การลดลงของกราเดียนต์, และการย้อนกลับผ่านโมเดลภาพหรือข้อความขนาดเล็ก จากนั้นใช้โมเดลที่ผ่านการฝึกล่วงหน้าผ่าน API หรือไลบรารีเปิด, บันทึกพรอมต์และเวอร์ชัน, และเปรียบเทียบกับวิธีที่ง่ายกว่า
สำรวจ Generative AI ผ่านแอปพลิเคชันที่จำกัดด้วยการดึงข้อมูลหรือการใช้เครื่องมือ เพิ่มการตรวจสอบ, การอ้างอิง, สิทธิ์การเข้าถึง, และกลไกสำรองเพื่อให้โครงการสอนวิศวกรรมระบบพร้อมกับการสร้างพรอมต์
Use AI coding assistants deliberately
ขอให้สร้างฟังก์ชันเล็ก ๆ, การทดสอบ, คำอธิบาย, กรณีขอบ, และอ้างอิงเอกสาร รันการตรวจสอบแบบสถิตและการทดสอบ, ตรวจสอบการเปลี่ยนแปลงของ dependencies, และอย่าวางข้อมูลลับหรือข้อมูลส่วนตัวโดยไม่ได้รับอนุญาต หากคุณไม่สามารถอธิบายบรรทัดสำคัญได้ ให้ชะลอการทำงาน
พอร์ตโฟลิโอที่มีประโยชน์ควรแสดงคำถาม, สิทธิ์ข้อมูล, baseline, วิธีการ, การประเมิน, ข้อผิดพลาด, และสิ่งที่คุณจะปรับปรุง โครงการขนาดเล็กที่เสร็จสมบูรณ์และมีเอกสารแสดงถึงการตัดสินใจที่ดีกว่าการคัดลอกโค้ดจากเดโมขนาดใหญ่
A practical learning path from problem to prototype
เริ่มต้นด้วยงานเฉพาะและชุดตัวอย่างที่เป็นตัวแทนขนาดเล็ก แทนความตั้งใจกว้างขวางในการ ‘เรียนรู้ AI’ การจำแนกข้อความสนับสนุน, การดึงข้อมูลฟิลด์ใบแจ้งหนี้, หรือการตอบคำถามจากเอกสารที่ได้รับการอนุมัติ ให้ผลลัพธ์ที่สังเกตได้และผลลัพธ์ที่ชัดเจน เขียนลักษณะของผลลัพธ์ที่ดีก่อนเลือกโมเดลหรือเครื่องมือ
อินเทอร์เฟซแบบไม่ต้องเขียนโค้ดสามารถสอนการสร้างพรอมต์, การเตรียมข้อมูล, การประเมินผล, และการออกแบบกระบวนการทำงานได้ แต่ไม่สามารถแทนที่ความต้องการในการตัดสินใจทางเทคนิคได้ เรียนรู้ตาราง, ไฟล์, API, การยืนยันตัวตน, ตัวแปร, เงื่อนไข, และสถิติพื้นฐาน แนวคิดเหล่านี้อธิบายว่าข้อมูลเคลื่อนที่อย่างไร, ทำไมการบูรณาการล้มเหลว, และผลลัพธ์ของโมเดลหมายความว่าอย่างไร—และไม่หมายความว่าอย่างไร
สร้าง baseline ด้วยกฎง่าย ๆ, วิธีการค้นหา, สเปรดชีต, หรือโมเดลขนาดเล็ก จากนั้นเปรียบเทียบวิธีการ AI บนกรณีทดสอบเดียวกัน Baseline จะเปิดเผยว่าความซับซ้อนเพิ่มคุณค่าหรือไม่และให้ผู้เริ่มต้นมีเป้าหมายการดีบักที่เป็นรูปธรรม แยกข้อมูลทดสอบออกจากตัวอย่างที่ใช้กำหนดค่า หรือสร้างพรอมต์ให้ระบบ
Prompting, APIs, and the transition to code
พรอมต์ที่มีประโยชน์ต้องระบุงาน, บริบทที่เกี่ยวข้อง, ข้อจำกัด, โครงสร้างผลลัพธ์, และตัวอย่างเมื่อจำเป็น การเปลี่ยนแปลงพรอมต์คือการเปลี่ยนแปลงซอฟต์แวร์: ให้เวอร์ชัน, ทดสอบกับชุดการประเมินที่คงที่, และตรวจสอบความล้มเหลว อย่าพิจารณาคำอธิบายที่คล่องแคล่วจากโมเดลเป็นหลักฐานว่าคำตอบหรือข้อมูลอ้างอิงถูกต้อง
เครื่องมือสร้าง workflow เชื่อมการเรียกโมเดลกับฟอร์ม, ฐานข้อมูล, ไฟล์, และแอปพลิเคชันธุรกิจ เข้าใจว่าข้อมูลแต่ละขั้นตอนส่งไปยังบุคคลที่สามอย่างไร, การจัดเก็บข้อมูลรับรองเป็นอย่างไร, และเกิดอะไรขึ้นเมื่อหมดเวลา หรือทำการลองใหม่ เพิ่มการตรวจสอบอินพุต, ผลลัพธ์ที่มีโครงสร้าง, ขีดจำกัดอัตราการใช้, การอนุมัติจากมนุษย์, และบันทึกก่อนนำต้นแบบไปใช้กับผู้ใช้จริง
โค้ดจะมีคุณค่าเมื่อ workflow ต้องการตรรกะที่กำหนดเอง, การทดสอบที่ทำซ้ำได้, การขยายขนาด, ประสิทธิภาพ, ความพกพา, หรือการควบคุมความปลอดภัยอย่างละเอียด Python และ JavaScript เป็นจุดเริ่มต้นที่พบบ่อย แต่ภาษานั้นสำคัญน้อยกว่าพื้นฐาน: ฟังก์ชัน, โครงสร้างข้อมูล, แพคเกจ, ข้อผิดพลาด, การควบคุมเวอร์ชัน, และการทดสอบ ใช้โค้ดที่สร้างขึ้นเฉพาะหลังจากอ่านและรันอย่างปลอดภัย
Portfolio projects, evaluation, and career development
โครงการเริ่มต้นที่แข็งแกร่งควรบันทึกปัญหา, ผู้ใช้, สิทธิ์ข้อมูล, baseline, สถาปัตยกรรม, ชุดการประเมิน, ตัวชี้วัด, ความล้มเหลว, ความเสี่ยง, และขั้นตอนต่อไป อินเทอร์เฟซที่สวยงามแต่ไม่มีการประเมินแสดงผลน้อยกว่าการทดลองขนาดเล็กที่ทำซ้ำได้ ควรลบข้อมูลส่วนตัวและความลับก่อนเผยแพร่โค้ด, ภาพหน้าจอ, พรอมต์, หรือบันทึก
ประเมินความสำเร็จของงานแทนความประทับใจของโมเดล การจำแนกต้องการความแม่นยำและการเรียกคืนเฉพาะคลาส; การสกัดต้องการความแม่นยำของฟิลด์; การดึงข้อมูลต้องการการครอบคลุมของหลักฐาน; การสร้างต้องการความเป็นจริง, ความมีประโยชน์, ความปลอดภัย, ความหน่วง, และต้นทุน ตรวจสอบประสิทธิภาพในหลายภาษา, กรณีขอบ, และกลุ่มที่ได้รับผลกระทบ, และกำหนดว่าเมื่อใดที่มนุษย์ต้องตัดสินใจ
งาน AI รวมถึงการจัดการผลิตภัณฑ์, ความเชี่ยวชาญด้านโดเมน, การดำเนินงานข้อมูล, การประเมินผล, การออกแบบ, ความปลอดภัย, นโยบาย, และการจัดการการเปลี่ยนแปลง รวมถึงการพัฒนาโมเดล สร้างความลึกในหนึ่งโดเมนและความรู้ทางเทคนิคที่เพียงพอเพื่อทำงานร่วมกันระหว่างบทบาทต่าง ๆ พอร์ตโฟลิโอที่น่าเชื่อถืออธิบายการแลกเปลี่ยนและข้อจำกัดแทนการนำเสนอทุกต้นแบบว่าเป็นระบบอัตโนมัติพร้อมผลิต
Worked example: a beginner builds a document triage assistant
ผู้เรียนรวบรวมชุดเอกสารสาธารณะหรือที่ได้รับอนุญาตขนาดเล็กและกำหนดสามประเภทพร้อมผลลัพธ์ ‘ไม่แน่ใจ’ พวกเขาติดป้ายตัวอย่างโดยใช้กฎเป็นลายลักษณ์อักษร, แยกชุดทดสอบ, และสร้าง baseline ด้วยคีย์เวิร์ดในสเปรดชีต โมเดลแบบไม่ต้องเขียนโค้ดหรือ API จะส่งคืนประเภทที่มีโครงสร้างและระดับความมั่นใจ ซึ่งจะเปรียบเทียบกับกรณีเดียวกัน ตัวอย่างที่ไม่ถูกต้องและคลุมเครือจะกลายเป็นวัสดุการเรียนรู้ ไม่ใช่สิ่งที่ซ่อนอยู่ในเดโม
เวิร์กโฟลว์รับไฟล์, ดึงข้อความ, ลบรูปแบบที่ไม่รองรับ, เรียกโมเดลด้วยสคีมาที่กำหนด, ตรวจสอบการตอบกลับ, และส่งกรณีที่ไม่แน่ใจไปยังการตรวจสอบ เก็บเฉพาะฟิลด์ที่จำเป็นและไม่เคยใส่ข้อมูลรับรองในพรอมต์หรือภาพหน้าจอที่แชร์ ผู้เรียนบันทึกชื่อโมเดล, เวอร์ชันพรอมต์, ความหน่วง, ค่าใช้จ่าย, และผลลัพธ์ เพื่อให้การเปลี่ยนแปลงสามารถทดสอบได้แทนการตัดสินจากความจำ
รายงานพอร์ตโฟลิโอระบุความแม่นยำและการเรียกคืนต่อคลาส, สมมติฐานความเป็นส่วนตัว, ตัวอย่างความล้มเหลว, และขอบเขตระหว่างต้นแบบและการผลิต ขั้นตอนการเขียนโค้ดต่อไปอาจแทนที่การบูรณาการแบบแมนนวลที่เปราะบางด้วยฟังก์ชันหรือ API ขนาดเล็กที่ทดสอบแล้ว การพัฒนานี้สอนทักษะที่โอนย้ายได้: การกำหนดปัญหา, คุณภาพข้อมูล, การประเมิน, อินเทอร์เฟซ, การจัดการข้อผิดพลาด, ความปลอดภัย, และการสื่อสาร พื้นฐานเหล่านี้สำคัญกว่าการอ้างว่าตนสร้างเอเจนต์ซับซ้อนได้หลังจากตัวอย่างสำเร็จหนึ่งครั้ง
Practical implementation checklist
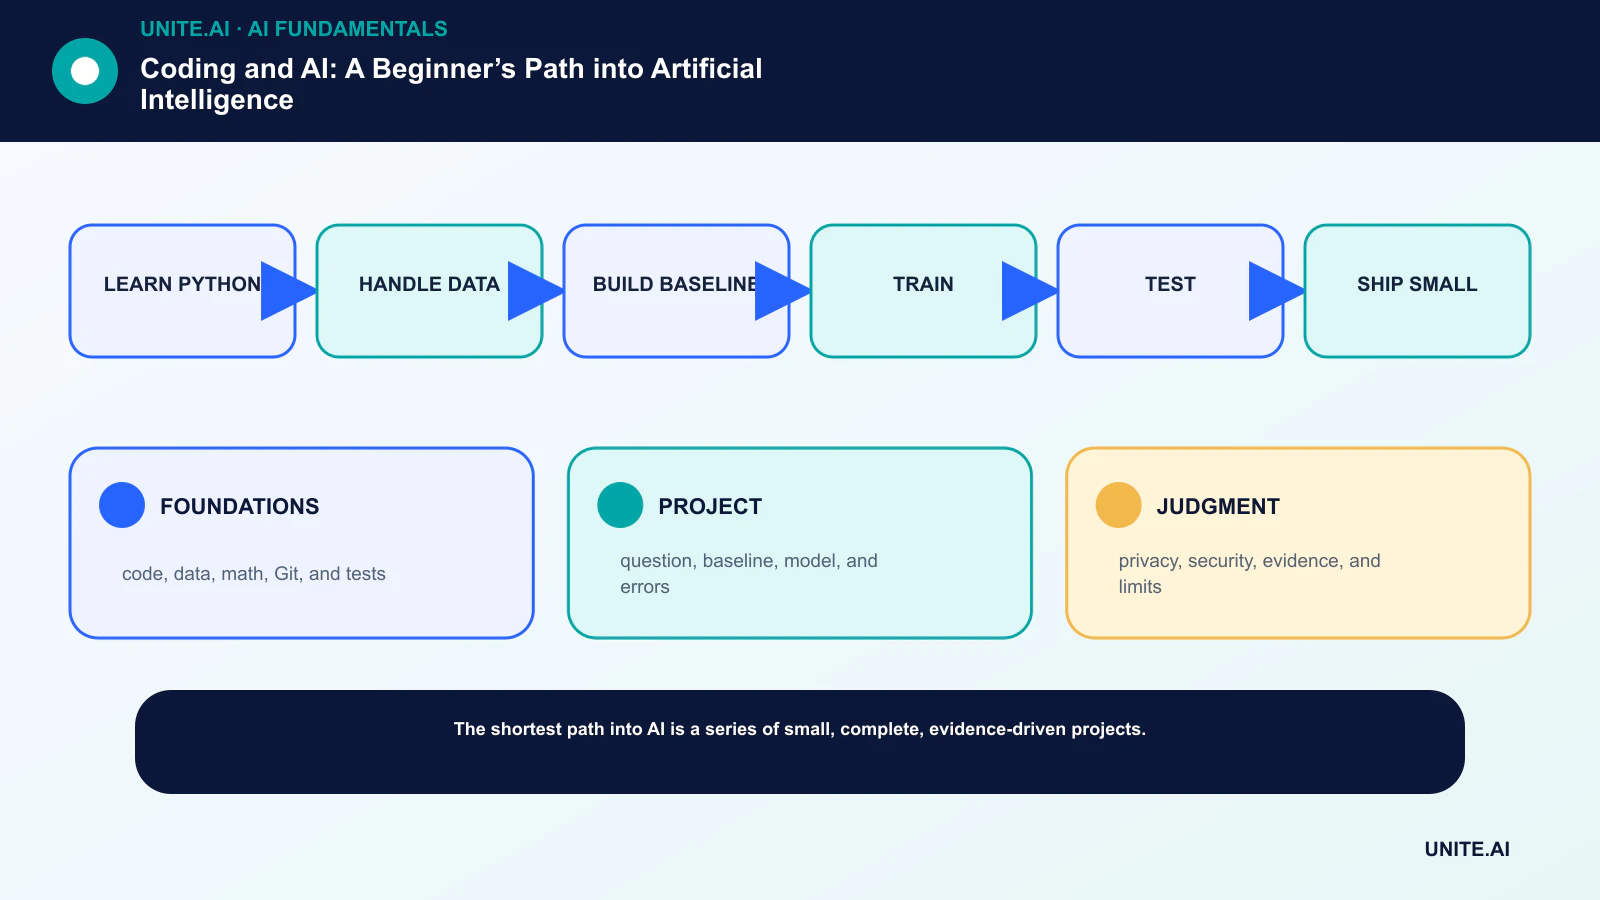
เปลี่ยนแนวคิดให้เป็นเวิร์กโฟลว์ที่จำกัดและทดสอบได้: เรียนรู้ python → จัดการข้อมูล → สร้าง baseline → ฝึก → ทดสอบ → ปล่อยขนาดเล็ก กำหนดเจ้าของที่รับผิดชอบ, บันทึกข้อมูลและ dependencies, สร้าง baseline อย่างง่าย, ตั้งเกณฑ์การยอมรับและหยุด, ทดสอบความล้มเหลวที่เป็นตัวแทน, และกำหนดการเฝ้าระวัง, การย้อนกลับ, และการตรวจสอบก่อนขยายขอบเขต บันทึกเวอร์ชันและสมมติฐานเพื่อให้ทีมอื่นสามารถทำซ้ำผลลัพธ์และเข้าใจการเปลี่ยนแปลง
ก่อนเปิดใช้งาน ให้ดำเนินการตรวจสอบความพร้อมที่บันทึกไว้กับผู้ที่สร้าง, ดำเนินการ, ปกป้อง, และได้รับผลกระทบจากระบบ ทดสอบกรณีปกติ, เงื่อนไขขอบเขต, ความล้มเหลวของ dependencies, และการใช้งานผิดวิธี; เก็บหลักฐานและความเสี่ยงที่ยังไม่ได้แก้ กำหนดว่าใครสามารถอนุมัติการปล่อย, ปรับค่าเกณฑ์, แทนที่ผลลัพธ์, หรือหยุดการทำงานได้ ทบทวนการตัดสินใจเมื่อข้อมูลจากโลกจริงเข้ามา เพราะการทดลองที่ประสบความสำเร็จทางเทคนิคไม่ได้รับประกันประสิทธิภาพที่เชื่อถือได้เมื่อขยายขนาด
- FOUNDATIONS: โค้ด, ข้อมูล, คณิตศาสตร์, Git, และการทดสอบ.
- PROJECT: คำถาม, baseline, โมเดล, และข้อผิดพลาด.
- JUDGMENT: ความเป็นส่วนตัว, ความปลอดภัย, หลักฐาน, และขีดจำกัด.
Frequently asked questions
Do I need a computer science degree to work in AI?
ไม่ จำเป็นต้องมี ปริญญาในสาขาวิทยาการคอมพิวเตอร์ งานต่าง ๆ รวมถึงวิศวกรรม, การวิจัย, ผลิตภัณฑ์, การออกแบบ, ปฏิบัติการ, ข้อมูล, การประเมิน, นโยบาย, และความเชี่ยวชาญด้านโดเมน แต่ละตำแหน่งมีระดับความต้องการการเขียนโค้ดที่แตกต่างกัน
Which programming language should a beginner learn?
Python เป็นตัวเลือกแรกที่เหมาะสม เนื่องจากไวยากรณ์ของมันเข้าใจง่ายและระบบนิเวศข้อมูลและ ML มีความหลากหลาย ทักษะการแก้ปัญหาเบื้องต้นสามารถโอนย้ายไปยังภาษาอื่นได้
Primary references