
พื้นฐาน AI
Generative AI คืออะไร?

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google
Generative AI หมายถึงโมเดลที่เรียนรู้รูปแบบจากข้อมูลและสร้างข้อความ, ภาพ, เสียง, วิดีโอ, โค้ด หรือการแสดงผลอื่น ๆ ใหม่เมื่อได้รับเงื่อนไขจากคำสั่งหรือ ตัวอย่าง ผลลัพธ์ถูกสังเคราะห์จากโมเดลความน่าจะเป็น; ไม่ได้ดึงข้อมูลแบบครบถ้วนจากฐานข้อมูล แม้ว่าจะมีเครื่องมือการดึงข้อมูลที่สามารถให้หลักฐานภายนอกได้
โมเดลตระกูลต่าง ๆ สร้างผลลัพธ์ด้วยวิธีที่แตกต่างกัน Autoregressive transformers พยากรณ์ลำดับหนึ่งโทเคนต่อครั้ง, diffusion models ลดสัญญาณรบกวนของตัวอย่างอย่างต่อเนื่อง, และ generative adversarial networks เรียนรู้ผ่านการแข่งขันระหว่างตัวสร้างและตัวตรวจสอบ
ประเด็นสำคัญ
- การสร้างเป็นการสุ่มตัวอย่างตามเงื่อนไขจากการกระจายที่เรียนรู้, ไม่ได้รับประกันว่าจะเรียกคืนความจริงได้
- Transformers, diffusion models, GANs และ variational autoencoders มีการแลกเปลี่ยนข้อได้เปรียบที่แตกต่างกัน
- การดึงข้อมูลและเครื่องมือสามารถทำให้ระบบมีพื้นฐานได้, แต่ผลลัพธ์และการอนุญาตของพวกมันยังต้องได้รับการตรวจสอบ
- การจัดการความเสี่ยงครอบคลุมข้อมูล, โมเดล, อินเทอร์เฟซ, การปรับใช้, การเฝ้าติดตามและที่มาของเนื้อหา
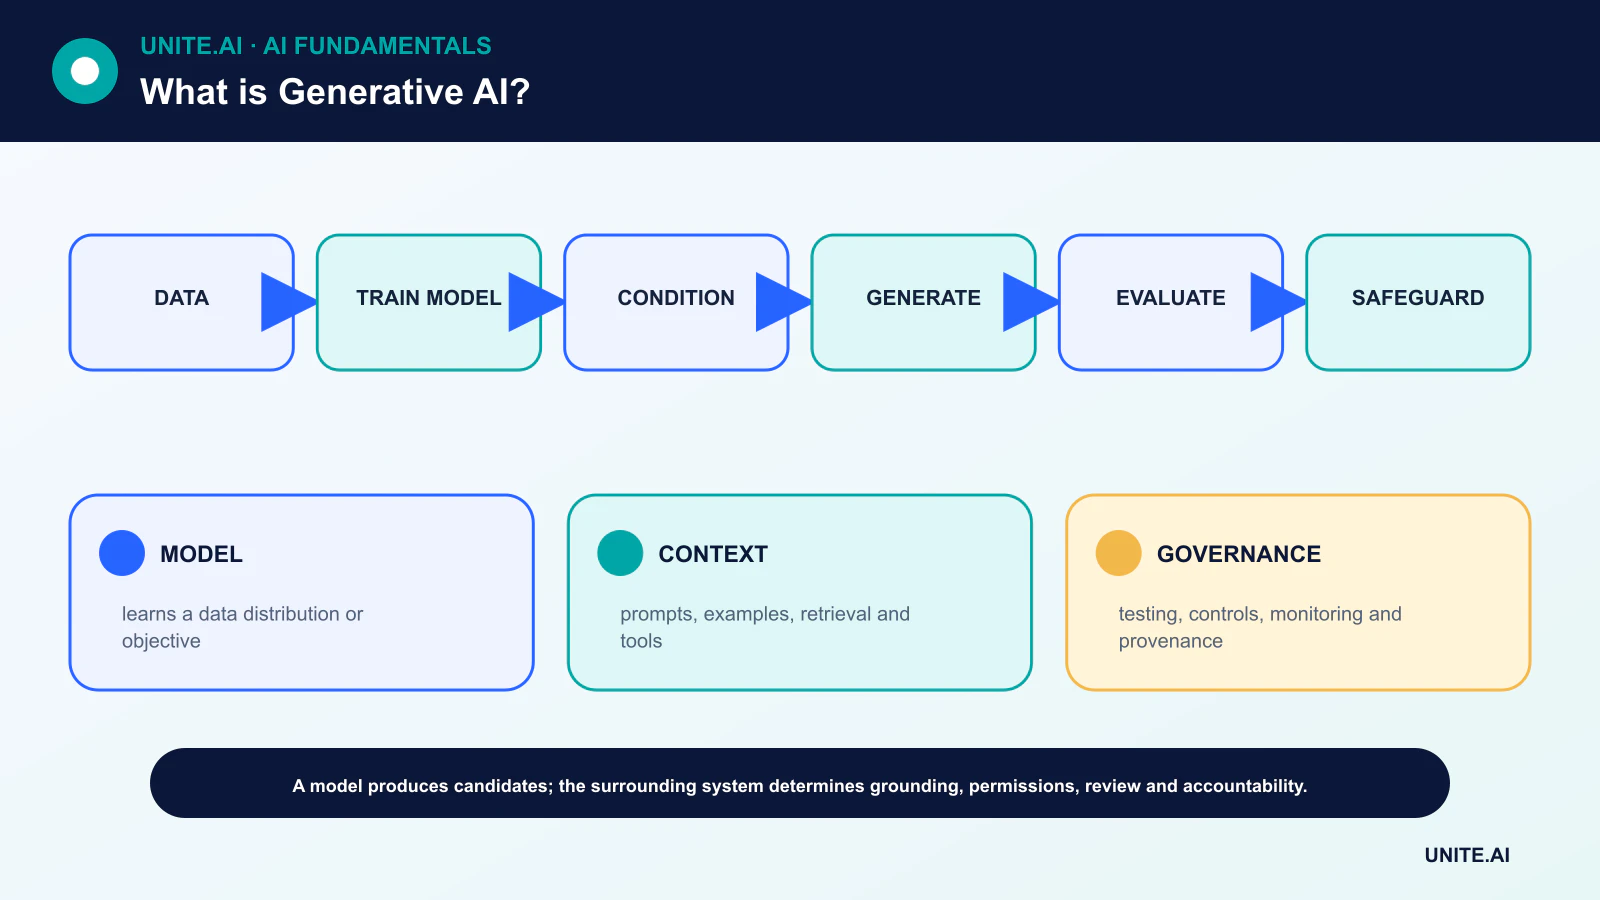
โมเดลสร้างเรียนรู้อย่างไร
วัตถุประสงค์ของการฝึกมอบรางวัลให้โมเดลที่พยากรณ์หรือสร้างรูปแบบจากตัวอย่างได้ โมเดลภาษาประมาณค่าโทเคนถัดไป; diffusion model เรียนรู้การย้อนกระบวนการรบกวน; variational autoencoder เรียนรู้การกระจายแฝงที่มีโครงสร้างและตัวถอดรหัส
การฝึกนี้สร้างการทั่วไปเชิงสถิติ, แต่ก็อาจทำให้เกิดอคติ, จำลำดับที่หายาก หรือทำงานล้มเหลวเมื่ออยู่นอกการกระจายของข้อมูล เอกสารชุดข้อมูล, การลบข้อมูลซ้ำ, การควบคุมความเป็นส่วนตัวและการประเมินผลบนข้อมูลที่แยกไว้จึงมีความสำคัญก่อนการนำไปใช้
ตระกูลสถาปัตยกรรมหลัก
Autoregressive transformers ครองตลาดข้อความและสนับสนุนลำดับหลายรูปแบบ Diffusion models ถูกใช้อย่างกว้างขวางสำหรับการสร้างภาพและเสียงคุณภาพสูง GANs สามารถสร้างตัวอย่างที่คมชัดและระบบภาพที่ควบคุมได้แต่การฝึกอาจยาก
Variational autoencoders ให้การสร้างโมเดลตัวแปรแฝงและการแทนค่าที่มีประสิทธิภาพ, บางครั้งทำงานภายในกระบวนการสร้างที่ใหญ่ขึ้น ผลิตภัณฑ์จริงมักผสมหลายโมเดลพร้อมการดึงข้อมูล, ตัวกรอง, เครื่องมือและโค้ดที่กำหนดได้
การกำหนดเงื่อนไข, การสุ่มตัวอย่างและการควบคุม
พรอมต์, ป้ายคลาส, ภาพ, คลิปเสียง หรือบันทึกโครงสร้างสามารถกำหนดเงื่อนไขการสร้างได้ พารามิเตอร์การสุ่มตัวอย่างปรับความหลากหลายและความกำหนดค่า อุณหภูมิต่ำจะทำให้ความน่าจะเป็นของโทเคนกระจุกตัว, แต่ไม่ได้ทำให้คำตอบที่ผิดกลายเป็นความจริง
การควบคุมดีขึ้นเมื่อระบบใช้สคีมาที่ชัดเจน, การถอดรหัสที่จำกัด, เอกสารอ้างอิงและการตรวจสอบ Prompt engineering ปรับเปลี่ยนบริบท; การปรับจูนละเอียดเปลี่ยนพารามิเตอร์; การดึงข้อมูลให้ข้อมูลภายนอก แต่ละวิธีแก้ไขรูปแบบความล้มเหลวที่แตกต่างกัน
การประเมินต้องอิงตามการใช้งาน
ระบบข้อความอาจต้องการความถูกต้องของข้อเท็จจริง, การทำงานสำเร็จ, การอ้างอิง, การตรวจสอบความเป็นพิษและการสอบเทียบ ระบบภาพหรือเสียงอาจต้องการความเที่ยงตรง, การสอดคล้องเชิงความหมาย, ความหลากหลาย, ความปลอดภัยของอัตลักษณ์และการตรวจสอบตามการรับรู้ จับคู่เมตริกอัตโนมัติกับการประเมินมนุษย์ที่เป็นตัวแทน
สร้างชุดการประเมินที่มีเวอร์ชันรวมกรณีทั่วไป, หายาก, แรงกดดันและกรณีที่เกี่ยวข้องกับนโยบาย ติดตามความหน่วง, ค่าใช้จ่ายและพฤติกรรมการปฏิเสธรวมถึงคุณภาพของผลลัพธ์ การสาธิตที่เลือกโดยผู้สร้างไม่ใช่หลักฐานของความน่าเชื่อถือระดับประชากร
ความเสี่ยง, มาตรการป้องกันและที่มาของข้อมูล
ความเสี่ยงสำคัญรวมถึงการหลอน, การฉีดพรอมต์, เนื้อหาเป็นอันตราย, การปลอมตัว, การใช้เครื่องมือที่ไม่ปลอดภัย, การรั่วไหลของความเป็นส่วนตัว, ข้อพิพาทลิขสิทธิ์, ความลำเอียงของระบบอัตโนมัติและห่วงโซ่อุปทานที่ไม่โปร่งใส NIST’s Generative AI Profile จัดระเบียบการดำเนินการผ่านการกำกับดูแล, ที่มาของเนื้อหา, การทดสอบก่อนการปรับใช้และการเปิดเผยเหตุการณ์
ใช้เครื่องมือที่มีสิทธิ์น้อยที่สุด, การควบคุมอินพุต/เอาต์พุต, การตรวจสอบโดยมนุษย์สำหรับการตัดสินใจที่สำคัญ, การบันทึก, การย้อนกลับและการรายงานของผู้ใช้ วอเตอร์มาร์คหรือข้อมูลรับรองเนื้อหาอาจเพิ่มสัญญาณ, แต่ไม่มีตัวตรวจจับหรือป้ายเดียวที่ยืนยันความจริง กระบวนการทำงานของ synthetic-media ที่กว้างขวางต้องรักษาบริบทและความรับผิดชอบ
ตระกูลโมเดลและกลไกการสร้าง
โมเดล Generative AI ประมาณหรือเรียนรู้กระบวนการที่สามารถสร้างข้อความ, ภาพ, เสียง, วิดีโอ, โค้ด หรือข้อมูลโครงสร้างใหม่ได้ โมเดล Autoregressive พยากรณ์โทเคนหรือองค์ประกอบถัดไป; diffusion models เรียนรู้การย้อนกระบวนการรบกวน; variational autoencoders เรียนรู้ตัวแปรแฝงแบบความน่าจะเป็น; GANs ฝึกตัวสร้างให้แข่งขันกับตัวตรวจสอบ ระบบหลายโหมดเชื่อมโยงการแทนค่าข้ามสื่อ ผลลัพธ์ถูกสุ่มตัวอย่างจากโครงสร้างสถิติที่เรียนรู้โดยมีเงื่อนไขจากพรอมต์, บริบท, เครื่องมือหรืออินพุตอื่น ๆ – ไม่ได้ดึงมาจากความจริงที่รับประกัน
Foundation models ถูกฝึกล่วงหน้าบนข้อมูลกว้างและปรับให้เข้ากับงานผ่านการพรอมต์, การดึงข้อมูล, การปรับจูนละเอียด, การเพิ่มประสิทธิภาพตามความชอบ, เครือข่ายควบคุม หรือหัวข้อเฉพาะงาน Tokenizers, encoders, decoders, latent spaces และการตั้งค่าการสุ่มตัวอย่างกำหนดผลลัพธ์ อุณหภูมิและการกรองตัวเลือกแลกเปลี่ยนระหว่างความกำหนดค่าและความหลากหลาย พรอมต์ที่ยาวให้บริบทแต่ก็อาจขัดแย้ง, ทำให้เสียสมาธิ หรือมีคำสั่งที่เป็นอันตราย การดึงข้อมูลสามารถทำให้ความรู้ที่เปลี่ยนแปลงมีพื้นฐาน, ในขณะที่โค้ดที่กำหนดได้ควรจัดการคำนวณและกฎอย่างแม่นยำ
การประเมิน, ที่มาของข้อมูล, และสิทธิ
ประเมินตามงาน: ความถูกต้องของข้อเท็จจริงและการอ้างอิงสำหรับคำตอบ, การดำเนินการและความปลอดภัยสำหรับโค้ด, ความเที่ยงตรงและความหลากหลายสำหรับสื่อ, และผลลัพธ์ของมนุษย์สำหรับการช่วยสร้างสรรค์ รวมถึงการปฏิเสธ, การสอบเทียบ, ความหน่วง, ค่าใช้จ่าย, ภาษา, การเข้าถึงได้, และการทดสอบแบบกดดัน ผลลัพธ์ที่ลื่นไหลหรือเหมือนภาพถ่ายอาจผิดพลาด รักษาโมเดล, พรอมต์, seed, หลักฐานแหล่งข้อมูล, การเรียกใช้เครื่องมือและการประมวลผลต่อเพื่อความสามารถในการทำซ้ำ แยกคุณภาพการดึงข้อมูลออกจากการสร้างเพื่อให้คำตอบที่ขัดเกลาไม่สามารถปกปิดหลักฐานที่ขาดหายได้
การฝึกและผลลัพธ์ทำให้เกิดคำถามเกี่ยวกับลิขสิทธิ์, ใบอนุญาต, ความยินยอม, ความเป็นส่วนตัว, การเปิดเผยสาธารณะ, และความลับ สร้างที่มาของข้อมูลและการใช้ที่อนุญาตสำหรับข้อมูลนำเข้า; ป้องกันผู้ใช้ไม่ให้เปิดเผยความลับ; ทดสอบการจดจำ; และจัดให้มีกระบวนการรายงานและการลบ สื่อสังเคราะห์ควรมีที่มาที่คงทนหรือการเปิดเผยเมื่อทำได้, โดยเฉพาะเมื่ออาจถูกเข้าใจว่าเป็นหลักฐาน อย่าใช้ลักษณะ, เสียงหรือสไตล์ในลักษณะที่ละเมิดสิทธิหรือหลอกลวง
การควบคุมการปรับใช้
พิจารณาผลลัพธ์ของโมเดลเป็นข้อมูลนำเข้าที่ไม่เชื่อถือได้ ตรวจสอบสคีมา, ทำความสะอาดโค้ดและไฟล์, แยกการทำงาน, ให้สิทธิ์ทุกเครื่องมือจากภายนอก, จำกัดค่าใช้จ่ายและอัตรา, และต้องการการยืนยันสำหรับการกระทำที่สำคัญ เฝ้าติดตามความล้มเหลว, การละเมิด, การเปลี่ยนแปลงและการแก้ไขของผู้ใช้ พร้อมกับการย้อนกลับและการสำรองแบบไม่สร้างผลลัพธ์ บันทึกการใช้ที่ตั้งใจและที่ห้ามใช้ Generative AI ขยายอินเทอร์เฟซสำหรับการสร้างและแปลงข้อมูล, แต่ความน่าเชื่อถือและความรับผิดชอบมาจากข้อมูลโดยรอบ, การประเมิน, ความปลอดภัย, ที่มาของข้อมูล, และกระบวนการตัดสินใจของมนุษย์
ตัวอย่างการทำงาน: ผู้ช่วยสร้างคำอธิบายผลิตภัณฑ์แบบสร้างสรรค์
ผู้ค้าปลีกให้บรรณาธิการสร้างร่างคำอธิบายโดยใช้เฉพาะคุณลักษณะผลิตภัณฑ์ที่ได้รับการอนุมัติและแนวทางแบรนด์ พรอมต์รวมข้อเท็จจริงเชิงโครงสร้าง, ในขณะที่การดึงข้อมูลให้แนวทางปัจจุบัน ผลลัพธ์ต้องสอดคล้องกับสคีมาและตรวจสอบกับค่าต้นฉบับ; มิติที่ไม่ได้รับการสนับสนุน, การอ้างอิงด้านความปลอดภัยหรือการรับรองจะทำให้ถูกปฏิเสธ การประเมินครอบคลุมความแม่นยำของข้อเท็จจริง, สไตล์, การซ้ำซ้อน, คุณภาพหลายภาษา, การเข้าถึง, ความหน่วง, และการแก้ไขของบรรณาธิการ, เทียบกับแม่แบบและการเขียนด้วยมือ
บรรณาธิการอนุมัติการเผยแพร่ทุกครั้งและสามารถดูฟิลด์ต้นฉบับได้ โมเดลไม่มีความสามารถในการเปลี่ยนราคา, สต็อก, หรือเผยแพร่อย่างตรง การป้องกันการฉีดพรอมต์และข้อมูลผลิตภัณฑ์จากการฉีดแทรก, และบันทึกผู้จัดหาที่เป็นความลับถูกตัดออก การเฝ้าติดตามบันทึกการอ้างอิงที่ไม่ได้รับการสนับสนุน, การแก้ไข, การร้องเรียน, ค่าใช้จ่าย, และเวอร์ชันของผู้ให้บริการ ข้อความที่สร้างขึ้นถูกเก็บพร้อมที่มาของข้อมูล ระบบจะประหยัดเวลาการร่างเฉพาะเมื่อการแก้ไขและการตรวจสอบไม่ทำให้ประโยชน์หายไปและความจริงของผลิตภัณฑ์ยังคงอยู่ภายใต้ข้อมูลที่มีอำนาจ
หลักฐานการนำไปใช้และความพร้อมในการปฏิบัติการ
การตัดสินใจนำไปใช้จริงต้องการมากกว่าการสาธิตที่ประสบความสำเร็จ กำหนดผู้ใช้เป้าหมาย, สภาพแวดล้อมการทำงาน, อินพุต, เอาต์พุต, ขึ้นต่อ, เจ้าของ, และผลของความล้มเหลวที่สำคัญแต่ละประการ สร้างฐานข้อมูลที่ทำซ้ำได้และชุดการประเมินที่มีเวอร์ชันก่อนการปรับแต่ง ทดสอบกรณีทั่วไป, เงื่อนไขขอบเขต, อินพุตที่ผิดรูปหรือหายไป, การเปลี่ยนแปลงการกระจาย, การขัดข้องของส่วนพึ่งพา, การใช้ในทางที่ผิด, และกลุ่มหรือสภาพแวดล้อมที่อาจไม่ได้รับการบริการอย่างเพียงพอ วัดคุณภาพของงานพร้อมกับการสอบเทียบหรือความไม่แน่นอน, ความหน่วง, ปริมาณการทำงาน, ค่าใช้จ่ายของทรัพยากร, การเข้าถึง, ความเป็นส่วนตัวและความปลอดภัย บันทึกการแปลงและเกณฑ์ทุกอย่างเพื่อให้ผู้ตรวจสอบอิสระสามารถทำซ้ำผลลัพธ์และแยกแยะหลักฐานจากต้นแบบที่น่าสนใจ
ก่อนเปิดใช้งาน, มอบอำนาจสำหรับการปล่อย, ข้อยกเว้น, การเปลี่ยนแปลง, การย้อนกลับและการยกเลิก ใช้วิธีการเปิดตัวเป็นขั้นตอน, รักษาการสำรองที่ปลอดภัย, และตรวจสอบการเฝ้าติดตามด้วยความล้มเหลวที่ถูกฉีดเข้ามาโดยเจตนา เทเลเมตรีการปฏิบัติการควรเปิดเผยคุณภาพอินพุต, พฤติกรรมเอาต์พุต, เวอร์ชันของโมเดลหรือกฎ, สถานะของส่วนพึ่งพา, การแทรกแซงของมนุษย์, และผลลัพธ์ที่ยืนยันโดยไม่เก็บข้อมูลที่ละเอียดอ่อนที่ไม่จำเป็น กำหนดเกณฑ์การแจ้งเตือนและเจ้าของการตอบสนอง, จากนั้นตรวจสอบหลักฐานจากโลกจริงหลังการปรับใช้แทนการสันนิษฐานว่าประสิทธิภาพออฟไลน์จะคงอยู่ ประเมินใหม่เมื่อแหล่งข้อมูล, ผู้ใช้, โมเดล, ผู้จำหน่าย, นโยบาย, ฮาร์ดแวร์ หรือเป้าหมายเปลี่ยนแปลง ระบบที่ดูแลต้องมีเอกสารการกู้คืน, การเรียนรู้จากเหตุการณ์, ขั้นตอนการลบและการเก็บรักษา, และจุดชัดเจนที่ควรปิดการทำงานหรือแทนที่
คำถามที่พบบ่อย
Generative AI เป็นเช่นเดียวกับโมเดลภาษาใหญ่หรือไม่?
ไม่. LLMs เป็นหนึ่งในประเภทของโมเดลสร้างเท่านั้น Generative AI ยังรวมถึงระบบภาพ, เสียง, วิดีโอและข้อมูลโครงสร้างที่สร้างด้วยสถาปัตยกรรมหลายแบบ
โมเดลคัดลอกข้อมูลการฝึกของมันหรือไม่?
โดยทั่วไปมันสังเคราะห์จากรูปแบบที่เรียนรู้, แต่ก็อาจเกิดการจดจำและการทำสำเนาใกล้เคียงได้ ความเสี่ยงด้านความเป็นส่วนตัวและที่มาของข้อมูลต้องได้รับการประเมินแทนการสันนิษฐานว่าไม่มี
แหล่งอ้างอิงหลัก












