พื้นฐาน AI
วิธีสร้างแชทบอท: สถาปัตยกรรม, ข้อมูล, ความปลอดภัย, และการประเมินผล

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google
แชทบอทคือแอปพลิเคชันที่รับข้อความ, กำหนดว่าผู้ใช้ต้องการอะไร, และส่งคืนการตอบกลับผ่านข้อความหรือเสียง ระบบสมัยใหม่อาจผสานกฎ, การดึงข้อมูล, ตัวจำแนกประเภท, ทรานส์ฟอร์มเมอร์, เครื่องมือ, และโมเดลภาษาขนาดใหญ่ แทนที่จะพึ่งพาโมเดลเดียว
การสร้างแชทบอทที่มีประโยชน์จึงเป็นปัญหาที่เกี่ยวกับผลิตภัณฑ์และระบบ ชั้นสนทนาต้องเชื่อมต่อกับความรู้ที่เชื่อถือได้และการกระทำทางธุรกิจ ในขณะเดียวกัน ตัวตน, สิทธิ์การเข้าถึง, การบันทึก, การประเมิน, การสำรอง, และการส่งต่อให้มนุษย์จำกัดสิ่งที่บอทได้รับอนุญาตให้ทำ
ประเด็นสำคัญ
- เริ่มต้นด้วยงานผู้ใช้ที่แคบและเกณฑ์ความสำเร็จที่วัดได้
- แยกการสร้างภาษาจากการดึงข้อมูล, เครื่องมือ, สิทธิ์การเข้าถึง, และกฎธุรกิจ
- ทดสอบการสนทนาครบถ้วน รวมถึงความคลุมเครือ, การขัดจังหวะ, การปฏิเสธ, และการกู้คืน
- ถือว่าคำสั่งและผลลัพธ์ของโมเดลเป็นข้อมูลที่ไม่เชื่อถือได้; ตรวจสอบการผลิตและรักษาเส้นทางการส่งต่อ
กำหนดงานก่อนเลือกโมเดล
บันทึกว่าผู้ใช้คือใคร, พวกเขาต้องการทำอะไร, ระบบสามารถเข้าถึงข้อมูลใด, และการกระทำใดต้องการการยืนยัน บอทคำถามที่พบบ่อย, ผู้ช่วยตรวจสอบสถานะการสั่งซื้อ, และตัวแทนจัดการบัญชี มีโปรไฟล์ความเสี่ยงที่แตกต่างกันอย่างมาก
สร้างฐานมาตรฐานที่ไม่ใช้ AI และชุดการยอมรับของการสนทนาตัวอย่างวัดผลสำเร็จของงาน, การสนับสนุนคำตอบ, ความล่าช้า, การละทิ้ง, การส่งต่อ, และค่าใช้จ่ายของข้อผิดพลาดที่เป็นอันตราย การสาธิตที่คล่องแคล่วไม่ได้เป็นหลักฐานว่ากระบวนการทำงานเชื่อถือได้
ใช้สถาปัตยกรรมแบบชั้นหลายระดับ
สายงานทั่วไปประกอบด้วยตัวแปลงช่องทาง, สถานะเซสชัน, การตรวจสอบข้อมูลเข้า, ตรรกะเจตนาหรือการกำหนดเส้นทาง, การดึงข้อมูล, โมเดลการตอบสนองหรือแนวนโยบาย, ตัวแปลงเครื่องมือ, และการสังเกต การดึงข้อมูลสามารถอิงคำตอบจากเอกสารที่ได้รับการอนุมัติ; เครื่องมือทำการกระทำที่ควบคุมได้ผ่านสคีมาที่ชัดเจน
เก็บการตรวจสอบเชิงกำหนดไว้ด้านนอกโมเดลภาษา การยืนยันตัวตน, การให้สิทธิ์, ขีดจำกัดสินค้าคงคลัง, การคืนเงิน, และการกระทำที่ไม่สามารถย้อนกลับได้ ควรบังคับใช้โดยโค้ดแอปพลิเคชัน การออกแบบพรอมต์ สามารถกำหนดพฤติกรรมได้ แต่ไม่ใช่ระบบควบคุมการเข้าถึง
ออกแบบการสนทนา, ความรู้, และการกู้คืนร่วมกัน
การสนทนาที่ดีจัดการกับคำขอที่ไม่สมบูรณ์, การแก้ไข, ความตั้งใจหลายประการ, และการอ้างอิงถึงการพูดคุยก่อนหน้า เก็บเฉพาะบริบทที่จำเป็นสำหรับงาน, ทำให้การเก็บรักษาเป็นที่มองเห็น, และแยกคำพูดของผู้ใช้จากข้อเท็จจริงที่เชื่อถือได้ซึ่งได้จากระบบที่ได้รับการอนุมัติ
เมื่อความมั่นใจหรือหลักฐานไม่เพียงพอ, บอทควรถามคำถามที่เจาะจง, เสนอทางเลือกที่ปลอดภัย, หรือส่งต่อให้คนโดยสรุปสั้น การกู้คืนเป็นส่วนหนึ่งของประสบการณ์หลัก ไม่ใช่กรณีขอบที่เพิ่มเข้ามาหลังการเปิดตัว
ประเมินและดำเนินการระบบทั้งหมด
ทดสอบคุณภาพการดึงข้อมูล, การเลือกเครื่องมือ, ความแม่นยำของอาร์กิวเมนต์, การปฏิบัติตามนโยบาย, ความต้านทานต่อการฉีดพรอมต์, การรั่วไหลของข้อมูลส่วนบุคคล, และผลลัพธ์จากต้นจนจบ ตรวจสอบการโจมตีแบบทีมแดงและยืนยันว่าเอกสารที่เป็นอันตรายไม่สามารถแทนที่คำสั่งของระบบโดยเงียบๆ
กำหนดเวอร์ชันของพรอมต์, ดัชนี, โมเดล, นโยบาย, และเครื่องมือ ตรวจสอบการสนทนาตัวอย่างด้วยการควบคุมความเป็นส่วนตัว, เฝ้าดูการเปลี่ยนแปลงและกลุ่มความล้มเหลว, และรักษาการย้อนกลับ ระเบียบปฏิบัติการนี้เชื่อมการพัฒนาแชทบอทกับ AIOps และการตอบสนองต่อเหตุการณ์
ส่วนประกอบหลักของแชทบอทโดยละเอียด
ชั้นช่องทางทำให้ข้อมูลเข้าเป็นมาตรฐานจากการแชทบนเว็บ, แอปมือถือ, แพลตฟอร์มข้อความ, หรือเสียง ชั้นเซสชันเชื่อมข้อความกับการสนทนาที่ได้รับการยืนยันหรือไม่ระบุตัวตน, บังคับให้หมดอายุ, และเก็บสถานะที่จำเป็นสำหรับงานเท่านั้น การควบคุมข้อมูลเข้า จำกัด ขนาดและประเภทไฟล์, ตรวจจับข้อมูลที่ไม่ปลอดภัย, และลบมาร์กอัปที่ระบบต่อไปไม่ควรดำเนินการ
เร้าเตอร์จากนั้นตัดสินใจว่าคำขอเป็นส่วนของกระบวนการกำหนดผล, การค้นหา, การสร้าง, หรือคิวมนุษย์ ตัวจำแนกเจตนาแบบคลาสสิกยังคงมีประโยชน์เมื่อชุดป้ายกำกับคงที่; โมเดลภาษาให้ความยืดหยุ่นมากกว่าแต่ปรับเทียบได้ยาก เร้าเตอร์แบบผสมสามารถสำรองงานที่ควบคุมหรือปริมาณสูงสำหรับกระบวนการที่ทดสอบแล้วและใช้โมเดลทั่วไปสำหรับการอธิบายแบบเปิด
ชั้นการตอบสนองควรแยกหลักฐานและสถานะออกจากกัน ประโยคที่สร้างขึ้นสามารถอ้างอิงข้อความที่ดึงมา, แต่แอปพลิเคชันต้องเก็บว่ามาจากแหล่งและเวอร์ชันใด การจำจำลองสนทนาควรแยกความชอบของผู้ใช้จากข้อมูลบัญชีที่ตรวจสอบแล้ว, และไม่ควรให้ข้อความผู้ใช้ก่อนหน้านี้มอบสิทธิ์ใหม่
การดึงข้อมูล, เครื่องมือ, และการทำธุรกรรม
คุณภาพการดึงข้อมูลเริ่มต้นก่อนการค้นหาเวกเตอร์ เอกสารต้องมีความเป็นเจ้าของ, ป้ายการเข้าถึง, เวอร์ชันมาตรฐาน, ชิ้นส่วนที่มีประโยชน์, และวันลบ การเขียนใหม่ของคำค้น, การค้นหาด้วยคีย์เวิร์ด, การฝังเวกเตอร์, ตัวกรอง, และการจัดอันดับใหม่สามารถผสานกันได้ การประเมินควรวัดว่ามีการดึงหลักฐานที่จำเป็นหรือไม่, มีการกรองข้อความที่ไม่เกี่ยวข้องหรือไม่, และคำตอบสอดคล้องกับหลักฐานหรือไม่
เครื่องมือแปลงข้อเสนอของโมเดลเป็นคำขอที่ระบุประเภทไปยังโค้ดแอปพลิเคชัน แต่ละเครื่องมือต้องมีวัตถุประสงค์แคบ, สคีมาที่ชัดเจน, การตรวจสอบฝั่งเซิร์ฟเวอร์, ใบรับรองแบบน้อยที่สุด, เวลาหมด, ความเป็นอิดิโมพอเทนต์เมื่อเป็นไปได้, และผลลัพธ์ที่ชัดเจน โมเดลไม่ควรสร้างคำสั่งฐานข้อมูลดิบหรือ URL 任意 เมื่อสามารถเปิดเผยการดำเนินการธุรกิจที่จำกัดได้
ธุรกรรมต้องการการยืนยันในจุดที่ทำการสัญญา แสดงฟิลด์สำคัญให้ผู้ใช้เห็น—ผู้รับ, จำนวน, ที่อยู่, วันที่, หรือการเปลี่ยนแปลงการเข้าถึง—และไม่ถือว่า ‘ใช่’ เก่าเป็นการอนุมัติสำหรับการกระทำใหม่ สำหรับงานหลายขั้นตอน, เก็บเครื่องจักรสถานะนอกโมเดลเพื่อให้การลองใหม่หรือข้อความที่จัดลำดับใหม่ไม่ข้ามเกตที่จำเป็น
แผนการสร้างและประเมินผลเชิงปฏิบัติ
เริ่มต้นด้วยงานตัวอย่าง 20 ถึง 50 งานและรวมถึงคำขอที่ล้มเหลว, คลุมเครือ, และอยู่นอกขอบเขต ทำเครื่องหมายการกระทำที่คาดหวัง, หลักฐาน, การส่งต่อ, และพฤติกรรมที่ห้ามใช้ ดำเนินการกระบวนการที่ง่ายที่สุดที่ใช้ได้, แล้วเพิ่มการดึงข้อมูลหรือการสร้างเฉพาะที่ทำให้ผลลัพธ์ที่วัดได้ดีขึ้น วิธีนี้สร้างชุดทดสอบรีเกรสที่นำกลับมาใช้ใหม่ได้ก่อนที่อินเทอร์เฟซจะซับซ้อน
ประเมินส่วนประกอบและการสนทนาแยกกัน เมตริกการดึงข้อมูล, ความแม่นยำของการเรียกเครื่องมือ, การตรวจสอบนโยบาย, และการสนับสนุนการตอบสนองวินิจฉัยความล้มเหลวเฉพาะ; การสำเร็จของงานและความพยายามของผู้ใช้เปิดเผยคุณภาพระดับระบบ ใช้การทดสอบหลายรอบที่แก้ไขรายละเอียดก่อนหน้า, ขัดจังหวะกระบวนการ, เปลี่ยนหัวข้อ, ไม่ให้ข้อมูลที่จำเป็น, และกระตุ้นความล้มเหลวของการพึ่งพา
การเปิดตัวในขั้นตอนการผลิตควรจัดเป็นขั้นตามกลุ่มผู้ใช้, งาน, และสิทธิ์ ตรวจสอบข้ออ้างที่ไม่รองรับ, การชี้แจงซ้ำ, การปฏิเสธเครื่องมือ, การส่งต่อ, ความล่าช้า, และการละทิ้ง ตรวจสอบตัวอย่างที่ปลอดภัยต่อความเป็นส่วนตัว, รักษาเส้นทางปิดการทำงานฉุกเฉินสำหรับแต่ละเครื่องมือ, และใช้ผลการตรวจพบเหตุการณ์เพื่ออัปเดตพรอมต์, ข้อมูล, โค้ด, และชุดทดสอบพร้อมกัน
ตัวอย่างการทำงาน: แชทบอทสนับสนุนตั้งแต่ต้นแบบจนถึงการผลิต
สมมติว่าผู้ค้าปลีกต้องการแชทบอทที่ตอบคำถามเกี่ยวกับการสั่งซื้อและการคืนสินค้า กำหนดเจตนาที่รองรับ, เงื่อนไขการส่งต่อ, ความรู้ที่ได้รับการอนุมัติ, กฎการยืนยันตัวตน, และการกระทำที่ห้ามทำเป็นอันดับแรก สร้างชุดทดสอบจากคำถามในประวัติที่ลบข้อมูลส่วนบุคคล, รวมถึงคำขอที่คลุมเครือ, การสะกดผิด, ข้อมูลหลายภาษา, ผู้ใช้โกรธ, การฉีดพรอมต์, และคำถามที่ไม่มีคำตอบ ฐานการดึงข้อมูลควรคืนหลักฐานก่อนที่การตอบแบบสร้างจะได้รับอนุญาตให้อ้างนโยบายหรือสถานะการสั่งซื้อ
ระบบรันไทม์สามารถจำแนกเจตนา, ดึงข้อความนโยบาย, ขอการยืนยันตัวตนเฉพาะเมื่อจำเป็นต้องใช้ข้อมูลบัญชี, เรียก API การสั่งซื้อที่มีขอบเขตแคบ, รวบรวมคำตอบ, และแนบการอ้างอิง การเรียกแต่ละเครื่องมือต้องมีสคีมาที่ชัดเจน, การตรวจสอบการให้สิทธิ์, เวลาหมด, นโยบายการลองใหม่, และคีย์อิดิโมพอเทนต์ โมเดลไม่ควรสร้างคำสั่งฐานข้อมูลดิบหรือกำหนดสิทธิ์ของตนเอง การกระทำที่มีผลกระทบสูงเช่นการยกเลิกหรือการคืนเงินต้องการการยืนยันและ, หากเกินขีดจำกัดที่กำหนด, ต้องได้รับการอนุมัติจากมนุษย์
ประเมินความแม่นยำของเจตนา, ความถูกต้องของคำตอบ, การสนับสนุนหลักฐาน, คุณภาพการปฏิเสธ, การกักกันที่สำเร็จ, ความแม่นยำของการส่งต่อ, ความล่าช้า, และต้นทุนต่อการสนทนาที่แก้ไขได้ ตรวจสอบผลลัพธ์ตามเจตนาและกลุ่มผู้ใช้แทนการเฉลี่ยหนึ่งค่า ในการผลิต, บันทึกร่องรอยที่คำนึงถึงความยินยอม, ผลลัพธ์ของเครื่องมือ, เวอร์ชันเอกสารที่ดึงมา, และการแก้ไขของผู้ใช้ ปล่อยอย่างค่อยเป็นค่อยไป, เปรียบเทียบกับช่องทางที่มีอยู่, และปิดการใช้งานความสามารถเมื่อเกินเกณฑ์ข้อผิดพลาด, การละเมิด, หรือการพึ่งพา
รายการตรวจสอบการนำไปใช้เชิงปฏิบัติ
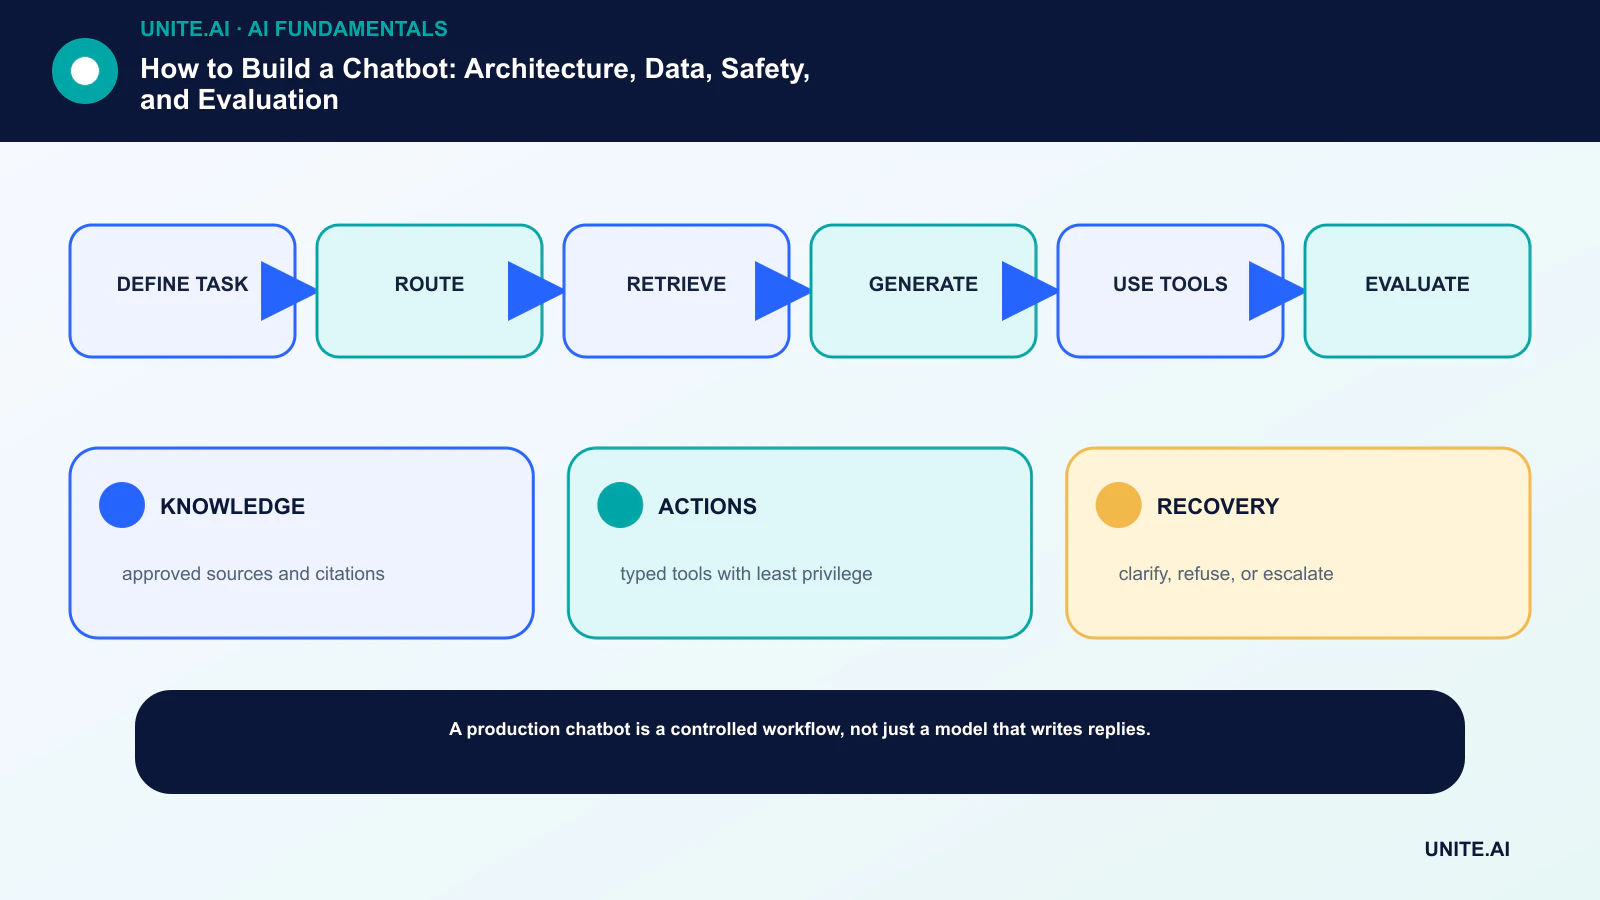
เปลี่ยนแนวคิดให้เป็นกระบวนการทำงานที่มีขอบเขตและทดสอบได้: กำหนดงาน → กำหนดเส้นทาง → ดึงข้อมูล → สร้าง → ใช้เครื่องมือ → ประเมิน กำหนดเจ้าของที่รับผิดชอบ, บันทึกข้อมูลและการพึ่งพา, สร้างฐานมาตรฐานง่าย, ตั้งเกณฑ์การยอมรับและการหยุด, ทดสอบความล้มเหลวตัวอย่าง, และกำหนดการเฝ้าติดตาม, การย้อนกลับ, และการตรวจสอบก่อนขยายขอบเขต บันทึกเวอร์ชันและสมมติฐานเพื่อให้ทีมอื่นสามารถทำซ้ำผลลัพธ์และเข้าใจการเปลี่ยนแปลง
ก่อนการเปิดตัว, ดำเนินการตรวจสอบความพร้อมที่บันทึกไว้กับผู้ที่สร้าง, ดำเนินการ, ปกป้อง, และได้รับผลกระทบจากระบบ ทดสอบกรณีปกติ, เงื่อนไขขอบเขต, ความล้มเหลวของการพึ่งพา, และการใช้งานผิดวิธี; เก็บรักษาหลักฐานและความเสี่ยงที่ยังไม่ได้แก้ไข กำหนดว่าใครสามารถอนุมัติการปล่อย, ปรับค่าเกณฑ์, ลบผลลัพธ์, หรือหยุดการดำเนินการ ตรวจทานการตัดสินใจใหม่หลังจากข้อมูลจากโลกจริงมาถึง, เนื่องจากการทดลองที่ประสบความสำเร็จทางเทคนิคไม่ได้รับประกันประสิทธิภาพที่เชื่อถือได้ในระดับกว้าง
- ความรู้: แหล่งที่ได้รับการอนุมัติและการอ้างอิง.
- การกระทำ: เครื่องมือแบบพิมพ์พร้อมสิทธิ์น้อยที่สุด.
- การกู้คืน: ชี้แจง, ปฏิเสธ, หรือส่งต่อ.
คำถามที่พบบ่อย
แชทบอทจำเป็นต้องใช้โมเดลภาษาขนาดใหญ่หรือไม่?
ไม่. กฎ, การค้นหา, แบบฟอร์ม, และตัวจำแนกขนาดเล็กสามารถปลอดภัยและประหยัดต้นทุนสำหรับงานที่แคบได้ โมเดลภาษาขนาดใหญ่มีประโยชน์เมื่อความเข้าใจหรือการสร้างภาษาที่ยืดหยุ่นให้คุณค่าที่วัดได้
ควรทดสอบอะไรบ้างก่อนการเปิดตัว?
งานตัวอย่าง, คำขอที่ไม่รองรับ, ภาษาที่คลุมเครือ, ความล้มเหลวของเครื่องมือ, ขอบเขตความเป็นส่วนตัว, พรอมต์เชิงศัตรู, การส่งต่อให้มนุษย์, ความล่าช้า, และความแม่นยำของทุกการกระทำที่มีผลต่อผลลัพธ์
แหล่งอ้างอิงหลัก