
AGI и будущее ИИ
Что такое тест Тьюринга и почему он важен?

 Добавьте Unite.AI в избранные источники в Google
Тест тест Тьюринга возник из статьи Алана Тьюринга 1950 года “Computing Machinery and Intelligence”. Вместо попытки определить мыслительный процесс, Тьюринг предложил игру‑имитацию: человеческий следователь обменивается письменными сообщениями с невидимыми участниками и определяет, кто из них человек, а кто машина.
Тест остаётся влиятельным, потому что превращает абстрактный философский вопрос в наблюдаемое взаимодействие. Он также имеет ограничения: выглядеть человеком в разговоре не то же самое, что быть правдивым, знающим, безопасным, сознательным или вообще интеллектуальным.
Основные выводы
- Исходная игра‑имитация Тьюринга — это текстовый поведенческий тест, а не перечень внутренних когнитивных свойств.
- Результаты зависят от оценщика, подсказки, продолжительности, инструкций участникам и правила подсчёта.
- Модель может имитировать человеческую беседу, одновременно «галлюцинируя» факты или проваливая простые тесты на надёжность.
- Современная оценка требует метрик задачи, адверсариального тестирования, человеческого ревью и доказательств, специфичных для рисков, помимо самого диалога.
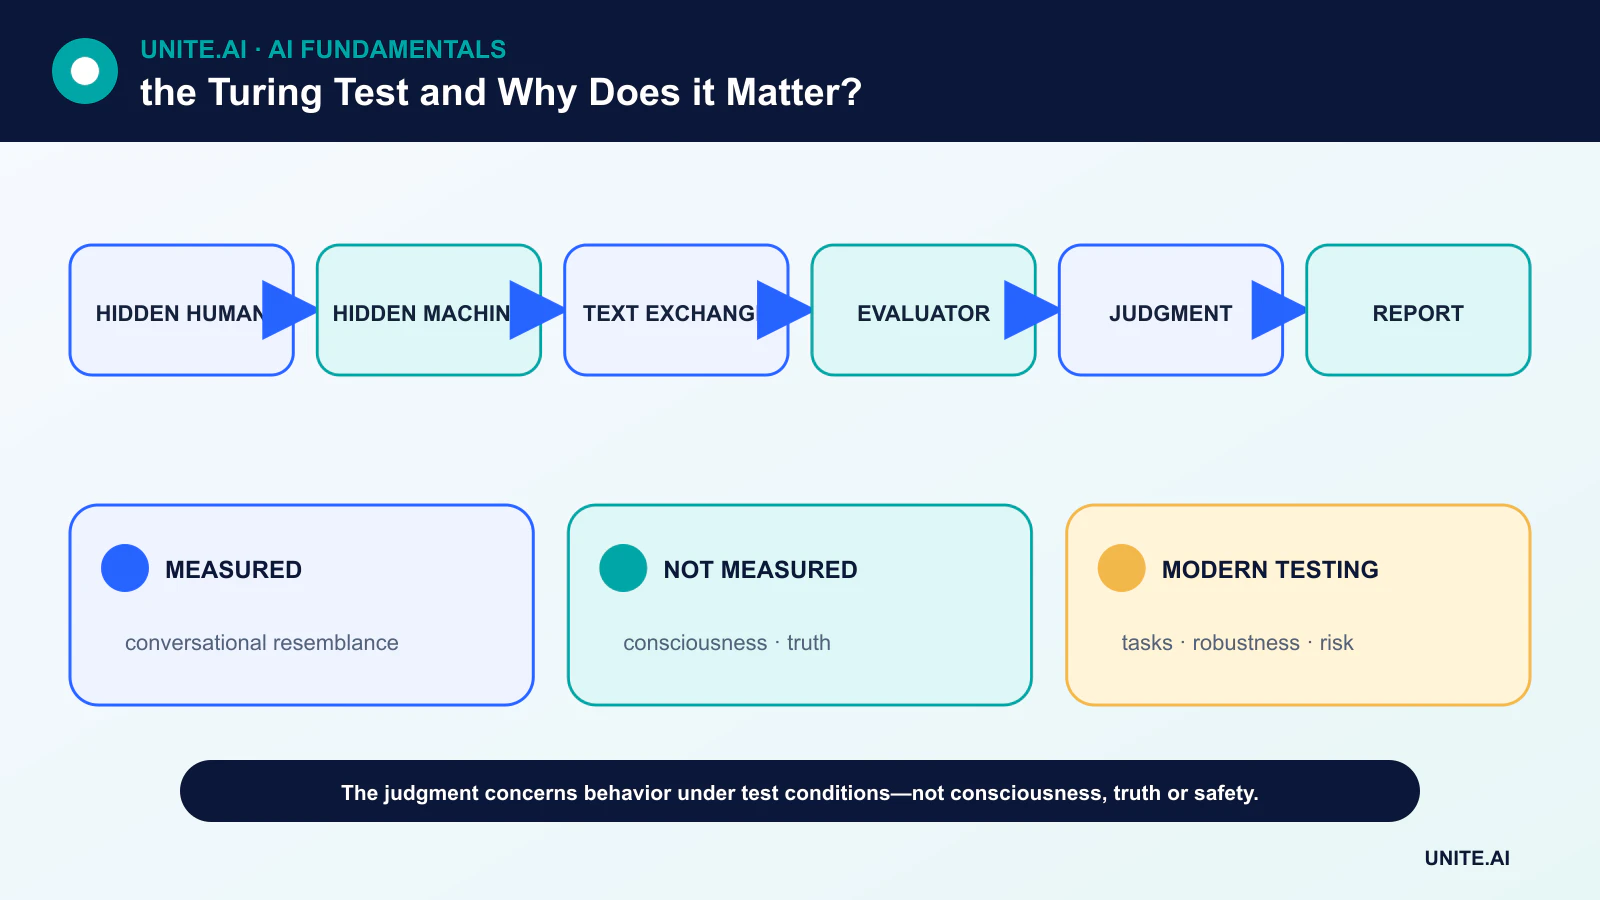
Игра‑имитация Тьюринга
В исходной постановке следователь общался на расстоянии, чтобы голос и внешний вид не раскрывали личность. Тьюринг спросил, может ли машина выступать достаточно успешно в игре, чтобы оценщик надёжно не мог отличить её от человека.
Такое практическое формулирование избавляло от необходимости устанавливать единственное определение мышления. Оно не утверждало, что каждый убедительный диалог доказывает интеллект, и не задавало универсального порога прохождения, применимого к любой последующей демонстрации чат‑бота.
Что на самом деле измеряет результат
Эксперимент измеряет поведенческую неразличимость при заданных условиях. Краткие беседы, неопытные судьи или подсказки, выбранные разработчиком системы, могут упростить задачу. Тщательный отчёт должен раскрывать критерии выбора транскриптов, количество и профиль судей, контрольных людей, ограничение по времени и используемый статистический метод.
Система может также использовать ожидания: уклончивость, юмор, опечатки и ролевую игру могут выглядеть человеческими, не демонстрируя надёжного рассуждения. И наоборот, необычно формальный человеческий ответ может быть ошибочно классифицирован как сгенерированный машиной.
Что тест Тьюринга не устанавливает
Тест напрямую не измеряет сознание, субъективный опыт, фактическую точность, причинное понимание или моральную ответственность. Он не раскрывает обучающие данные, архитектуру модели или режимы отказов за пределами диалога. Также он мало говорит о нелингвистическом интеллекте, таком как физическое манипулирование.
Современные языковые системы построены на трансформерных нейронных сетях и глубоком обучении, однако их беглые ответы всё ещё могут генерироваться на основе выученной статистической структуры, а не проверенной модели мира.
Как современная оценка ИИ расширяет вопрос
Современная оценка использует отложенные наборы задач, откалиброванную неопределённость, тесты на надёжность, «red teaming», проверки фактичности и исследования человеческих предпочтений. Метрика классификации текста может проверять заданное поведение, тогда как оценка на основе сценариев проверяет, следует ли система политике под давлением.
Ни один бенчмарк не охватывает все варианты развертывания. Загрязнение тестов может завышать результаты, а статические бенчмарки способствуют переобучению. Оценку следует повторять по мере изменения моделей, данных, подсказок, инструментов и пользовательской аудитории.
Почему тест всё ещё важен
Тест Тьюринга предвосхитил ключевой урок оценки ИИ: оценивать наблюдаемую способность, а не полагаться на заявления об внутренней сущности. Он также заставляет задаваться вопросом, какие человеческие поведения считаются доказательством и как экспериментальная постановка формирует вывод.
Лучшее современное применение — как историческая и концептуальная отправная точка. Прохождение игры‑имитации может быть интересным, но решения о внедрении требуют доказательств, связанных с конкретной задачей, затронутыми пользователями и предсказуемыми рисками.
Что измеряет тест Тьюринга
Игра‑имитация Алана Тьюринга задавала вопрос, может ли текстовый следователь надёжно отличить машину от человека. Она переоформила абстрактные дебаты о том, думают ли машины, в наблюдаемый эксперимент диалога. Тест зависит от участников, продолжительности, протокола, тем и правила оценки; нет единого универсального балла. Прохождение означает генерацию ответов, похожих на человеческие, в рамках этой схемы. Он не измеряет напрямую фактическую точность, рассуждения, сознание, автономию, восприятие, воплощённость, надёжность или полезное поведение в реальном мире.
Имитация человека может вознаграждать уклончивость, персонаж, ошибки, юмор или манипуляцию. Судья может принять человека за машину или быть под влиянием ожиданий, языка и культурного контекста. Краткие беседы позволяют трюки, которые не выдерживают длительного взаимодействия. С другой стороны, высоко полезная система для математики, перевода или моделирования белков может провалиться, потому что она не пытается выглядеть человеческой. Таким образом, тест измеряет социальную и лингвистическую способность, формируемую оценщиком, а не полную шкалу интеллекта.
Современные языковые модели и более строгая оценка
Большие языковые модели способны поддерживать беглый диалог, предсказывая последовательности на основе широких обучающих данных и последующей доработки, но беглость — слабый индикатор правды или понимания. Запомненные шаблоны, доступ к инструментам, скрытые подсказки, задержка и параметры сэмплинга влияют на результаты. Контролируемые оценки должны раскрывать модель и протокол, предотвращать утечку информации, включать адверсариальные и предметные вопросы, а также оценивать неопределённость и ссылки. Демонстрация, отобранная из успешных диалогов, не может оценить надёжность по всему спектру использования.
Современная оценка многомерна: точность задачи, калибровка, надёжность, согласованность на длительных горизонтах, безопасность, предвзятость, конфиденциальность, безопасность, эффективность и человеческие результаты. Поведенческие тесты следует дополнять доказательствами процессов, «red teaming», воспроизводимыми бенчмарк‑тестами и мониторингом в реальном мире. Бенчмарки могут насыщаться или попадать в обучающие данные, поэтому требуются приватные и обновляемые наборы тестов. Для систем, совершающих действия, необходимо отдельно оценивать разрешения инструментов, восстановление и последствия, помимо качества диалога.
Почему тест всё ещё важен
Тест Тьюринга остаётся исторически важным, поскольку сосредотачивается на поведении и сложности определения интеллекта. Он также поднимает постоянные вопросы об антропоморфизме и обмане. Интерфейсы должны идентифицировать синтетических агентов, а не рассматривать ошибочную идентификацию как успех, особенно в критически важных ситуациях. Используйте тест как философскую призму и один из методов оценки диалога, а не как сертификат общего интеллекта или личности. Ключевой вопрос внедрения — что система может надёжно выполнять, на каких доказательствах и ограничениях, и кто несёт ответственность в случае её сбоя.
Практический пример: контролируемая оценка диалога
Оценщики сравнивают людей и несколько ИИ‑систем в текстовых диалогах с фиксированной длительностью, темами, языком и скрытыми личностями. Судьи фиксируют, считают ли они каждого участника человеком, а также оценивают фактичность, согласованность, полезность, неопределённость и манипуляцию. Несколько судей и диалогов позволяют оценить вариативность, а протокол препятствует разработчикам моделей выбирать благоприятные транскрипты. Ошибочная классификация человека обеспечивает необходимую базу для интерпретации результата.
Система, обманывающая судей, но придумывающая факты, не считается общим интеллектом, тогда как явно раскрытая специализированная модель может быть весьма полезной, несмотря на провал в имитации. Результаты включают подсказку, модель, метод сэмплинга, доступ к инструментам и характеристики судей. Эксперимент рассматривается как один тест человеческого диалога. Решения о внедрении используют отдельные доказательства правильности задачи, безопасности, конфиденциальности и восстановления, а интерфейс идентифицирует агента, а не превращает обман в цель продукта.
Доказательства реализации и готовность к эксплуатации
Решение о выпуске продукта требует большего, чем успешная демонстрация. Необходимо определить целевых пользователей, эксплуатационную среду, входные и выходные данные, зависимости, владельца и последствия каждого важного сбоя. Установить воспроизводимую базу и версионированный набор оценок до настройки. Тестировать обычные случаи, граничные условия, некорректные или отсутствующие входные данные, сдвиг распределения, отказ зависимостей, неправильное использование и группы или среды, которые могут быть недостаточно обслужены. Оценивать качество задачи совместно с калибровкой или неопределённостью, задержкой, пропускной способностью, стоимостью ресурсов, доступностью, конфиденциальностью и безопасностью. Зафиксировать каждое преобразование и порог, чтобы независимый рецензент мог воспроизвести результат и различить доказательства от привлекательного прототипа.
Перед запуском назначьте ответственных за выпуск, исключения, изменения, откат и вывод из эксплуатации. Применяйте поэтапный развёртывание, сохраняйте безопасный откат и проверяйте мониторинг с преднамеренно внедрёнными сбоями. Оперативная телеметрия должна показывать качество входных данных, поведение вывода, версию модели или правила, состояние зависимостей, вмешательство человека и подтверждённые результаты без сбора ненужных конфиденциальных данных. Определите пороги оповещений и ответственного за реакцию, затем оценивайте реальные доказательства после внедрения, а не полагайтесь на сохранность офлайн‑показателей. Проводите переоценку при изменении источников данных, пользователей, моделей, поставщиков, политик, аппаратного обеспечения или целей. Поддерживаемая система также требует документированных процедур восстановления, обучения на инцидентах, удаления и хранения данных, а также чёткой точки, в которой её следует отключить или заменить.
Часто задаваемые вопросы
Существует ли ИИ, который однозначно прошёл тест Тьюринга?
Не существует единого официального органа тестирования или общепринятого протокола. Публичные демонстрации используют разные правила, поэтому заявления о «прохождении» нельзя напрямую сравнивать.
Неудача в тесте доказывает, что система неинтеллектуальна?
Нет. Специализированная система может быть весьма способной, не имитируя человеческий стиль общения.
Основные ссылки












