
Основы ИИ
Генеративные и дискриминативные модели машинного обучения

 Добавьте Unite.AI в избранные источники в Google
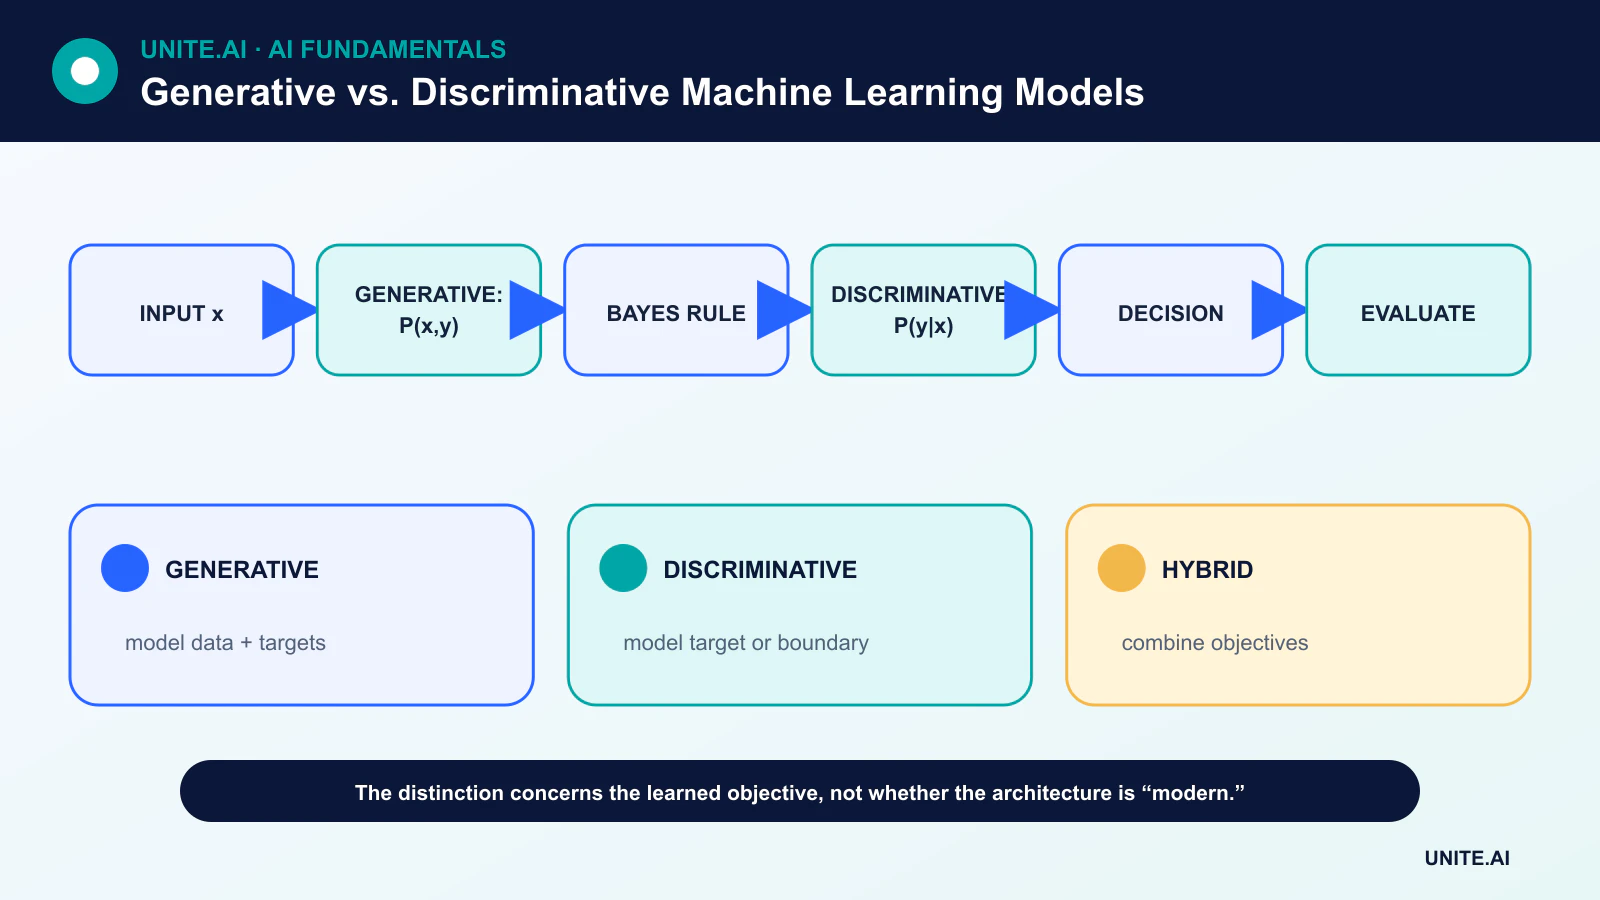
Генеративные и дискриминативные описывают, что модель изучает о данных и целевых переменных. В классической контролируемой классификации генеративная модель изучает совместное распределение, например P(x, y) или условное по классу P(x|y), тогда как дискриминативная модель изучает P(y|x) или прямую границу принятия решения.
Это различие полезно, однако современные системы часто комбинируют цели. Модель может изучать генеративные представления, а затем дообучаться для дискриминативного предсказания, либо использовать один общий «бэкбоун» как для генерации, так и для классификации.
Ключевые выводы
- Генеративные классификаторы моделируют, как появляются входы и метки; дискриминативные классификаторы моделируют метку, задаваемую входом, или границу принятия решения.
- Генеративные предположения могут помочь при ограниченном количестве размеченных данных, но могут быть неверными.
- Дискриминативные методы часто концентрируют мощность модели на задаче предсказания и могут достичь более низкой асимптотической ошибки классификации.
- GAN, VAE и языковые модели являются генеративными системами, но термин «генеративный» не означает, что каждый их компонент является генеративным классификатором.
Факторизация вероятностей
Генеративный классификатор может оценивать P(x|y) и P(y), а затем с помощью теоремы Байеса выводить P(y|x). Наивный Байес — классический пример. Дискриминативный классификатор, такой как логистическая регрессия, оценивает P(y|x) напрямую; SVM обучает разделяющую границу.
Моделирование P(x,y) — более широкая задача, чем предсказание y по x. Эта дополнительная структура может поддерживать сэмплирование или вывод при недостающих данных, но также требует предположений о распределении входов.
Эффективность данных и асимптотическое поведение
Сравнение Наивного Байеса и логистической регрессии, проведённое Нг и Джорданом, продемонстрировало полезный компромисс: при их предположениях генеративная модель может достичь предельной производительности с меньшим числом примеров, тогда как дискриминативная модель может достичь более низкой асимптотической ошибки.
Это не универсальный рейтинг. Результаты зависят от того, насколько семейство моделей соответствует данным, от размерности, регуляризации, оптимизации и качества меток. Эмпирическое сравнение на репрезентативном наборе валидации остаётся необходимым.
Представительные семейства моделей
К генеративным моделям относятся условные по классам распределения, скрытые марковские модели, смеси распределений, вариационные автокодировщики, авторегрессионные языковые модели, диффузионные модели и GAN.
К дискриминативным моделям относятся логистическая регрессия, деревья решений, условные случайные поля, машины опорных векторов и нейронные классификаторы. Один и тот же нейронный «бэкбоун» может относиться к любой из категорий в зависимости от цели обучения и выходных данных.
Гибридные и самосупервизированные системы
Предобученная языковая или визуальная модель может обучаться на немеченных данных с генеративной или самосупервизированной целью, а затем получать дискриминативный «головной» слой для целевой задачи. Полу‑контролируемые методы могут одновременно оптимизировать классификацию по размеченным данным и задачу на немеченных данных.
Гибридизация делает метки архитектуры менее информативными, чем весь конвейер обучения. Документация должна указывать цель, данные, выходы и предполагаемый вывод — а не просто называть модель генеративной.
Выбор подхода
Опирайтесь на задачу. Если цель — откалиброванная граница при обильных метках, дискриминативная модель является естественной базой. Если важны сэмплирование, оценка плотности, структура недостающих данных или немеченные данные, может пригодиться генеративный компонент.
Сравнивайте устойчивость, эффективность выборки, вычислительные ресурсы, правдоподобие или калибровку в зависимости от задачи. Хороший сгенерированный образец не доказывает, что классификатор хорош, а классификатор с высокой точностью не гарантирует реалистичную модель распределения входов.
Направления вероятностей и цели моделирования
Дискриминативная модель изучает границу или условное распределение P(y|x): по заданным признакам x предсказывает метку y. Логистическая регрессия, машины опорных векторов, условные случайные поля и многие классификаторы являются дискриминативными. Генеративная модель изучает совместное распределение P(x,y), условное по классу распределение P(x|y) или безусловное распределение данных, что позволяет выполнять сэмплирование или задачи, связанные с правдоподобием. Наивный Байес и линейный дискриминантный анализ — генеративные классификаторы; GAN, вариационные автокодировщики, диффузионные модели и авторегрессионные модели генерируют данные с помощью разных целей.
Различие касается того, какое распределение или правило принятия решения моделируется, а не того, используется ли нейронная сеть. Генеративную языковую модель можно заставить классифицировать, тогда как дискриминативный переранжировщик может направлять генерацию. Генеративные предположения могут повысить эффективность данных или обработать недостающие переменные, но создают риск ошибочной спецификации модели. Дискриминативные методы часто превосходят при обильных размеченных данных, поскольку они напрямую фокусируются на границе предсказания. Сравнивайте семейства при одинаковых признаках, данных, настройках и вычислительных ресурсах, а не рассматривайте одну категорию как универсально лучшую.
Обучение и оценка в зависимости от сценария применения
Оценка классификации использует точность, полноту, калибровку, устойчивость и стоимость ошибок. Оценка генеративных моделей должна учитывать достоверность, разнообразие, охват, правдоподобие или полезность для задачи, запоминание и безопасность. Модель может генерировать привлекательные образцы, теряя режимы, или достигать хорошего правдоподобия при плохом восприятии результата. Польза синтетических данных должна проверяться обучением и оценкой downstream‑моделей на независимых реальных данных, включая редкие группы. Данные теста не должны использоваться в запросах генерации и отборе.
В полуподконтроленном обучении генеративная модель может использовать структуру немеченных данных; в обнаружении аномалий правдоподобие может давать сбой, когда данные вне распределения получают высокую плотность по несущественным причинам. В генерации с поддержкой поиска генеративная модель‑ответ и дискриминативный поискщик или переранжировщик образуют гибрид. Диагностируйте стадии отдельно, чтобы плавный вывод не скрывал сбой поиска. Выбирайте разбиение, которое делает доказательства и контроль наблюдаемыми.
Развёртывание и управление
Генеративные системы добавляют риски, связанные с происхождением контента, интеллектуальной собственностью, имитацией, внедрением запросов и модерацией вывода; дискриминативные системы вносят риски порогов, отказов и неравномерных ошибок. Обе требуют прав на данные, защищённых артефактов, версионирования, репрезентативных тестов, мониторинга и человеческой ответственности, пропорциональной последствиям. В документации следует фиксировать точную цель и семантику вывода. Противопоставление генеративных и дискриминативных моделей — полезное статистическое различие, однако в реальных системах они часто комбинируются, и надёжность зависит от всего конвейера данных и решений.
Практический пример: классификация и генерация ответов поддержки
Платформа поддержки использует дискриминативный классификатор для определения типа проблемы и её срочности, а генеративную модель — для черновика ответа на основе утверждённой политики. Классификатор оценивается по класс‑специфичной полноте и калибровке; поиск‑модуль — по полноте доказательств; генератор — по обоснованности, корректности и отказу. На каждой стадии результат неизвестен, и генеративная модель не может изменить классификацию или право клиента через убеждающий текст.
Операторы видят предсказанный маршрут, источники и черновик, а затем утверждают или корректируют его перед отправкой. Фильтры разрешений применяются до поиска, и внедрение запросов в тексте клиента не может авторизовать инструменты. Мониторинг разделяет ошибки маршрутизации, пробелы в поиске, неподдерживаемые утверждения и правки операторов. Изменение политики мгновенно обновляет источники и инициирует регрессионные тесты; настройка оставлена для стабильного поведения. Гибридный дизайн использует сильные стороны дискриминативных и генеративных подходов, сохраняя доказательства и человеческую власть.
Доказательства реализации и готовность к эксплуатации
Решение о внедрении в продакшн требует большего, чем успешная демонстрация. Определите целевых пользователей, рабочую среду, входы, выходы, зависимости, владельца и последствия каждой важной ошибки. Установите воспроизводимую базу и версионированный набор оценок до настройки. Тестируйте обычные случаи, граничные условия, некорректные или отсутствующие входы, сдвиг распределения, сбои зависимостей, неправильное использование и группы или среды, которые могут быть недостаточно обслужены. Измеряйте качество задачи вместе с калибровкой или неопределённостью, задержкой, пропускной способностью, затратами ресурсов, доступностью, конфиденциальностью и безопасностью. Записывайте каждое преобразование и порог, чтобы независимый рецензент мог воспроизвести результат и отличить доказательства от привлекательного прототипа.
Перед запуском назначьте ответственных за релиз, исключения, изменения, откат и вывод из эксплуатации. Применяйте поэтапный выпуск, сохраняйте безопасный откат и проверяйте мониторинг с преднамеренно внесёнными сбоями. Оперативная телеметрия должна показывать качество входов, поведение вывода, версию модели или правила, состояние зависимостей, человеческие вмешательства и подтверждённые результаты без сбора ненужных конфиденциальных данных. Определите пороги тревоги и ответственного за реакцию, затем после развертывания оценивайте реальные доказательства, а не полагайтесь на сохранение офлайн‑показателей. Проводите переоценку при изменении источников данных, пользователей, моделей, поставщиков, политик, оборудования или целей. Поддерживаемая система также требует документированных процедур восстановления, обучения на инцидентах, удаления и хранения, а также чёткой точки, в которой её следует отключить или заменить.
Часто задаваемые вопросы
Является ли дискриминатор GAN дискриминативной моделью?
Он выполняет дискриминацию во время обучения, однако весь GAN представляет собой генеративный фреймворк, вывод которого создаётся генератором.
Всегда ли дискриминативное обучение является контролируемым?
Нет. Термин описывает моделируемое отношение или границу, тогда как надзор описывает обучающий сигнал. Современные цели могут размывать эти категории.
Основные источники












