
Fundamentos de IA
Modelos Generativos vs. Discriminativos de Aprendizado de Máquina

 Adicione Unite.AI às suas fontes preferidas no Google
Generativo e discriminativo descrevem o que um modelo aprende sobre os dados e os alvos. Na classificação supervisionada clássica, um modelo generativo aprende uma distribuição conjunta como P(x, y) ou a condicional de classe P(x|y), enquanto um modelo discriminativo aprende P(y|x) ou uma fronteira de decisão direta.
A distinção é útil, mas sistemas modernos frequentemente combinam objetivos. Um modelo pode aprender representações generativas e depois ser ajustado finamente para predição discriminativa, ou compartilhar uma mesma espinha dorsal entre geração e classificação.
Principais conclusões
- Classificadores generativos modelam como as entradas e rótulos surgem; classificadores discriminativos modelam o rótulo dado a entrada ou uma fronteira.
- Suposições generativas podem ajudar com dados rotulados limitados, mas também podem estar erradas.
- Métodos discriminativos frequentemente concentram capacidade na tarefa de predição e podem alcançar menor erro de classificação assintótico.
- GANs, VAEs e modelos de linguagem são sistemas generativos, mas “generativo” não significa que cada componente seja um classificador generativo.
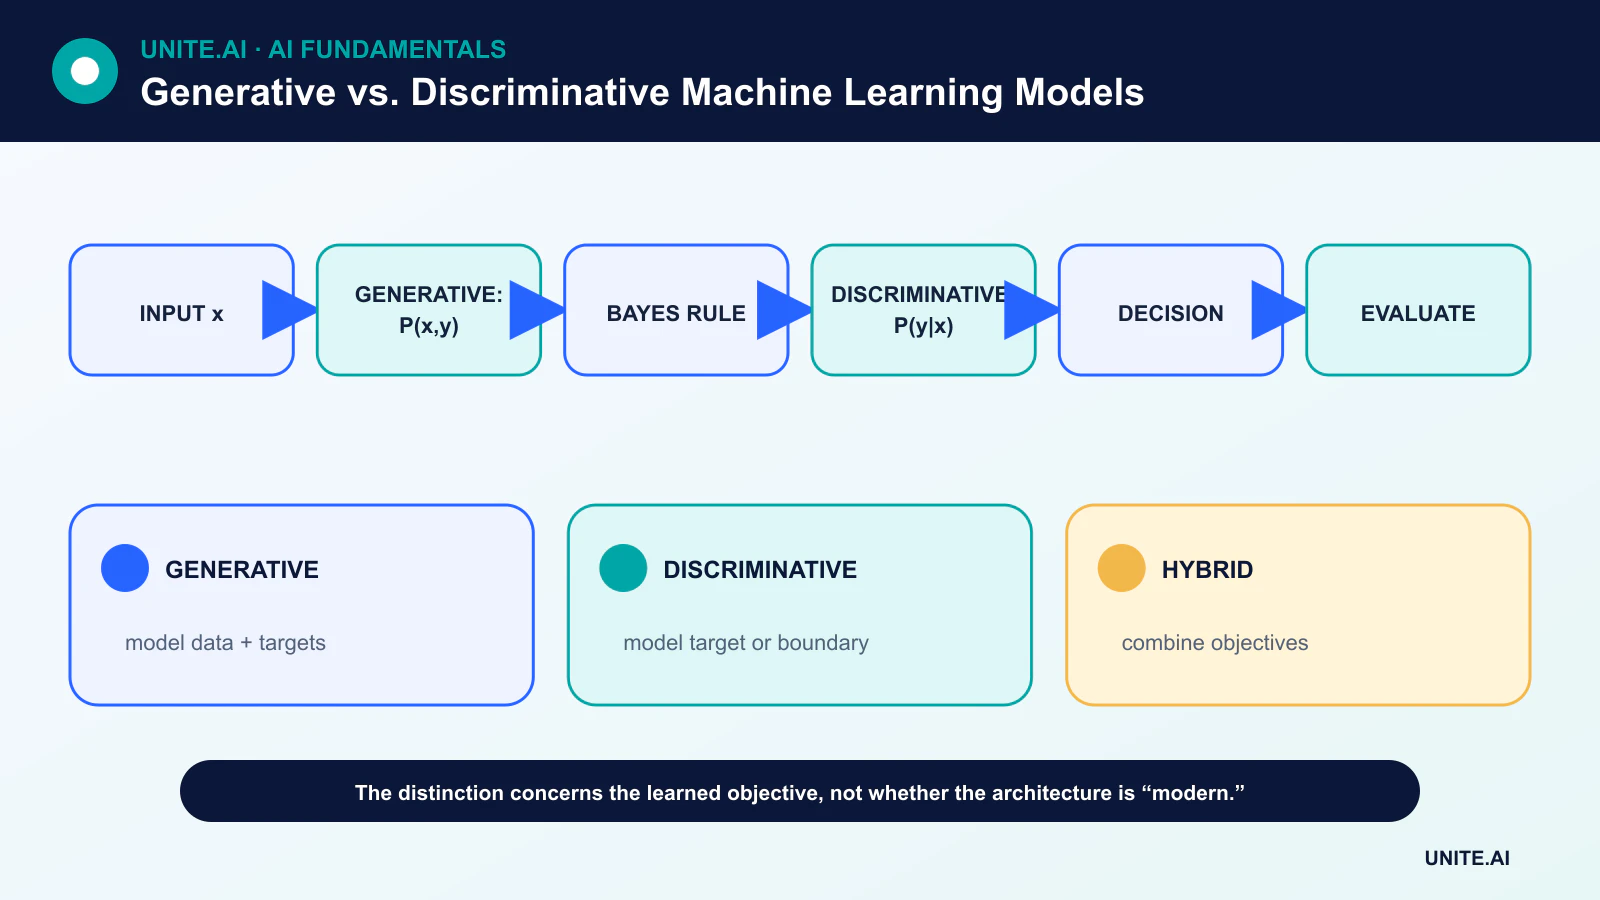
A fatoração de probabilidade
Um classificador generativo pode estimar P(x|y) e P(y), então usar teorema de Bayes para derivar P(y|x). Naive Bayes é um exemplo clássico. Um classificador discriminativo, como regressão logística, estima P(y|x) diretamente; um SVM aprende uma fronteira separadora.
Modelar P(x,y) é uma tarefa mais ampla que prever y a partir de x. Essa estrutura adicional pode suportar amostragem ou raciocínio sobre dados ausentes, mas também requer suposições sobre a distribuição de entrada.
Eficiência de dados e comportamento assintótico
A comparação de Ng e Jordan entre Naive Bayes e regressão logística mostrou um trade‑off útil: sob suas suposições, o modelo generativo pode alcançar seu desempenho limite com menos exemplos, enquanto o modelo discriminativo pode atingir um erro assintótico menor.
Isso não é um ranking universal. Os resultados dependem de se a família de modelos se ajusta aos dados, da dimensionalidade, regularização, otimização e qualidade dos rótulos. Comparações empíricas em um desenho de validação representativo permanecem essenciais.
Famílias de modelos representativas
Modelos generativos incluem distribuições condicionais de classe, modelos de Markov ocultos, modelos de mistura, autoencoders variacionais, modelos de linguagem autorregressivos, modelos de difusão e GANs.
Modelos discriminativos incluem regressão logística, árvores de decisão, campos aleatórios condicionais, máquinas de vetor de suporte e classificadores neurais. A mesma espinha dorsal neural pode participar de qualquer categoria dependendo do objetivo de treinamento e da saída.
Sistemas híbridos e auto‑supervisionados
Um modelo de linguagem ou visão pré‑treinado pode aprender a partir de dados não rotulados com um objetivo generativo ou auto‑supervisionado, e depois receber uma cabeça discriminativa para a tarefa alvo. Métodos semissupervisionados podem otimizar simultaneamente a classificação rotulada e um objetivo de dados não rotulados.
A hibridização torna os rótulos de arquitetura menos informativos que todo o pipeline de treinamento. A documentação deve declarar o objetivo, os dados, as saídas e a inferência pretendida — não simplesmente chamar um modelo de generativo.
Escolhendo entre abordagens
Use a tarefa para decidir. Se o objetivo é uma fronteira calibrada com rótulos abundantes, um modelo discriminativo é uma linha de base natural. Se amostragem, estimação de densidade, estrutura de dados ausentes ou dados não rotulados são centrais, um componente generativo pode ajudar.
Compare robustez, eficiência de amostra, custo computacional, verossimilhança ou calibração conforme apropriado. Uma amostra gerada de boa qualidade não prova que o classificador seja bom, e um classificador de alta acurácia não implica um modelo realista da distribuição de entrada.
Direções de probabilidade e objetivos de modelagem
Um modelo discriminativo aprende uma fronteira ou distribuição condicional P(y|x): dadas as características x, prediz o rótulo y. Regressão logística, máquinas de vetor de suporte, campos aleatórios condicionais e muitos classificadores são discriminativos. Um modelo generativo aprende uma distribuição conjunta P(x,y), uma distribuição condicional de classe P(x|y) ou uma distribuição de dados incondicional, permitindo amostragem ou tarefas relacionadas à verossimilhança. Naive Bayes e análise discriminante linear são classificadores generativos; GANs, autoencoders variacionais, modelos de difusão e modelos autorregressivos geram dados por meio de diferentes objetivos.
A distinção diz respeito à distribuição ou regra de decisão modelada, não ao fato de uma rede neural ser usada. Um modelo de linguagem generativo pode ser solicitado a classificar, enquanto um re‑ranker discriminativo pode orientar a geração. Suposições generativas podem melhorar a eficiência de dados ou lidar com variáveis ausentes, mas criam risco de especificação incorreta do modelo. Métodos discriminativos frequentemente se destacam com dados rotulados abundantes porque focam diretamente na fronteira de predição. Compare as famílias sob recursos, dados, ajuste e computação iguais, em vez de tratar uma categoria como universalmente superior.
Treinamento e avaliação por caso de uso
A avaliação de classificação usa precisão, recall, calibração, robustez e custo de erro. A avaliação generativa deve abordar fidelidade, diversidade, cobertura, verossimilhança ou utilidade da tarefa, memorização e segurança. Um modelo pode produzir amostras atraentes enquanto perde modos, ou alcançar boa verossimilhança com saída perceptual pobre. A utilidade de dados sintéticos deve ser testada treinando e avaliando modelos downstream em dados reais independentes, incluindo grupos raros. Mantenha os dados de teste fora dos prompts e da seleção de geração.
Em aprendizado semissupervisionado, um modelo generativo pode explorar a estrutura não rotulada; em detecção de anomalias, a verossimilhança pode falhar quando dados fora da distribuição recebem alta densidade por razões irrelevantes. Em geração aumentada por recuperação, um modelo de resposta generativo e um recuperador ou re‑ranker discriminativo formam um híbrido. Diagnostique as etapas separadamente para que a saída fluente não oculte falhas de recuperação. Escolha a decomposição que torne evidência e controle observáveis.
Implantação e governança
Sistemas generativos adicionam riscos de proveniência de conteúdo, propriedade intelectual, personificação, injeção de prompt e moderação de saída; sistemas discriminativos adicionam riscos de limiar, negação e erro desigual. Ambos exigem direitos de dados, artefatos seguros, versionamento, testes representativos, monitoramento e autoridade humana proporcional às consequências. Registre o objetivo preciso e a semântica da saída na documentação. Generativo versus discriminativo é uma distinção estatística útil, mas sistemas reais costumam combiná‑los, e a confiabilidade depende de todo o pipeline de dados e decisão.
Exemplo prático: classificando e gerando respostas de suporte
Uma plataforma de suporte usa um classificador discriminativo para identificar o tipo de problema e a urgência e um modelo generativo para rascunhar uma resposta a partir de políticas aprovadas. O classificador é avaliado com recall específico por classe e calibração; o recuperador com recall de evidência; o gerador com fundamentação, correção e recusa. Cada etapa tem um resultado desconhecido, e o modelo generativo não pode alterar a classificação ou o direito do cliente por meio de texto persuasivo.
Os agentes veem a rota prevista, as fontes e o rascunho, aprovando ou corrigindo antes do envio. Filtros de permissão são aplicados antes da recuperação, e a injeção de prompt em texto do cliente não pode autorizar ferramentas. O monitoramento separa erros de roteamento, lacunas de recuperação, declarações não suportadas e edições de agentes. Uma mudança de política atualiza as fontes imediatamente e dispara testes de regressão; ajustes são reservados para comportamento estável. O design híbrido usa forças discriminativas e generativas enquanto preserva evidência e autoridade humana.
Evidências de implementação e prontidão operacional
Uma decisão de produção precisa de mais do que uma demonstração bem‑sucedida. Defina os usuários pretendidos, ambiente operacional, entradas, saídas, dependências, responsável e a consequência de cada falha importante. Estabeleça uma linha de base reproduzível e um conjunto de avaliação versionado antes do ajuste. Teste casos ordinários, condições de fronteira, entrada malformada ou ausente, mudança de distribuição, falha de dependência, uso indevido e os grupos ou ambientes mais propensos a serem negligenciados. Meça a qualidade da tarefa junto com calibração ou incerteza, latência, taxa de transferência, custo de recursos, acessibilidade, privacidade e segurança. Registre toda transformação e limiar para que um revisor independente possa reproduzir o resultado e distinguir evidência de um protótipo atraente.
Antes do lançamento, atribua autoridade para liberação, exceções, mudanças, rollback e aposentadoria. Use um rollout em fases, preserve um fallback seguro e verifique o monitoramento com falhas injetadas deliberadamente. A telemetria operacional deve revelar qualidade de entrada, comportamento de saída, versão do modelo ou regra, saúde das dependências, intervenções humanas e resultados confirmados sem coletar dados sensíveis desnecessários. Defina limiares de alerta e um responsável pela resposta, depois revise evidências do mundo real após a implantação em vez de assumir que o desempenho offline persistirá. Reavalie sempre que fontes de dados, usuários, modelos, fornecedores, políticas, hardware ou objetivos mudarem. Um sistema mantido também necessita de procedimentos documentados de recuperação, aprendizado de incidentes, exclusão e retenção, e um ponto claro em que deve ser desativado ou substituído.
Perguntas frequentes
O discriminador de um GAN é um modelo discriminativo?
Ele realiza discriminação durante o treinamento, mas o GAN como um todo é uma estrutura generativa cujo output é produzido pelo gerador.
O aprendizado discriminativo é sempre supervisionado?
Não. O termo descreve a relação modelada ou a fronteira, enquanto supervisão descreve o sinal de treinamento. Objetivos modernos podem borrar as categorias.
Referências principais












