
Podstawy AI
Czym jest meta-uczenie?

 Dodaj Unite.AI do preferowanych źródeł w Google
Meta-learning trenuje system na rozkładzie zadań, aby mógł dostosować się do nowego, powiązanego zadania przy użyciu ograniczonych danych lub obliczeń. Często podsumowuje się to jako „uczenie się uczenia”, ale techniczny cel jest bardziej precyzyjny: optymalizacja uczącego się tak, aby doświadczenie z wcześniejszych zadań poprawiało adaptację do późniejszego.
Meta-learning zachodzi na styku z few-shot learning i transfer learning, ale terminy nie są wymienne. Few-shot opisuje ilość danych docelowych; transfer opisuje ponowne wykorzystanie; meta-learning wyraźnie czyni adaptację pomiędzy zadaniami częścią treningu.
Kluczowe wnioski
- Meta-trening wykorzystuje wiele zadań, a nie tylko wiele niezależnych przykładów.
- Odcinek N‑klasowy K‑shot zawiera N klas oraz K oznaczonych przykładów wsparcia na każdą klasę.
- Metody oparte na gradientach, metrykach, pamięci oraz uczonych optymalizatorach adaptują się na różne sposoby.
- Wydajność silnie zależy od tego, czy zadania meta‑treningu przypominają zadanie docelowe.
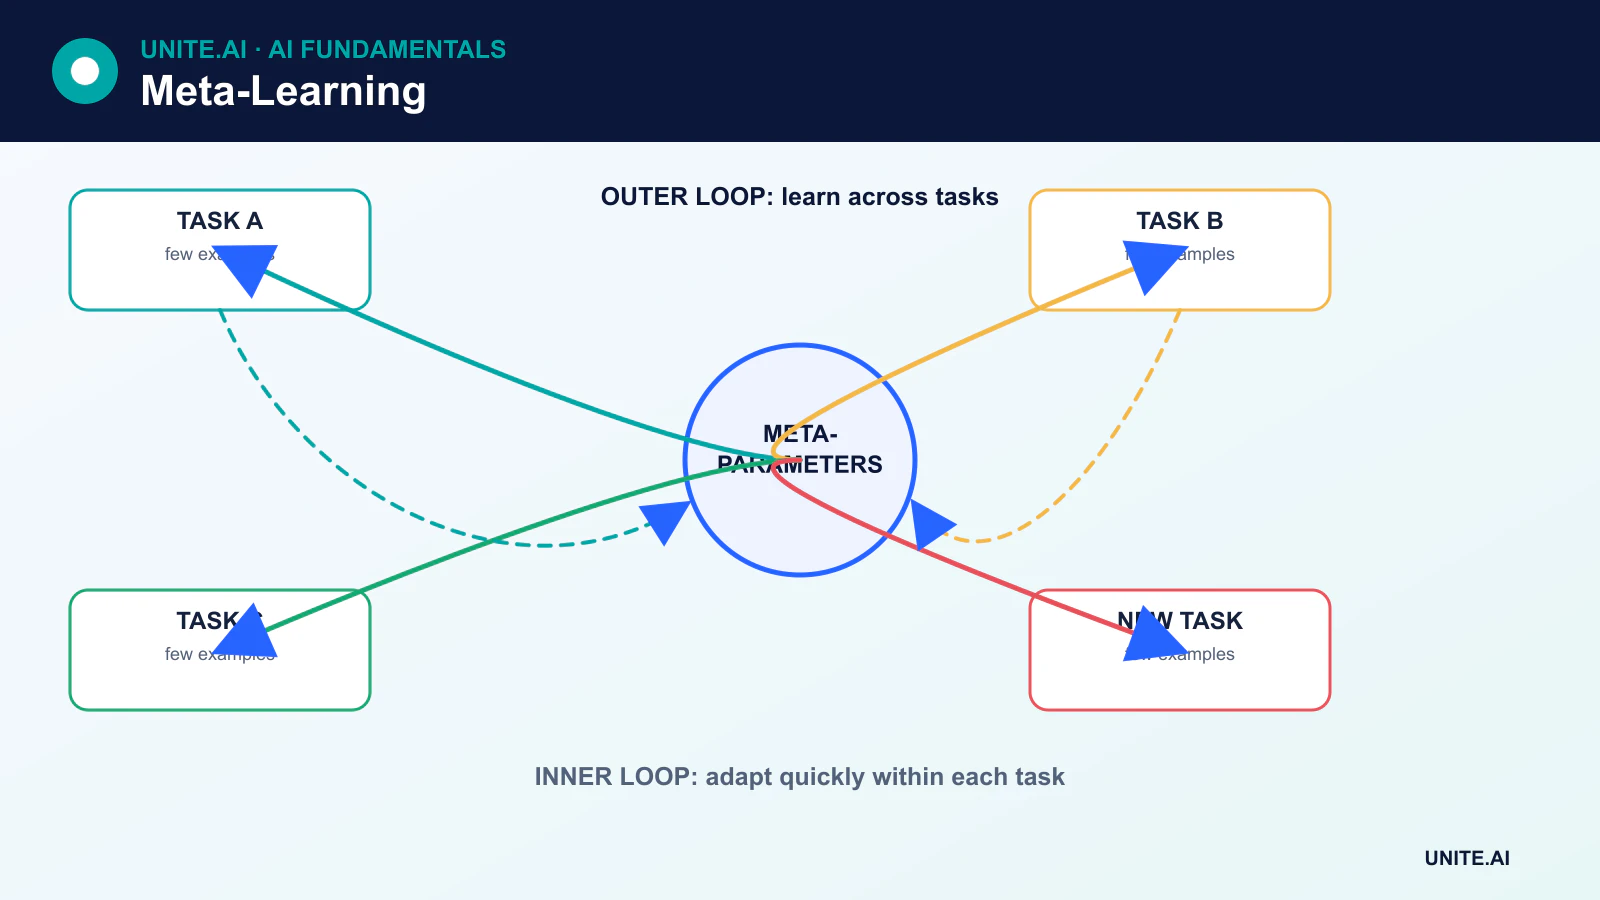
Zadania, zestawy wsparcia i zestawy zapytań
Zbiór danych meta-uczenia jest zorganizowany jako zadania. W klasyfikacji few-shot odcinek może być 5-way 1-shot: pięć klas, jeden oznaczony przykład wsparcia na klasę oraz dodatkowe przykłady zapytań używane do oceny adaptacji. Zadanie 5-way 5-shot ma pięć przykładów wsparcia dla każdej z pięciu klas — nie pięć przykładów łącznie.
Podczas meta‑treningu uczeń wielokrotnie adaptuje się na zestawie wsparcia i jest oceniany na zestawie zapytań. Zewnętrzny cel poprawia przyszłą wydajność zapytań w różnych zadaniach. Meta‑walidacja dostraja wybory na oddzielnych zadaniach, a meta‑testowanie ocenia rzeczywiście nieznane zadania lub klasy.
Meta-uczenie oparte na gradientach
Model-Agnostic Meta-Learning (MAML) uczy się inicjalizacji, z której niewielka liczba gradientu zapewnia dobrą wydajność na nowym zadaniu. Pętla wewnętrzna adaptuje parametry modelu przy użyciu danych wsparcia. Pętla zewnętrzna aktualizuje wspólną inicjalizację, wykorzystując stratę zapytań wśród wybranych zadań.
MAML nie jest ograniczony do klasyfikacji; może być stosowany do regresji i uczenia ze wzmocnieniem, gdy model i zadanie są różniczkowalne. Reptile oferuje prostsze podejście pierwszego rzędu, które przesuwa parametry w kierunku rozwiązań dostosowanych do zadania, bez obliczania pełnego meta‑gradientu MAML.
Meta-uczenie oparte na metrykach
Metody oparte na metrykach uczą się osadzenia, w którym przykłady tej samej klasy są blisko, a różne klasy są od siebie oddzielone. Sieć prototypowa uśrednia osadzenia wsparcia, tworząc jeden prototyp na klasę, a następnie klasyfikuje zapytania na podstawie odległości do tych prototypów.
Sieci typu Matching i Siamese wykorzystują powiązane mechanizmy podobieństwa. Metody te nie sprawdzają jedynie, czy model „osiąga docelową metrykę”; wyuczona odległość lub reprezentacja jest samą częścią procedury predykcji.
Metody oparte na pamięci i uczone optymalizatory
Systemy oparte na pamięci wykorzystują stan rekurencyjny lub oparty na uwadze do przechowywania informacji o bieżącym zadaniu. Uczone optymalizatory przyjmują gradienty lub sygnały treningowe jako wejścia i uczą się, jak aktualizować inny model. Metody te mogą odkrywać reguły adaptacji, ale dodają parametry, obliczenia i kolejny poziom potencjalnego przeuczenia.
Meta-uczenie i uczenie w kontekście
Duże transformatory mogą dostosowywać swoje wyjście na podstawie przykładów podanych w promptcie, bez aktualizacji wag. Nazywa się to uczeniem w kontekście. Przypomina zachowanie meta‑uczenia, a dane treningowe mogą zachęcać do wnioskowania o zadaniu, jednak uczeń w kontekście nie jest automatycznie trenowany klasycznym epizodycznym celem meta‑uczenia.
Gdzie meta-uczenie jest przydatne
Potencjalne zastosowania obejmują personalizację, robotykę, rozpoznawanie przy ograniczonych zasobach, zadania naukowe z niewielką liczbą pomiarów oraz szybkie dostosowywanie się do nowych środowisk. Meta‑uczenie jest najbardziej atrakcyjne, gdy dostępnych jest wiele powiązanych zadań źródłowych, a dane zadania docelowego są skąpe.
Ograniczenia
Meta‑uczenie może być kosztowne obliczeniowo, ponieważ trening zagnieżdża adaptację w optymalizacji. Wyniki są wrażliwe na konstrukcję zadań, wyciek danych wsparcia/zapytań, architekturę i przesunięcie domeny. Model wytrenowany na wąskich, jednorodnych zadaniach może słabo adaptować się poza tą dystrybucją.
Porównania powinny obejmować zwykłe baselines transfer‑learningu i multitasku. Silna wstępnie wytrenowana reprezentacja, a następnie standardowe dostrajanie, może być prostsza i skuteczniejsza niż dedykowany algorytm meta‑uczenia.
Zadania, adaptacja i struktura optymalizacji wewnętrznej‑zewnętrznej
Meta‑uczenie trenuje na rozkładzie zadań, aby uczeń mógł dostosować się do nowego zadania przy ograniczonych danych lub aktualizacjach. Każdy odcinek losuje zadanie, dzieli przykłady na zestaw wsparcia używany do adaptacji i zestaw zapytań używany do oceny, oraz aktualizuje wspólną wiedzę pomiędzy odcinkami. Metody oparte na metrykach uczą się osadzenia i reguły porównania; metody oparte na optymalizacji uczą się inicjalizacji lub zachowania aktualizacji; metody oparte na pamięci i modelu warunkują się na przykładach zadania. Rozkład zadań jest rzeczywistymi danymi treningowymi i musi przypominać przyszłe problemy adaptacyjne.
W model‑agnostic meta‑learning pętla wewnętrzna adaptuje parametry na przykładach wsparcia, a pętla zewnętrzna optymalizuje wydajność na przykładach zapytań po adaptacji. Gradienty wyższego rzędu mogą być kosztowne; przybliżenia pierwszego rzędu wymieniają wierność na koszt. Sieci prototypowe reprezentują każdą klasę przez centroid zestawu wsparcia i klasyfikują na podstawie odległości. Metody te zakładają, że geometria klas, kroki adaptacji i konstrukcja odcinków odzwierciedlają wdrożenie. Metoda może wydawać się szybko się uczyć, wykorzystując stałe etykiety, artefakty pozyskiwania lub nakładanie się zestawów źródłowych.
Ewaluacja, baseline’y i ograniczenia w rzeczywistym świecie
Oddzielne zadania treningowe, walidacyjne i testowe — nie tylko przykłady — służą do pomiaru adaptacji do rzeczywiście niewidzianych zadań. Raportuj dokładność lub stratę jako funkcję liczby przykładów (shots) i kroków adaptacji, przedziały ufności wśród zadań, zużycie obliczeń, pamięci oraz wrażliwość na skład zestawu wsparcia. Porównuj z transfer learningiem, dostrajaniem wstępnie wytrenowanego modelu, najbliższymi sąsiadami oraz modelem trenowanym wspólnie na wszystkich danych źródłowych. Wiele pozornych korzyści meta‑uczenia maleje, gdy baseline’y otrzymują równoważne podstawy, augmentację i dostrajanie.
Rzeczywiste wdrożenia potrzebują sposobu rozpoznania, kiedy nowe zadanie leży poza rozkładem meta‑treningu. Słabe lub nieprawidłowo oznaczone przykłady wsparcia mogą spowodować szybkie, pewne niepowodzenie. Ogranicz wielkość aktualizacji, waliduj dostosowane modele, zachowaj plan awaryjny i chroń dane adaptacyjne przed zatruwaniem. Śledź model bazowy, sampler zadań, nasiona odcinków oraz kod adaptacji. Meta‑uczenie jest przydatne dla powtarzalnych rodzin problemów z małą ilością danych, ale nie tworzy ogólnej zdolności uczenia się z dowolnych przykładów i nie eliminuje potrzeby oceny specyficznej dla domeny.
Przykład praktyczny: adaptacja few-shot pomiędzy maszynami
Producent traktuje każdy typ maszyny jako zadanie i meta‑trenuje reprezentację anomalii na wielu maszynach z zweryfikowanymi wynikami konserwacji. Maszyny testowe są całkowicie wykluczone z treningu zadań. Dla nowej maszyny mały zestaw wsparcia obejmuje normalne tryby pracy, a nie dowolne minuty danych. Meta‑uczenie jest porównywane z wstępnie wytrenowanym zamrożonym enkoderem, najbliższymi sąsiadami oraz zwykłym dostrajaniem przy użyciu tych samych przykładów wsparcia i zasobów obliczeniowych.
Ewaluacja powtarza wiele wyborów wsparcia i raportuje przypomnienie zdarzeń, fałszywe alarmy, czas adaptacji oraz wariancję. System wstrzymuje się, gdy zestaw czujników lub dynamika nowej maszyny wykracza poza rozkład zadań. Aktualizacje adaptacji są ograniczone i przeglądane przed wpływem na konserwację. Etykiety wsparcia i tożsamość maszyny są chronione przed zatruwaniem, a każdy dostosowany model zachowuje swoją wersję bazową i przykłady. Szybka adaptacja jest akceptowana tylko wtedy, gdy konsekwentnie przewyższa prostszy transfer przy realistycznym przesunięciu zadania.
Dowody implementacyjne i gotowość operacyjna
Decyzja produkcyjna wymaga więcej niż udanej demonstracji. Zdefiniuj docelowych użytkowników, środowisko operacyjne, wejścia, wyjścia, zależności, właściciela oraz konsekwencje każdego istotnego błędu. Ustal reprodukowalną bazę odniesienia i wersjonowany zestaw ewaluacyjny przed dostrajaniem. Testuj typowe przypadki, warunki brzegowe, nieprawidłowe lub brakujące dane wejściowe, przesunięcie rozkładu, awarie zależności, niewłaściwe użycie oraz grupy lub środowiska najbardziej narażone na niedostateczną obsługę. Mierz jakość zadania wraz z kalibracją lub niepewnością, opóźnieniem, przepustowością, kosztami zasobów, dostępnością, prywatnością i bezpieczeństwem. Zarejestruj każdą transformację i próg, aby niezależny recenzent mógł odtworzyć wynik i odróżnić dowody od atrakcyjnego prototypu.
Przed uruchomieniem przydziel uprawnienia do wydania, wyjątków, zmian, wycofania i wycofania. Użyj stopniowanego wdrożenia, zachowaj bezpieczną opcję awaryjną i zweryfikuj monitorowanie przy celowo wprowadzonych awariach. Telemetria operacyjna powinna ujawniać jakość danych wejściowych, zachowanie wyjść, wersję modelu lub reguły, stan zależności, interwencje ludzkie oraz potwierdzone wyniki, bez gromadzenia niepotrzebnych danych wrażliwych. Zdefiniuj progi alarmowe i właściciela reakcji, a następnie przeglądaj dowody z rzeczywistego świata po wdrożeniu, zamiast zakładać, że wydajność offline będzie trwała. Ponownie oceń, gdy zmienią się źródła danych, użytkownicy, modele, dostawcy, polityki, sprzęt lub cele. Utrzymany system wymaga także udokumentowanego przywracania, nauki z incydentów, procedur usuwania i przechowywania oraz wyraźnego momentu, w którym powinien zostać wyłączony lub zastąpiony.
Najczęściej zadawane pytania
Czy few-shot prompting jest meta‑uczeniem?
Few-shot prompting jest techniką adaptacji w kontekście. Może wykazywać zachowanie kojarzone z uczeniem się pomiędzy zadaniami, ale nie jest automatycznie trenowany przy użyciu odcinków wsparcia/zapytań ani explicite pętli meta‑optymalizacji.
Jaka jest największe ryzyko meta‑uczenia?
Niezgodność między zadaniami meta‑treningu a zadaniem docelowym może sprawić, że szybka adaptacja wydaje się silna w benchmarku, ale zawodzi w rzeczywistym wdrożeniu. Podziały zadań i pochodzenie danych źródłowych muszą być audytowane tak samo starannie, jak zwykłe podziały trening/test.
Podstawowe odniesienia











