
Podstawy AI
Czym jest uczenie ze wzmocnieniem?

 Dodaj Unite.AI do preferowanych źródeł w Google
Uczenie ze wzmocnieniem (RL) jest ramą uczenia maszynowego, w której agent uczy się, jak działać, poprzez interakcję ze środowiskiem. Po każdej akcji środowisko zmienia się i może zwrócić nagrodę. Celem agenta jest nauczenie się polityki, która maksymalizuje oczekiwaną skumulowaną nagrodę, a nie jedynie nagrodę za kolejny ruch.
RL jest stosowane, gdy decyzje rozciągają się w czasie i jedna akcja wpływa na to, co nastąpi później. Jest to koncepcyjnie inne niż uczenie nadzorowane, w którym zestaw danych dostarcza docelową odpowiedź dla każdego przykładu treningowego.
Kluczowe wnioski
- Problem RL zawiera agenta, środowisko, stany, akcje, nagrody oraz politykę.
- Pozytywne i negatywne wzmocnienie zarówno zwiększają zachowanie; kara zmniejsza zachowanie.
- Agent musi równoważyć eksplorację nieznanych akcji z eksploatacją akcji już znanych jako skuteczne.
- Metody oparte na wartości, polityce, aktorze‑krytyku, modelu oraz offline rozwiązują różne ustawienia RL.
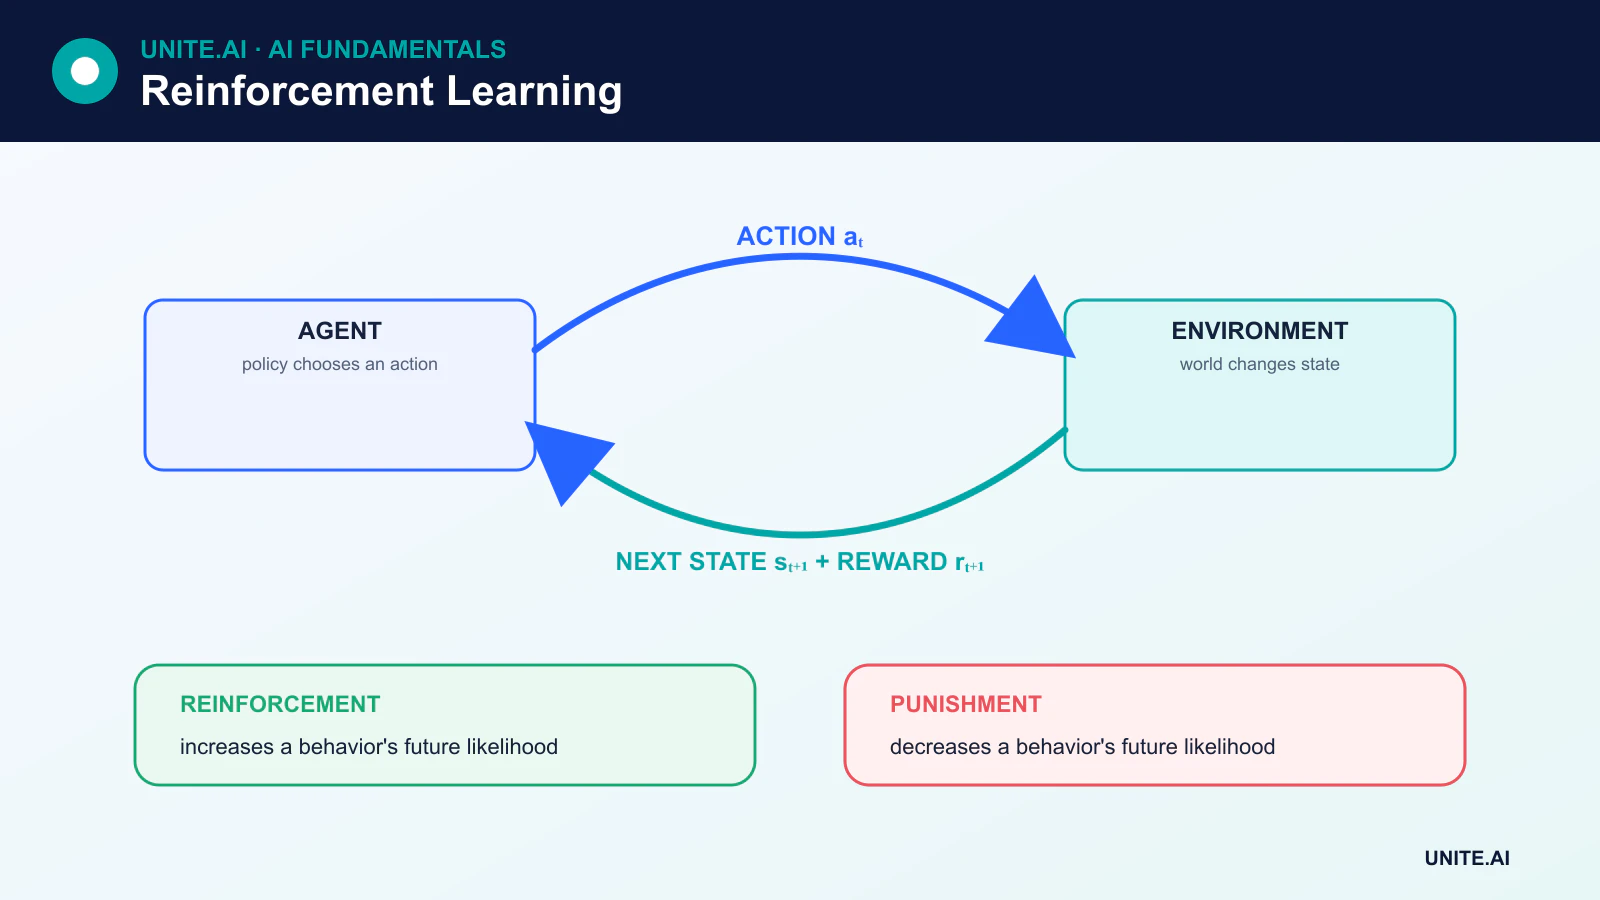
Składniki uczenia ze wzmocnieniem
Wiele problemów RL jest modelowanych jako proces decyzyjny Markowa (MDP). MDP obejmuje:
- Stan: informacje opisujące bieżącą sytuację.
- Akcja: dostępny wybór dla agenta.
- Przejście: sposób, w jaki stan zmienia się po akcji.
- Nagroda: natychmiastowa informacja zwrotna generowana przez przejście.
- Polityka: strategia agenta w wyborze akcji.
- Współczynnik dyskontowy: jak silnie przyszłe nagrody liczą się w porównaniu do natychmiastowych.
Stan nie musi ujawniać wszystkiego o świecie. Gdy istotne informacje są ukryte, problem może być częściowo obserwowalny i agent może potrzebować pamięci lub stanu wiary.
Wzmocnienie nie jest tym samym co kara
Terminologia pochodzi z psychologii behawioralnej. Pozytywne wzmocnienie dodaje konsekwencję, która zwiększa prawdopodobieństwo zachowania. Negatywne wzmocnienie usuwa nieprzyjemny warunek i również zwiększa prawdopodobieństwo zachowania. Kara, mająca na celu zmniejszenie prawdopodobieństwa danej akcji, nie jest negatywnym wzmocnieniem.
W uczeniu maszynowym praktycy częściej mówią bezpośrednio o pozytywnych nagrodach, negatywnych nagrodach, kosztach i karach. Istotną kwestią jest to, jak te sygnały kształtują zwrot, który agent stara się maksymalizować.
Zwrot, wartość i przydzielanie kredytu
Nagroda opisuje jedno przejście. Zwrot łączy nagrody w czasie, zwykle dyskontując nagrody, które pojawiają się dalej w przyszłości. Funkcja wartości stanu szacuje oczekiwany zwrot ze stanu, natomiast funkcja wartości akcji szacuje oczekiwany zwrot po podjęciu konkretnej akcji w tym stanie.
Powoduje to problem przydzielania kredytu: jeśli użyteczny wynik pojawia się znacznie później, które wcześniejsze akcje zasługują na kredyt? Algorytmy RL różnią się w sposobie szacowania tej zależności.
Uczenie Monte Carlo i metod różnicy czasowej
Metody Monte Carlo uczą się na podstawie pełnych próbkowanych zwrotów, zazwyczaj po zakończeniu epizodu. Metody różnicy czasowej (TD) aktualizują szacowanie przed ostatecznym wynikiem, łącząc obserwowaną nagrodę z szacunkiem tego, co nastąpi dalej. Uczenie TD więc bootstrapuje z bieżących szacunków wartości.
Żadna z rodzin nie jest uniwersalnie lepsza. Cele Monte Carlo są nieobciążone przy danej polityce próbkowania, ale mogą mieć wysoką wariancję i wymagać zakończenia epizodu. Metody TD mogą uczyć się online i z zadań ciągłych, ale ich bootstrapowane cele wprowadzają bias.
Eksploracja kontra eksploatacja
Eksploracja zbiera informacje, próbując akcji, których wartość jest niepewna. Eksploatacja wybiera akcję, która obecnie uważa się za dającą najlepszy zwrot. Agent, który nigdy nie eksploruje, może utknąć przy słabej strategii; agent, który nigdy nie eksploatuje, nie korzysta z tego, czego się nauczył.
Proste strategie obejmują wybór akcji epsilon-chciwy, eksplorację opartą na pewności, bonusy entropii oraz metody nagród wewnętrznych. W środowiskach krytycznych pod względem bezpieczeństwa nieograniczona eksploracja może być nieakceptowalna, dlatego ważne stają się symulacje, ograniczenia, dane offline lub nadzór człowieka.
Główne podejścia w uczeniu ze wzmocnieniem
Metody oparte na wartości
Q-learning i powiązane algorytmy uczą się wartości akcji i wyprowadzają politykę poprzez wybór akcji o wysokiej wartości. Głębokie uczenie ze wzmocnieniem wykorzystuje sieci neuronowe do przybliżania funkcji wartości lub polityk, gdy przestrzenie stanów są zbyt duże dla tabeli.
Metody gradientu polityki
Metody gradientu polityki bezpośrednio dostosowują parametryzowaną politykę, aby poprawić oczekiwany zwrot. Są przydatne przy akcjach ciągłych i politykach stochastycznych, ale mogą mieć wysokowariancyjne szacunki gradientu.
Metody aktor‑krytyk
Aktor wybiera akcje, podczas gdy krytyk szacuje wartość i dostarcza sygnał uczący. Łączy to bezpośrednią optymalizację polityki z estymacją wartości.
Uczenie ze wzmocnieniem oparte na modelu i bez modelu
Systemy oparte na modelu uczą się lub wykorzystują model przejść i nagród, aby móc planować. Systemy bez modelu uczą się wartości lub polityk bez explicytnego modelowania środowiska. Metody oparte na modelu mogą efektywnie wykorzystywać doświadczenie, ale błędy w wyuczonym modelu mogą wprowadzać w błąd planowanie.
Uczenie ze wzmocnieniem offline
Uczenie ze wzmocnieniem offline uczy się na podstawie stałego zestawu danych, zamiast zbierać nowe interakcje podczas treningu. Może to zmniejszyć koszt lub ryzyko eksploracji, ale agent musi unikać przeszacowywania akcji słabo reprezentowanych w danych.
RLHF i preferencje ludzkie
Uczenie ze wzmocnieniem z ludzką informacją zwrotną (RLHF) wykorzystuje dane preferencyjne do trenowania sygnału nagrody lub bezpośredniej optymalizacji polityki. Było używane do dopasowania zachowania modeli językowych do ludzkich ocen. Optymalizacja preferencji nie jest gwarancją prawdy ani bezpieczeństwa: wyniki zależą od tego, kto dostarczył informacje zwrotne, co zostało poproszone o ocenę i jak zaprojektowano cel.
Ograniczenia
RL może wymagać ogromnej liczby interakcji, zachowywać się niestabilnie podczas treningu oraz wykorzystywać niezamierzone skróty w funkcji nagrody. Ocena jest trudna, ponieważ wyniki mogą się różnić w zależności od losowych ziaren i szczegółów środowiska. Dobre praktyki obejmują wielokrotne uruchomienia, przejrzyste baseline’y, ograniczone cele, testowanie poza rozkładem oraz monitorowanie pod kątem manipulacji nagrodą.
Projektowanie problemu RL: stan, akcja, nagroda i horyzont
Uczenie ze wzmocnieniem modeluje decyzje sekwencyjne. Środowisko generuje obserwację, agent wybiera akcję zgodnie z polityką, a przejście daje nagrodę i kolejną obserwację. Proces decyzyjny Markowa zakłada, że stan zawiera informacje potrzebne do przewidywania przyszłych przejść i nagród; częściowa obserwowalność wymaga pamięci, stanu wiary lub reprezentacji rekurencyjnych. Dyskontowanie kontroluje wagę opóźnionych wyników, podczas gdy zadania epizodyczne i ciągłe wymagają różnych definicji zwrotu. Zły projekt stanu lub akcji może sprawić, że rozwiązywalny cel stanie się nie do nauczenia.
Projektowanie nagrody określa zachowanie pośrednio i jest głównym źródłem niepowodzeń. Proxy może być wykorzystywane: agent nagradzany za szybkość może ignorować bezpieczeństwo, podczas gdy agent nagradzany jedynie po zakończeniu zadania może otrzymywać zbyt mały sygnał uczący. Dodaj ograniczenia i reguły zakończenia oparte na rzeczywistych wymaganiach, testuj wrażliwość nagrody i analizuj trajektorie pod kątem niezamierzonych strategii. Metody eksploracji równoważą zbieranie informacji z eksploatacją bieżącej wiedzy. Dane off-policy mogą poprawić efektywność próbkowania, ale niezgodność między polityką zachowania a docelową wymaga algorytmów do tego przystosowanych.
Ewaluacja, symulacja i bezpieczne wdrożenie
Metody oparte na wartości szacują oczekiwany zwrot dla stanów lub akcji; metody gradientu polityki optymalizują parametryzowaną politykę; metody aktor‑krytyk uczą się obu. Uczenie ze wzmocnieniem oparte na modelu uczy się lub wykorzystuje dynamikę przejść do planowania. Odpowiednia rodzina zależy od typu akcji, danych, dokładności symulatora, horyzontu i wymagań stabilności. Porównuj z heurystycznymi, nadzorowanymi i bazowymi rozwiązaniami teorii sterowania. Oceń średni i najgorszy zwrot, naruszenia ograniczeń, efektywność próbkowania, odporność na zmiany środowiska oraz wariancję między ziarnami, zamiast wybierać uruchomienie z najlepszą krzywą uczenia.
Online’owa eksploracja może być nieakceptowalna w opiece zdrowotnej, finansach, robotyce i infrastrukturze. Trenuj w symulacji lub na zarejestrowanych danych, gdzie to możliwe, oszacuj lukę między symulatorem a rzeczywistością i ostrożnie stosuj ewaluację off-policy, ponieważ niewidziane akcje nie mają wsparcia. Wdrożenie powinno ograniczać akcje, tempo, zasoby i obszar operacyjny; zawierać zatwierdzenie człowieka dla istotnych wyborów oraz zapewniać bezpieczny kontroler lub wyłączenie. Monitoruj nagrodę wraz z rzeczywistymi wynikami, ponieważ agent może poprawiać swój wynik, szkodząc zamierzonemu celowi. Ponownie waliduj po zmianach środowiska, polityki lub nagrody.
Przykładowe zastosowanie: sterowanie energią przy użyciu uczenia ze wzmocnieniem
Operator budynku modeluje temperaturę, zajętość, pogodę, stan urządzeń oraz cenę energii elektrycznej, przy akcjach ograniczonych do bezpiecznych regulacji punktu nastaw. Nagroda łączy komfort, zużycie energii, opłaty za popyt oraz ograniczenia sprzętu, ale rzeczywiste naruszenia komfortu są oceniane osobno, więc optymalizacja nagrody nie może ukrywać szkód. Kontrola historyczna i sterowanie predykcyjne modelem stanowią baseline’y. Trening wykorzystuje skalibrowany symulator z losową pogodą, szumem czujników i efektywnością sprzętu.
Przed wpływem na budynek polityka jest uruchamiana na żywych obserwacjach bez podejmowania działań. Inżynierowie analizują trajektorie, marginesy ograniczeń oraz zachowanie podczas świąt, fal upałów, awarii i brakujących czujników. Wdrożenie ogranicza tempo i zakres akcji oraz zachowuje istniejący kontroler bezpieczeństwa. Człowiek może w każdej chwili przejąć kontrolę. Monitorowanie porównuje zużycie energii i komfort w dopasowanych okresach, rejestruje interwencje i cofa zmiany, jeśli naruszenia, nieoczekiwane cykle lub niezgodność modelu przekroczą określone progi.
Dowody wdrożeniowe i gotowość operacyjna
Decyzja produkcyjna wymaga więcej niż udanej demonstracji. Zdefiniuj docelowych użytkowników, środowisko operacyjne, wejścia, wyjścia, zależności, właściciela oraz konsekwencje każdego istotnego błędu. Ustal powtarzalny baseline i wersjonowany zestaw ewaluacyjny przed strojeniem. Testuj typowe przypadki, warunki brzegowe, niepoprawne lub brakujące dane wejściowe, zmianę rozkładu, awarie zależności, niewłaściwe użycie oraz grupy lub środowiska najprawdopodobniej niedostatecznie obsłużone. Mierz jakość zadania wraz z kalibracją lub niepewnością, opóźnieniem, przepustowością, kosztami zasobów, dostępnością, prywatnością i bezpieczeństwem. Rejestruj każdą transformację i próg, aby niezależny recenzent mógł odtworzyć wynik i odróżnić dowód od atrakcyjnego prototypu.
Przed uruchomieniem przydziel odpowiedzialność za wydanie, wyjątki, zmiany, wycofanie i wycofanie produktu. Użyj etapowego wdrożenia, zachowaj bezpieczną rezerwę i zweryfikuj monitorowanie poprzez celowo wprowadzane awarie. Telemetria operacyjna powinna ujawniać jakość danych wejściowych, zachowanie wyjść, wersję modelu lub reguły, stan zależności, interwencje ludzkie oraz potwierdzone wyniki, nie gromadząc niepotrzebnych wrażliwych danych. Zdefiniuj progi alarmowe i właściciela reakcji, a następnie przeglądaj dowody z rzeczywistego świata po wdrożeniu, zamiast zakładać, że wydajność offline będzie trwała. Przeprowadzaj ponowną ocenę, gdy zmieniają się źródła danych, użytkownicy, modele, dostawcy, polityki, sprzęt lub cele. Utrzymany system wymaga także udokumentowanego przywracania, nauki z incydentów, procedur usuwania i przechowywania oraz wyraźnego momentu, w którym powinien zostać wyłączony lub zastąpiony.
Podstawowe źródła












