Podstawy AI
Czym są duże modele językowe (LLM)?

 Dodaj Unite.AI do preferowanych źródeł w Google
Duży model językowy (LLM) to sieć neuronowa trenowana na dużych zbiorach sekwencji w celu przewidywania tokenów lub pokrewnych celów językowych. Większość współczesnych LLM‑ów wykorzystuje architektury transformer i może generować, klasyfikować, podsumowywać, tłumaczyć, wyszukiwać i przekształcać język za pośrednictwem wspólnego interfejsu.
LLM nie jest bazą danych ani gwarantowanym rozumowaniem. Jego wyjście to warunkowe przewidywanie kształtowane przez dane treningowe, fazę po‑treningową, kontekst, narzędzia i dekodowanie. Płynność może współistnieć z błędami faktograficznymi, niepewnością, uprzedzeniami lub niebezpiecznym zachowaniem.
Kluczowe wnioski
- Tokenizacja zamienia tekst w dyskretne jednostki; osadzenia i mechanizm uwagi tworzą kontekstowe reprezentacje.
- Pre‑trening uczy ogólnych wzorców, podczas gdy dostrajanie i metody preferencyjne kształtują zachowanie w zadaniach.
- Wyszukiwanie i narzędzia mogą dodać aktualne dowody lub akcje, ale wymagają odrębnych uprawnień i weryfikacji.
- Oceniaj wdrożony system pod kątem jakości, ugruntowania, bezpieczeństwa, opóźnień, kosztów i dryfu.
Tokeny, transformatory i pre‑trening
Tekst jest dzielony na tokeny. Transformer mapuje je na wektory, miesza informacje za pomocą mechanizmu uwagi i warstw feed‑forward oraz generuje rozkład prawdopodobieństwa dla kolejnego lub brakującego tokenu.
Cele samonadzorowane tworzą sygnały treningowe z surowych sekwencji. Skalowanie liczby parametrów, danych i mocy obliczeniowej może przewidywalnie zmniejszać stratę w określonych zakresach, lecz jakość zestawu danych, architektura, optymalizacja i ocena decydują o tym, jakie możliwości pojawiają się w praktyce.
Faza po‑treningowa i wnioskowanie
Dostrajanie instrukcji wykorzystuje demonstracje; optymalizacja preferencji może sprawić, że wyniki lepiej odpowiadają ocenom ludzkim lub polityce. Podczas wnioskowania podpowiedź i historia konwersacji definiują kontekst, a temperatura i ustawienia próbkowania wpływają na zmienność.
RLHF i podobne metody kształtują zachowanie, zamiast instalować pełny weryfikator faktów. Model nadal może wygenerować wiarygodną, lecz niepopartą odpowiedź.
Wyszukiwanie, narzędzia i agenci
Generowanie wspomagane wyszukiwaniem dostarcza fragmenty wybrane z zewnętrznej kolekcji. Wywoływanie narzędzi pozwala kodowi aplikacji na zapytania do baz danych, obliczenia, wyszukiwanie lub wykonywanie akcji. Te wzorce oddzielają część wiedzy i wykonania od wag modelu.
Aplikacja musi weryfikować argumenty narzędzi, egzekwować uprawnienia, zachowywać cytowania i traktować pobrane treści jako niewiarygodny input. Wyszukiwanie podobieństwa wektorowego wspomaga wyszukiwanie, ale nie dowodzi, że fragment wspiera odpowiedź.
Ograniczenia i ocena
LLM‑y mogą halucynować, ujawniać zapamiętaną treść, podążać za złośliwymi instrukcjami, reprodukować uprzedzenia i nie radzić sobie z zadaniami, które wydają się podobne do przykładów treningowych. Długi kontekst nie gwarantuje, że każda informacja zostanie użyta lub prawidłowo zreconcylowana.
Ocenić na reprezentatywnych, prywatnych zadaniach z udokumentowanymi podpowiedziami i wersjami. Mierzyć wsparcie przez źródła, odrzucenia, kalibrację, bezpieczeństwo, wyniki podgrup, obciążenie ludzkie, opóźnienia i koszty. Monitorować po wydaniu, ponieważ modele, dane i zachowanie użytkowników się zmieniają.
Dane treningowe i rozwój modelu
Korpusy pre‑treningowe łączą strony internetowe, książki, kod, materiały akademickie, rozmowy oraz licencjonowane lub kuratorowane źródła. Potoki wykrywają język, usuwają duplikaty, filtrują jakość i niebezpieczną treść, obsługują dane osobowe i wybierają wagi mieszanek. Te decyzje kształtują wiedzę, zakres językowy, styl, uprzedzenia i zapamiętywanie.
Procesy optymalizacji przetwarzają partie sekwencji tokenów i minimalizują stratę predykcji przy użyciu spadku gradientowego. Rozproszone treningi dzielą dane, tensory modelu, etapy potoku lub ekspertów na akceleratory. Zapisywanie punktów kontrolnych, stabilność numeryczna, komunikacja sieciowa i odzyskiwanie po awarii stają się kluczowymi kwestiami inżynieryjnymi przy dużej skali.
Ocena w trakcie treningu śledzi stratę i zestawy zdolności, ale zanieczyszczenie benchmarków może zawyżać wyniki. Trzymaj odrębne okresy czasowe i zadania własnościowe, sprawdzaj nakładanie się i raportuj dokładne podpowiedzi, dekodowanie, narzędzia oraz punktację. Model może poprawić średnią stratę, podczas gdy regresje pojawiają się w bezpieczeństwie lub w języku o niskich zasobach.
Okna kontekstowe, dekodowanie i wnioskowanie
Podczas wnioskowania pamięć podręczna klucz‑wartość przechowuje projekcje uwagi dla wcześniejszych tokenów, dzięki czemu nie muszą być ponownie obliczane na każdym kroku. Pamięć podręczna rośnie wraz z liczbą warstw, długością sekwencji, wsadami i reprezentacją. Kwantyzacja i stronicowanie zmniejszają obciążenie, ale mogą zmienić jakość lub opóźnienie.
Dekodowanie zachłanne wybiera token o najwyższym prawdopodobieństwie; temperatura przeskalowuje prawdopodobieństwa; top‑k i top‑p ograniczają zestaw kandydatów; przeszukiwanie wiązkowe śledzi kilka sekwencji. Najlepsza strategia zależy od tego, czy zadanie ceni deterministyczność, różnorodność, strukturalny wynik czy prawdopodobieństwo sekwencji. Zawsze weryfikuj schemat po generacji.
Długi kontekst zwiększa ilość dostępnych informacji, ale nie zapewnia gwarantowanego przypomnienia ani rozumowania. Pozycja, rozpraszacze, sprzeczności i struktura podpowiedzi wpływają na użycie. Wyszukiwanie może wybrać mniejszy zestaw dowodów, podczas gdy podsumowanie kompresuje historię kosztem utraty szczegółów. Mierz wydajność w zależności od długości i miejsca kontekstu.
Adaptacja, wdrożenie i ekonomia
Pełne dostrajanie aktualizuje wszystkie parametry; metody efektywne pod względem parametrów aktualizują adaptery lub macierze o niskim rzędzie; kontynuowany pre‑trening dostosowuje rozkład domeny; dostrajanie instrukcji i preferencji kształtuje odpowiedzi. Wyszukiwanie jest często lepsze przy często zmieniających się faktach, podczas gdy dostrajanie lepiej sprawdza się w zachowaniu i formacie zadania. Metody można łączyć.
Opcje wdrożenia obejmują hostowane API, zarządzane punkty końcowe, samodzielnie hostowane otwarte wagi, modele na urządzeniu oraz hybrydy. Porównaj obsługę danych, kontrolę wersji, opóźnienia, przepustowość, regiony, dostępność, przenośność modelu, wsparcie i całkowite koszty. Samodzielne hostowanie przenosi odpowiedzialność za bezpieczeństwo, skalowanie, aktualizacje i monitorowanie nadużyć.
Koszt za token jest niepełny. Słaby model może wymagać ponownych prób, dłuższych podpowiedzi, większej liczby recenzji lub kosztownych błędów. Mierz koszt za pomyślnie zakończone zadanie przy wymaganej jakości i poziomie ryzyka. Wykorzystuj buforowanie, grupowanie, mniejsze modele routowane oraz deterministyczny kod tam, gdzie poprawiają one cały przepływ pracy.
Przykładowe zastosowanie: osadzenie LLM w dokumentach przedsiębiorstwa
Asystent dokumentów powinien zaczynać od korpusu świadomego uprawnień, stabilnych identyfikatorów dokumentów, wersji i dat obowiązywania, struktury możliwej do parsowania oraz zestawu oceny zawierającego pytania możliwe do odpowiedzi, niemożliwe, niejednoznaczne i sprzeczne. Indeksy wyszukiwania dzielą dokumenty na fragmenty i metadane, ale rozmiar fragmentu i nakładanie się muszą odpowiadać strukturze dokumentu. Jakość wyszukiwania jest mierzona niezależnie przed generacją, aby płynny model nie mógł ukrywać brakujących dowodów.
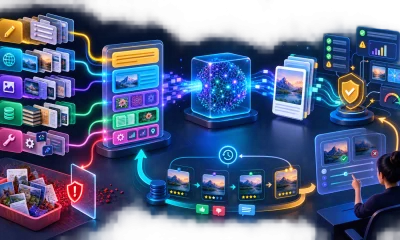
W czasie działania uwierzytelnij użytkownika, filtruj wyszukiwanie według dostępu, pobierz i przerejestruj dowody, skonstruuj ograniczoną podpowiedź, wygeneruj odpowiedź z cytatem i zweryfikuj wymaganą output. Model powinien wskazać, kiedy źródła są sprzeczne lub nie wspierają odpowiedzi. Użycie narzędzi i zewnętrznych akcji wymaga odrębnej autoryzacji. Chroń przed instrukcjami osadzonymi w pobranych dokumentach, traktując treść jako dane, a nie jako politykę systemową o wyższym priorytecie.
Oceń przywołanie przy wyszukiwaniu, precyzję cytowań, poprawność odpowiedzi, ugruntowanie, odrzucenia, opóźnienia i koszty w różnych rolach i typach dokumentów. Śledź wersje modelu, podpowiedzi, indeksu, parsera i korpusu dla każdego testu. W produkcji rejestruj identyfikatory dowodów i opinie bez ujawniania prywatnego tekstu, monitoruj nowe pytania nieodpowiedzialne po zmianach treści i utrzymuj bezpieczną alternatywę. Interfejs LLM nie zastępuje zarządzania rekordami, kontroli dostępu ani odpowiedzialnego przeglądu merytorycznego.
Planowanie pojemności powinno modelować rozkłady długości podpowiedzi i wyjścia, liczbę jednoczesnych użytkowników, zachowanie pamięci podręcznej, opóźnienia narzędzi oraz wskaźniki ponownych prób. Streaming poprawia postrzegane opóźnienie, ale utrudnia moderację i anulowanie, ponieważ niebezpieczna lub niepoprawna treść może dotrzeć do użytkownika przed sprawdzeniem pełnej odpowiedzi. Ustal budżety tokenów i narzędzi, izoluj najemców, chroń poświadczenia dostawcy i przećwicz przełączenie awaryjne między wersjami modeli bez cichej zmiany zachowania, na które liczą użytkownicy.
Lista kontrolna praktycznej implementacji
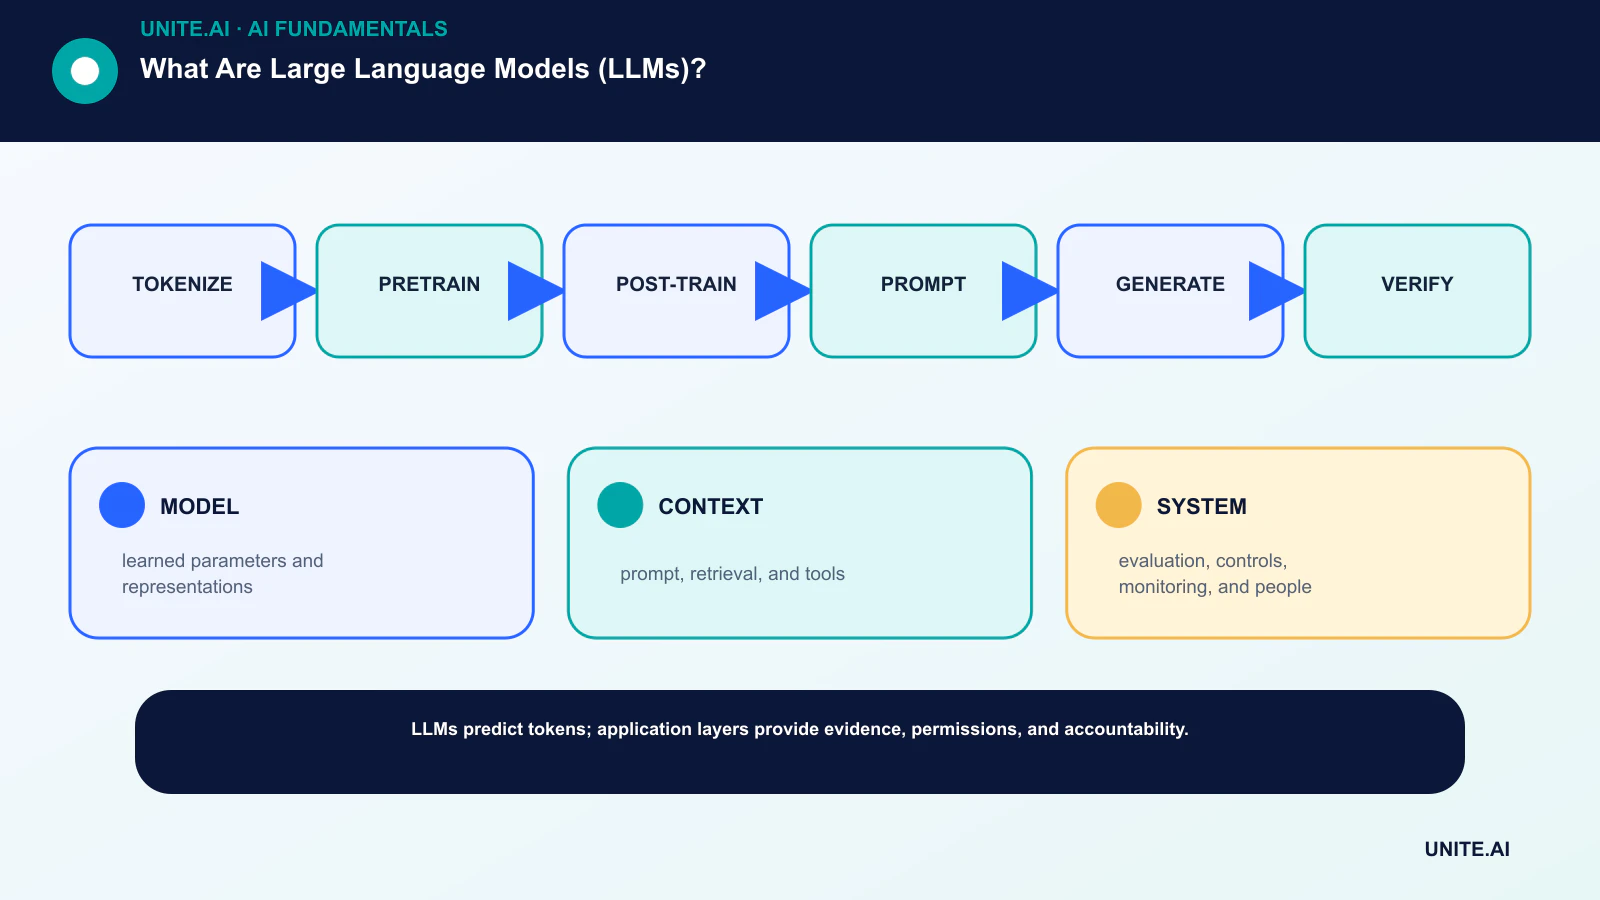
Przekształć koncepcję w ograniczony, testowalny przepływ pracy: tokenizacja → pre‑trening → post‑trening → podpowiedź → generowanie → weryfikacja. Wyznacz odpowiedzialnego właściciela, udokumentuj dane i zależności, ustal prostą bazę, określ kryteria akceptacji i zakończenia, przetestuj reprezentatywne niepowodzenia oraz zdefiniuj monitorowanie, przywracanie i przegląd przed rozszerzeniem zakresu. Rejestruj wersje i założenia, aby inny zespół mógł odtworzyć wynik i zrozumieć, co się zmieniło.
Przed uruchomieniem przeprowadź udokumentowaną ocenę gotowości z osobami, które budują, obsługują, zabezpieczają i są dotknięte systemem. Testuj przypadki normalne, warunki brzegowe, awarie zależności i niewłaściwe użycie; zachowaj dowody i nierozwiązane ryzyka. Określ, kto może zatwierdzić wydanie, zmienić próg, nadpisać wynik lub zatrzymać działanie. Ponownie rozważ decyzję po pojawieniu się danych z rzeczywistości, ponieważ technicznie udany pilotaż nie gwarantuje niezawodnej wydajności w szerszej skali.
- MODEL: wyuczone parametry i reprezentacje.
- KONTEKST: podpowiedź, wyszukiwanie i narzędzia.
- SYSTEM: ocena, kontrola, monitorowanie i ludzie.
Najczęściej zadawane pytania
Dlaczego LLM‑y nazywane są dużymi?
Nie ma uniwersalnego progu liczby parametrów. „Duży” odnosi się do skali w porównaniu do wcześniejszych modeli językowych, obejmując liczbę parametrów, dane treningowe, moc obliczeniową i zakres zastosowań.
Czy LLM‑y rozumieją język?
Tworzą przydatne wewnętrzne reprezentacje i wykazują złożone zachowanie, ale słowo „rozumieć” ma kilka znaczeń. Wydajność powinna być wykazywana zadanie po zadaniu, a nie wyciągana z płynności.
Podstawowe źródła