
Podstawy AI
Czym jest uczenie ze wzmocnieniem z ludzką informacją zwrotną (RLHF)?

 Dodaj Unite.AI do preferowanych źródeł w Google
Uczenie ze wzmocnieniem z ludzką informacją zwrotną (RLHF) to rodzina metod, które wykorzystują oceny ludzi, aby pomóc w optymalizacji modelu, gdy pożądane zachowanie trudno określić prostą automatyczną nagrodą. W przypadku modeli językowych ludzie często porównują proponowane odpowiedzi, a wyuczony model preferencji przekształca te porównania w sygnał treningowy.
RLHF może sprawić, że wstępnie wytrenowany model będzie bardziej pomocny lub lepiej dopasowany do określonej polityki, ale nie gwarantuje prawdziwości ani zgodności z każdym użytkownikiem. Wynik zależy od tego, kto dostarcza informacje zwrotne, w jaki sposób pobierane są zapytania, co model nagrody jest w stanie odzwierciedlić oraz jak ograniczona jest optymalizacja.
Kluczowe wnioski
- RLHF zazwyczaj następuje po wstępnym treningu i nadzorowanym dostrajaniu instrukcji.
- Preferencje parami uczą model nagrody lub preferencji; optymalizacja polityki następnie faworyzuje wyniki o wyższych ocenach.
- Manipulacja nagrodą, niezgodność anotatorów, przesunięcie rozkładu oraz nadmierna optymalizacja pozostają istotnymi ryzykami.
- Należy ocenić końcową politykę bezpośrednio pod kątem jakości zadania, bezpieczeństwa, kalibracji oraz efektów w podgrupach.
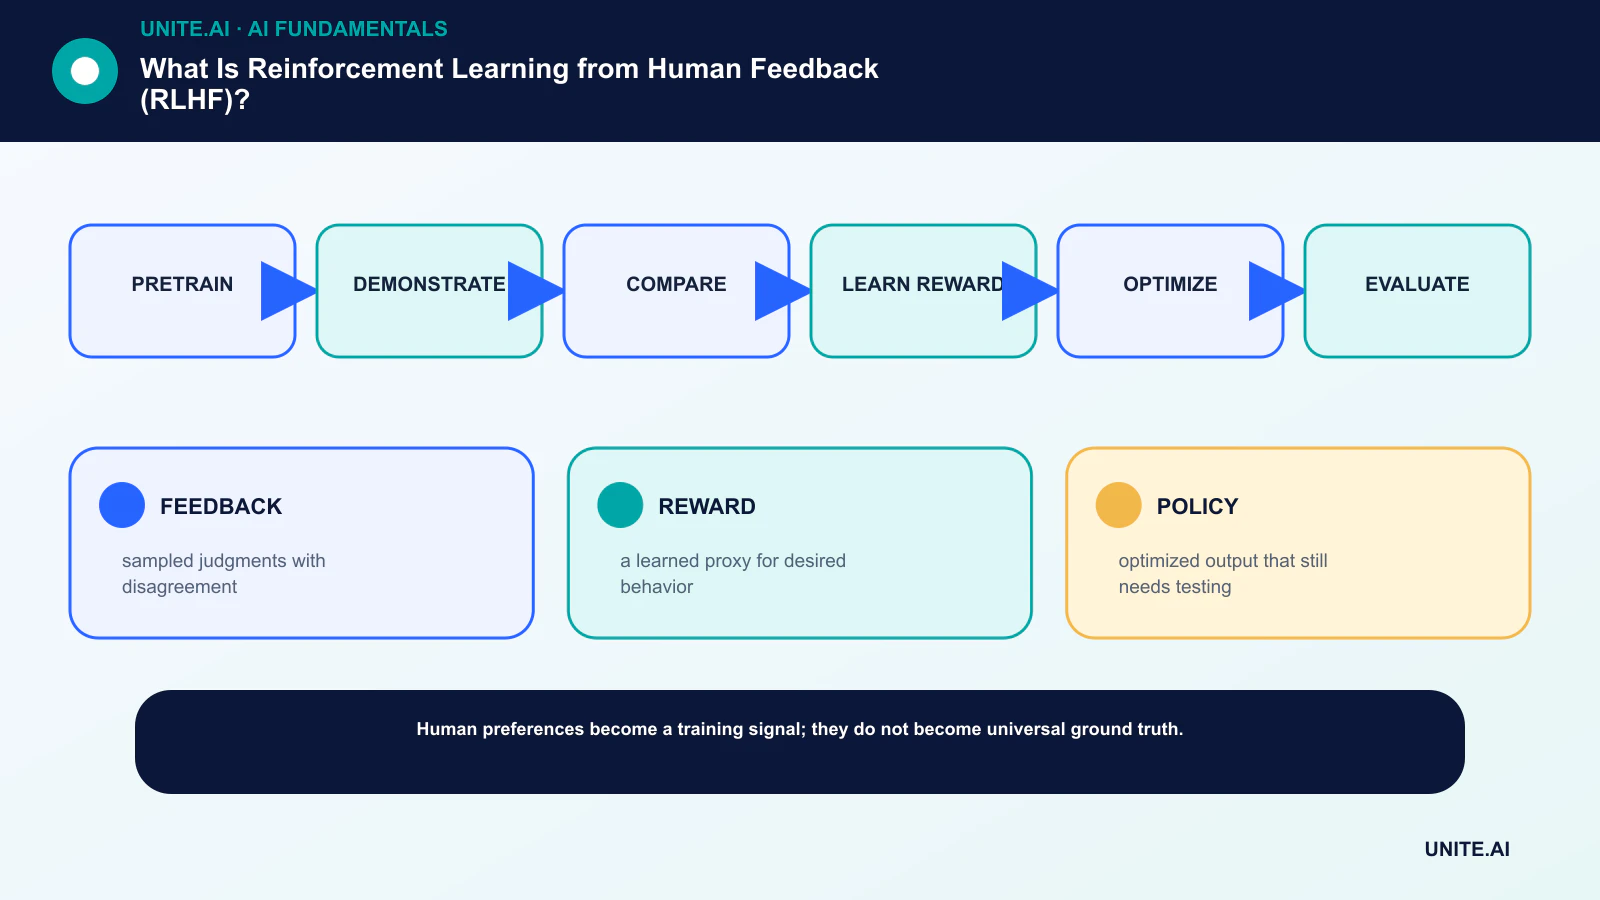
Typowy pipeline RLHF
Model językowy najpierw uczy się szerokiej struktury statystycznej poprzez wstępny trening. Następnie nadzorowane dostrajanie wykorzystuje demonstracje pożądanych odpowiedzi. W celu zbierania preferencji anotatorzy oceniają lub wybierają spośród wyników dla tego samego zapytania.
Model nagrody uczy się przewidywać te porównania. Algorytm uczenia ze wzmocnieniem, taki jak PPO, może optymalizować model językowy względem wyuczonej nagrody, podczas gdy kara zniechęca go do zbytniego odchodzenia od polityki odniesienia.
Informacja zwrotna to pomiar, nie prawda podstawowa
Anotatorzy mogą się nie zgadzać, ponieważ instrukcje są niejednoznaczne, różni się ich wiedza lub wartości rzeczywiście kolidują. Pozycja, rozwlekłość, pewność i styl mogą wpływać na preferencje. Program wysokiej jakości szkoli oceniających, mierzy zgodność, audytuje przykłady i zachowuje niepewność.
Dobór próbek także ma znaczenie. Jeśli zestaw preferencji pomija trudne języki, dziedziny lub szkodliwe treści, model nagrody nie może ich wiarygodnie nadzorować. Dyscyplina data-science jest tak samo ważna jak optymalizator.
Tryby awaryjne
Polityka może wykorzystywać słabości wyuczonej nagrody, generując wyniki, które uzyskują wysokie oceny, nie spełniając jednak zamierzonego celu. Nadmierna optymalizacja może zmniejszyć różnorodność, wzmocnić preferowany styl lub sprawić, że model będzie pewny siebie i ugodowy.
Sam model nagrody może zawieść poza zakresem swojego treningu. Zespoły powinny testować przeciwstawne zapytania, zadania faktograficzne, granice odmowy, kalibrację oraz zachowanie przy różnych poziomach optymalizacji, zamiast polegać jedynie na jednorazowej skumulowanej stopie zwycięstw preferencji.
Alternatywy i uzupełnienia
Direct Preference Optimization uczy się na parach preferencji bez dopasowywania odrębnej polityki poprzez pętlę uczenia ze wzmocnieniem online. Metody takie jak odrzucające próbkowanie, nadzorowane dostrajanie preferencji, informacja zwrotna oparta na regułach oraz nadzór procesu oferują inne kompromisy.
Żadna metoda nie eliminuje potrzeby kontroli na poziomie zapytań, wyszukiwania, narzędzi i aplikacji. Działania po treningu kształtują zachowanie; wdrożone systemy nadal wymagają uzasadnionych dowodów, uprawnień, monitoringu i eskalacji ludzkiej.
Jak trenowane są modele preferencji
Dla zapytania x i dwóch odpowiedzi y₁ oraz y₂ model preferencji przydziela wartości skalarne i jest trenowany tak, aby preferowana odpowiedź otrzymała wyższą ocenę. Powszechną funkcją straty jest prawdopodobieństwo, że jedna ocena przewyższa drugą. Dzięki temu wiele ocen parami przekształca się w funkcję, która może oceniać nowo wygenerowane wyniki.
Model uczy się wszystkiego, co przewiduje zebrane wybory. Jeśli oceniający preferują pewną prozę, dłuższe odpowiedzi, określone normy kulturowe lub znane perspektywy, te korelacje mogą stać się cechami nagrody. Zrównoważone instrukcje, kontrprzykłady, recenzje ekspertów oraz audyty pod kątem powierzchownych preferencji zmniejszają, ale nie eliminują problemu.
Dane preferencyjne mogą zawierać remisy, rankingi, krytyki, etykiety skalarne lub demonstracje. Wybór par ma znaczenie: porównania oczywiście odmiennych odpowiedzi uczą mniej o subtelnych granicach jakości, podczas gdy jedynie trudne pary mogą powodować niestabilność treningu. Aktywne pobieranie próbek może celować w informacyjne niezgodności, ale może zmienić rozkład danych.
Optymalizacja polityki i regularizacja
RLHF oparte na PPO pobiera odpowiedzi z bieżącej polityki, ocenia je za pomocą modelu nagrody i aktualizuje politykę, aby zwiększyć oczekiwaną nagrodę. Kara Kullbacka–Leiblera lub pokrewne ograniczenie utrzymuje politykę blisko nadzorowanej referencji, ograniczając destrukcyjny dryf i zniechęcając do wykorzystywania wąskich słabości modelu nagrody.
Siła optymalizacji jest decyzją produktową. Zbyt mała nie zmienia pożądanego zachowania; zbyt duża może prowadzić do manipulacji nagrodą, powtarzalnych sformułowań, pochlebstwa lub zmniejszonej różnorodności. Należy wykreślić jakość i wskaźniki bezpieczeństwa względem nagrody i dywergencji w trakcie treningu, zamiast wybierać punkt kontrolny wyłącznie na podstawie nagrody.
Metody bezpośrednich preferencji wyprowadzają cel z par preferencyjnych i modelu odniesienia bez wyraźnej pętli RL online. Mogą uprościć trening, ale nadal dziedziczą jakość preferencji, ich pokrycie oraz założenia dotyczące polityki odniesienia. Konstytucyjna lub generowana przez SI informacja zwrotna zmienia podmiot dostarczający etykiety; nie eliminuje to potrzeby weryfikacji wartości i błędów przy udziale ludzi.
Ewaluacja i zarządzanie danymi
Stosuj porównania ślepe, testy specyficzne dla zadań, przeciwstawne zapytania, weryfikacje faktualności, precyzję i czułość odmowy oraz przegląd podgrup. W miarę możliwości oddziel oceniających od danych treningowych. Stopa zwycięstw w porównaniu ze starszym modelem może ukrywać absolutne niepowodzenia, gdy oba kandydaci są słabi.
Dokumentuj rekrutację anotatorów, wynagrodzenie, kompetencje, położenie geograficzne, język, instrukcje, narażenie na szkodliwe treści, niezgodności, rozstrzyganie oraz kontrole jakości. Praca z informacją zwrotną może wiązać się z ryzykiem psychologicznym, a odpowiedzialne operacje na danych obejmują wsparcie pracowników i prawo do odmowy niepokojących zadań.
Po wdrożeniu monitoruj dryf preferencji i nadmierną generalizację. Polityka dostosowana do swobodnej pomocy może zachowywać się nieodpowiednio w kontekstach medycznych lub prawnych. Utrzymuj granice domen, wyszukiwanie, uprawnienia i eskalację poza założeniami RLHF oraz przeprowadzaj ponowny trening tylko wtedy, gdy nowe dowody uzasadniają zmianę.
Konkretny pipeline treningu i ewaluacji RLHF
Typowy projekt rozpoczyna się od wstępnie wytrenowanego modelu językowego i zestawu danych instrukcji używanego do nadzorowanego dostrajania. Następnie anotatorzy porównują proponowane odpowiedzi według pisemnej rubryki obejmującej poprawność, trafność, styl, bezpieczeństwo i niepewność. Preferencje parami uczą model nagrody lub bezpośrednio optymalizują politykę. Pobieranie próbek musi obejmować zwykłe zadania, trudne przypadki brzegowe, przeciwstawne zapytania, wiele języków oraz obszary, w których anotatorzy uzasadnione się nie zgadzają.
Dokładność modelu nagrody na odłożonych porównaniach jest konieczna, ale niewystarczająca. Optymalizowana polityka może wykorzystywać błędy w wyuczonej nagrodzie, stać się nadmiernie rozwlekła, odmawiać nieszkodliwych żądań lub tracić możliwości. Śledź benchmarki zadań, ludzkie preferencje, kalibrację, bezpieczeństwo, różnorodność oraz odchylenie od modelu odniesienia w trakcie treningu. Okresowo zbieraj nowe porównania od zmieniającej się polityki, aby dane preferencyjne obejmowały rzeczywiste wyniki generowane przez model.
Dokumentuj, kto dostarczył preferencje, ich instrukcje, wynagrodzenie, niezgodności, kontrole jakości oraz ograniczenia kulturowe lub domenowe. Korzystaj z recenzentów‑ekspertów tam, gdzie błędy niosą specjalistyczne szkody. Przeprowadzaj red‑team zarówno modelu nagrody, jak i końcowej polityki, utrzymuj testy regresji zachowań i etapowe wdrożenie. RLHF kształtuje zachowanie zgodnie z mierzonymi preferencjami; nie dowodzi prawdziwości, nie eliminuje uprzedzeń ani nie rozwiązuje szerszego problemu określenia, co model powinien robić w każdym kontekście.
Lista kontrolna praktycznej implementacji
Przekształć koncepcję w ograniczony, testowalny przepływ pracy: pretraining → demonstracja → porównanie → nauka nagrody → optymalizacja → ewaluacja. Wyznacz odpowiedzialnego właściciela, udokumentuj dane i zależności, ustal prostą bazę odniesienia, określ kryteria akceptacji i zakończenia, przetestuj reprezentatywne niepowodzenia oraz zdefiniuj monitorowanie, wycofanie i przegląd przed rozszerzeniem zakresu. Rejestruj wersje i założenia, aby inny zespół mógł odtworzyć wynik i zrozumieć, co się zmieniło.
Przed uruchomieniem przeprowadź udokumentowaną ocenę gotowości z osobami, które budują, obsługują, zabezpieczają i są dotknięte systemem. Testuj przypadki normalne, warunki brzegowe, awarie zależności i niewłaściwe użycie; zachowaj dowody i nierozwiązane ryzyka. Określ, kto może zatwierdzić wydanie, zmienić próg, nadpisać wynik lub zatrzymać działanie. Ponownie rozważ decyzję po pojawieniu się danych z rzeczywistości, ponieważ technicznie udany pilotaż nie gwarantuje niezawodnej wydajności na szerszą skalę.
- FEEDBACK: próbki ocen z niezgodnościami.
- REWARD: wyuczony zamiennik pożądanego zachowania.
- POLICY: zoptymalizowany wynik, który nadal wymaga testów.
Najczęściej zadawane pytania
Czy RLHF jest tym samym co dostrajanie (fine‑tuning)?
RLHF jest formą po‑treningu, która wykorzystuje nagrody pochodzące z preferencji. Nadzorowane dostrajanie trenuje bezpośrednio na docelowych wynikach; wiele pipeline’ów wykorzystuje oba podejścia.
Czy RLHF sprawia, że model jest prawdziwy?
Może poprawić zachowanie mierzone procesem informacji zwrotnej, ale model nadal może być błędny, perswazyjny lub strategicznie wykorzystywać nagrodę. Prawdziwość wymaga bezpośredniej oceny i uzasadnienia.
Podstawowe odniesienia












