
Podstawy AI
Czym jest głębokie uczenie ze wzmocnieniem?

 Dodaj Unite.AI do preferowanych źródeł w Google
Głębokie uczenie ze wzmocnieniem (deep RL) łączy uczenie ze wzmocnieniem z głębokimi sieciami neuronowymi. Agent obserwuje stan, wybiera akcję, otrzymuje nagrodę oraz nową obserwację, a następnie dostosowuje politykę lub funkcję wartości, aby poprawić przyszłe decyzje.
Głęboka sieć nie eliminuje trudnych elementów uczenia ze wzmocnieniem. Zapewnia elastyczny sposób reprezentacji obrazów, strumieni sensorów, dużych przestrzeni akcji lub złożonych funkcji wartości. Eksploracja, opóźnione przypisywanie nagrody, niestabilne uczenie oraz bezpieczna ocena w rzeczywistym świecie pozostają kluczowymi problemami inżynieryjnymi.
Kluczowe wnioski
- Głębokie uczenie ze wzmocnieniem uczy się sekwencyjnych decyzji na podstawie interakcji, a nie z ustalonej tabeli oznakowanych przykładów.
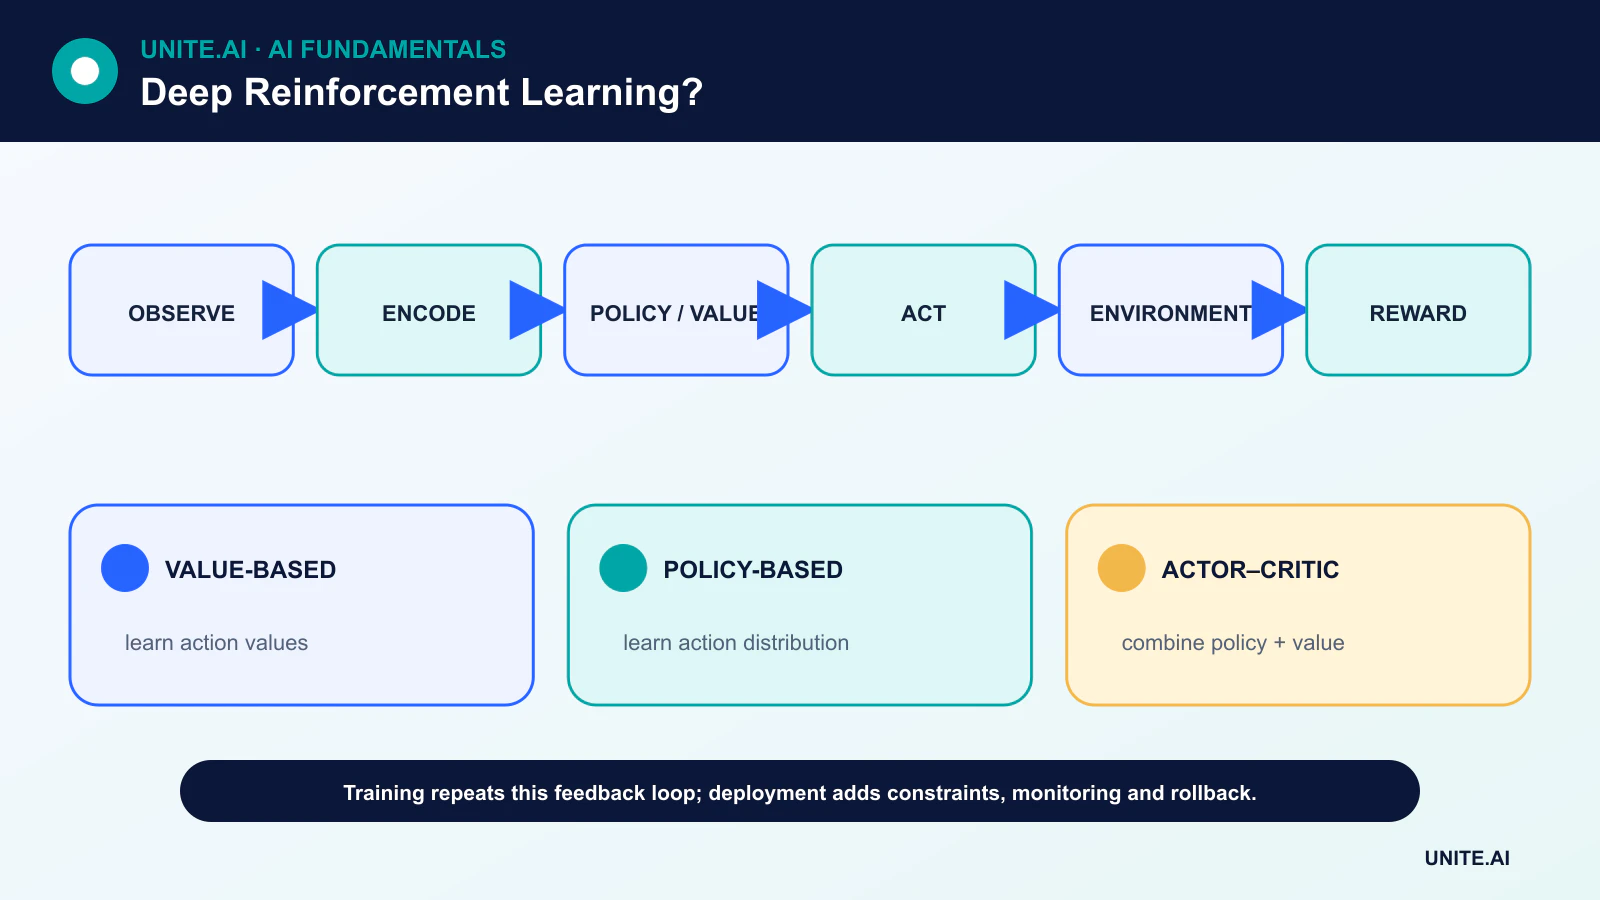
- Metody oparte na wartościach szacują, jak dobre są akcje; metody polityki uczą się bezpośrednio rozkładu akcji; metody aktor‑krytyk łączą oba podejścia.
- Bufory powtórzeń, sieci docelowe i staranne projektowanie nagród mogą poprawić proces uczenia, ale żadne z nich nie gwarantuje niezawodnego zachowania.
- Wysoki wynik w symulatorze nie jest dowodem na odporność, bezpieczeństwo ani udane przeniesienie do rzeczywistego świata.
Problem decyzyjny: stany, akcje i nagrody
Wiele zadań w głębokim uczeniu ze wzmocnieniem modeluje się jako proces decyzyjny Markowa. W czasie t agent otrzymuje stan lub obserwację st, wybiera akcję at, po czym otrzymuje nagrodę rt+1 oraz kolejny stan. Celem jest oczekiwany zdyskontowany zwrot, a nie jedynie natychmiastowa nagroda.
Współczynnik dyskontowy określa, jak silnie liczą się odległe nagrody. Funkcja nagrody definiuje, co będzie optymalizowane, więc niekompletny przybliżony wskaźnik może prowadzić do zachowań technicznie udanych, ale operacyjnie niepożądanych. To jeden z powodów, dla których projektowanie nagród i testowanie ograniczeń powinny otrzymać taką samą uwagę jak architektura modelu.
Metody oparte na wartościach, polityce i aktor‑krytyk
Algorytm oparty na wartościach szacuje wartość stanu lub wartość akcji. Deep Q‑networks wykorzystują sieć neuronową do przybliżania wartości Q i zazwyczaj wybierają akcję o najwyższej prognozie, zachowując jednocześnie pewną eksplorację. Algorytm gradientu polityki natomiast optymalizuje parametryzowaną politykę, która generuje rozkład akcji.
Systemy aktor‑krytyk utrzymują zarówno aktora, który proponuje akcje, jak i krytyka, który ocenia ich wartość. Taka konstrukcja wspiera sterowanie ciągłe, ale wprowadza wzajemnie oddziałujące źródła błędów szacowania. Dlatego głębokie uczenie ze wzmocnieniem opiera się na tych samych podstawach, co głębokie uczenie, spadek gradientowy i wsteczna propagacja.
Dlaczego bufory powtórzeń i sieci docelowe pomagają
Kolejne próbki doświadczeń są ze sobą skorelowane, a aktualizacja sieci zmienia cele wykorzystywane w późniejszych aktualizacjach. Powtórzenia doświadczeń (experience replay) przełamują część tej korelacji czasowej, losując starsze przejścia. Sieć docelowa zmienia się wolniej niż sieć online, co sprawia, że cele bootstrapowe są mniej zmienne.
Mechanizmy te zwiększają stabilność uczenia, ale strojenie wciąż ma znaczenie. Współczynnik uczenia, harmonogram eksploracji, skala nagród, skład replayu i pojemność sieci mogą wpływać na rezultat. Należy podawać wyniki dla wielu losowych ziaren, ponieważ pojedynczy przebieg może wprowadzać w błąd.
Offline RL, RL oparte na modelu i symulacja‑do‑rzeczywistości
Offline RL uczy się na podstawie stałego, zarejestrowanego zestawu danych, nie zbierając nowych interakcji. Może być przydatne, gdy eksploracja jest kosztowna lub niebezpieczna, ale polityka musi unikać akcji słabo reprezentowanych w logu. RL oparte na modelu uczy się lub wykorzystuje model przejść do planowania, wymieniając dodatkowe założenia na większą efektywność próbkowania.
Robotyka często trenuje w symulacji, losując parametry fizyczne, a następnie dopasowuje lub weryfikuje na rzeczywistym sprzęcie. Luka między symulacją a rzeczywistością może ujawnić błędy w percepcji, synchronizacji, dynamice kontaktu oraz nieujęte przypadki brzegowe. System uczenia ze wzmocnieniem powinien być oceniany pod kątem perturbacji, zmiany rozkładu i wyraźnych ograniczeń bezpieczeństwa.
Ewaluacja i wdrożenie
Użyteczna ewaluacja oddziela środowiska treningowe od testowych, raportuje rozkłady zwrotu zamiast jedynie najlepszego wyniku oraz sprawdza naruszenia ograniczeń, częstotliwość interwencji i zachowanie w najgorszym przypadku. W przypadku rzeczywistych systemów zespoły potrzebują także monitoringu, procedur przywracania, ograniczonych przestrzeni akcji oraz możliwości ręcznej interwencji.
Głębokie uczenie ze wzmocnieniem jest najbardziej atrakcyjne, gdy decyzje są sekwencyjne, dostępna jest informacja zwrotna, a ręcznie napisane reguły sterowania są niewystarczające. Jest słabym wyborem, gdy dostępne są liczne etykiety nadzorowane, tradycyjny optymalizator rozwiązuje problem lub eksploracja narażałaby ludzi lub zasoby na ryzyko.
Architektury Deep RL i sygnały treningowe
Głębokie uczenie ze wzmocnieniem wykorzystuje sieci neuronowe do reprezentacji funkcji wartości, polityki, modelu środowiska lub ich kombinacji. Deep Q‑network przewiduje wartości akcji i uczy się na podstawie celów różnicy czasowej; powtórzenia doświadczeń zmniejszają korelację między aktualizacjami, a sieć docelowa stabilizuje zmieniający się cel. Metody gradientu polityki optymalizują oczekiwany zwrot bezpośrednio, a metody aktor‑krytyk używają wyuczonego krytyka do redukcji wariancji gradientu. Ciągłe akcje często wymagają deterministycznych lub stochastycznych wariantów aktor‑krytyk, podczas gdy dyskretne akcje wysokowymiarowe wymagają starannej eksploracji i projektowania wyjścia.
Trening jest niestacjonarny, ponieważ polityka zmienia zbierane dane. Dane z replayu stają się off‑policy, cele bootstrapowe zależą od bieżących szacunków, a aproksymacja funkcji może nasilać błędy — kombinacja ta jest czasem określana jako śmiertelna triada. Podwójne estymatory redukują przeszacowanie wartości; funkcje przewagi poprawiają przypisywanie kredytu; bonusy entropii zachęcają do eksploracji; ograniczone cele (clipped objectives) zapobiegają destrukcyjnym aktualizacjom polityki. Normalizuj obserwacje i nagrody jedynie w stanie wolnym od wycieków oraz rejestruj środowisko, wrapper, powtórzenia akcji, zakończenie i przetwarzanie nagród, ponieważ każdy z tych elementów zmienia problem.
Ewaluacja, symulatory i bezpieczeństwo wdrożenia
Raportuj rozkłady zwrotu w różnych niezależnych ziarnach i instancjach środowiska, a nie jedynie najlepszy przebieg. Oceń efektywność próbkowania, naruszenia ograniczeń, katastrofalne wyniki, wrażliwość na skalę nagrody oraz odporność na szum obserwacji, opóźnienia, błędy siłowników i zmienioną dynamikę. Porównaj z kontrolą skryptową, klasyczną kontrolą, nadzorowaną imitacją oraz prostszymi metodami RL. Zostaw odrębne warianty środowiska i testuj metryki wyników niezależne od nagrody, ponieważ agent może wykorzystywać zaprogramowaną nagrodę, nie spełniając zamierzonego zadania. Analiza wideo i trajektorii często ujawnia zachowania ukryte w zbiorczym zwrocie.
Symulacja umożliwia eksplorację, ale wprowadza lukę rzeczywistości. Losuj istotną fizykę i percepcję, skalibruj względem rzeczywistych pomiarów i stosuj konserwatywny transfer. Dane z logów lub offline RL unikają eksploracji online, ale nie mogą wiarygodnie ocenić akcji nieobsługiwanych przez politykę zachowania. Systemy produkcyjne powinny ograniczać zestaw akcji, ich częstotliwość, zasoby i zakres operacyjny; wymagać zatwierdzenia dla działań o wysokim wpływie oraz zawierać zweryfikowany bezpieczny kontroler lub mechanizm zatrzymania. Monitoruj wejścia polityki, rozkład akcji, nagrody, rzeczywiste wyniki i interwencje, z możliwością przywrócenia do przetestowanej wersji polityki.
Przykład konkretnego sterowania
W przypadku routingu robotów w magazynie definiujemy stan na podstawie lokalizacji, ładunku, poziomu baterii, pobliskiego ruchu i kolejki zadań; akcje pochodzą z dozwolonych ruchów i decyzji o ładowaniu; a nagroda wynika z ukończonej pracy, zużycia energii, zatłoczenia oraz ograniczeń bezpieczeństwa. Najpierw trenujemy w skalibrowanym symulatorze z losowymi popytami i usterek sensorów, a następnie obserwujemy rzeczywiste decyzje. Nigdy nie pozwól, aby wyuczona polityka omijała unikanie kolizji. Oceń przepustowość wraz z bliskimi wypadkami, zakleszczeniami, awariami baterii i najgorszym opóźnieniem. Projekt odniesie sukces tylko wtedy, gdy warstwowy system poprawi operacje, nie przenosząc nieakceptowalnego ryzyka eksploracji na ludzi lub sprzęt.
Przykład praktyczny: DRL dla chłodzenia centrów danych
Centrum danych ogranicza agenta RL do zatwierdzonych punktów nastaw chłodzenia i trenuje go w symulatorze skalibrowanym na podstawie historycznych danych o pogodzie, obciążeniu, temperaturach i reakcjach sprzętu. Nagroda obejmuje zużycie energii, ale twarde ograniczenia oddzielnie chronią temperaturę, wilgotność i cyklowanie sprzętu. Kontrola predykcyjna modelu oraz istniejące reguły służą jako punkty odniesienia. Ewaluacja obejmuje różne sezony, szum sensorów, opóźnienia siłowników, awarie sprzętu, nietypowe obciążenia oraz wiele ziaren, raportując zużycie energii, naruszenia, wariancję i odzyskiwanie.
Wyuczona polityka działa w trybie cieniowym przed próbą w ograniczonej strefie. Zewnętrzny kontroler bezpieczeństwa przycina akcje, a operatorzy mogą interweniować. Monitoruje się częstotliwość akcji, pokrycie stanów, niepewność modelu oraz rzeczywiste wyniki w obiekcie; niezgodność symulatora lub powtarzające się interwencje wywołują przywrócenie. Zaktualizowany sprzęt lub logika sterowania tworzy nową wersję środowiska i walidację. Oszczędności energii akceptowane są tylko wtedy, gdy niezawodność, margines termiczny, konserwacja i reakcja na usterki pozostają co najmniej tak silne jak w bazie.
Dowody wdrożeniowe i gotowość operacyjna
Decyzja produkcyjna wymaga więcej niż udanej demonstracji. Zdefiniuj docelowych użytkowników, środowisko operacyjne, wejścia, wyjścia, zależności, właściciela oraz konsekwencje każdego istotnego błędu. Ustal odtwarzalną bazę i wersjonowany zestaw ewaluacyjny przed strojeniem. Testuj typowe przypadki, warunki brzegowe, nieprawidłowe lub brakujące dane wejściowe, zmianę rozkładu, awarie zależności, niewłaściwe użycie oraz grupy lub środowiska najprawdopodobniej niedostatecznie obsłużone. Mierz jakość zadania wraz z kalibracją lub niepewnością, opóźnieniem, przepustowością, kosztami zasobów, dostępnością, prywatnością i bezpieczeństwem. Zapisz każdą transformację i próg, aby niezależny recenzent mógł odtworzyć wynik i odróżnić dowody od atrakcyjnego prototypu.
Przed uruchomieniem przydziel odpowiedzialność za wydanie, wyjątki, zmiany, przywrócenie i wycofanie. Stosuj etapowe wdrażanie, zachowaj bezpieczną alternatywę i weryfikuj monitoring przy celowo wprowadzonych awariach. Telemetria operacyjna powinna ujawniać jakość danych wejściowych, zachowanie wyjść, wersję modelu lub reguły, stan zależności, ręczne interwencje oraz potwierdzone wyniki, nie gromadząc niepotrzebnych wrażliwych danych. Określ progi alarmowe i osobę odpowiedzialną za reakcję, a następnie analizuj dowody z rzeczywistości po wdrożeniu, zamiast zakładać, że wydajność offline będzie trwała. Przeglądaj ponownie przy zmianie źródeł danych, użytkowników, modeli, dostawców, polityk, sprzętu lub celów. Utrzymany system wymaga także udokumentowanego odzyskiwania, nauki z incydentów, procedur usuwania i przechowywania oraz wyraźnego punktu, w którym powinien zostać wyłączony lub zastąpiony.
Najczęściej zadawane pytania
Czy głębokie uczenie ze wzmocnieniem jest tym samym co głębokie uczenie?
Nie. Głębokie uczenie dostarcza aproksymatory funkcji; uczenie ze wzmocnieniem dostarcza interakcję, nagrodę i cel sekwencyjnych decyzji.
Czy wysoka nagroda oznacza, że agent nauczył się zamierzonego zachowania?
Nie koniecznie. Oznacza to, że polityka znalazła zachowanie, które uzyskuje wysoką ocenę w ramach zaimplementowanej nagrody i środowiska. Wciąż wymagane są niezależne testy bezpieczeństwa i zgodności z celami.
Podstawowe źródła












