Podstawy AI
Czym jest spadek gradientowy?

 Dodaj Unite.AI do preferowanych źródeł w Google
Spadek gradientowy jest metodą optymalizacji, która dostosowuje parametry modelu w celu zmniejszenia funkcji celu. W treningu sieci neuronowych cel ten jest zazwyczaj stratą obliczaną na przykładach. Gradient wskazuje kierunek najszybszego lokalnego wzrostu, więc spadek gradientowy wykonuje krok w przeciwnym kierunku.
Gradient opisuje lokalną czułość; jego wielkość nie jest bezpośrednim pomiarem tempa „uczenia się” modelu. Rzeczywisty postęp zależy także od współczynnika uczenia, krzywizny, szumu, parametryzacji, stanu optymalizatora i danych.
Kluczowe wnioski
- Propagacja wsteczna oblicza gradienty, podczas gdy spadek gradientowy wykorzystuje je do aktualizacji parametrów.
- Optymalizacja w trybie mini‑batchów jest standardowym praktycznym podejściem w deep learning.
- Współczynnik uczenia kontroluje skalę aktualizacji i może podążać za harmonogramem, zamiast zmniejszać się po każdym kroku.
- Momentum, AdamW, przycinanie i normalizacja rozwiązują różne problemy optymalizacyjne.
Podstawowa reguła aktualizacji
Dla wektora parametrów θ, współczynnika uczenia η i funkcji straty L:
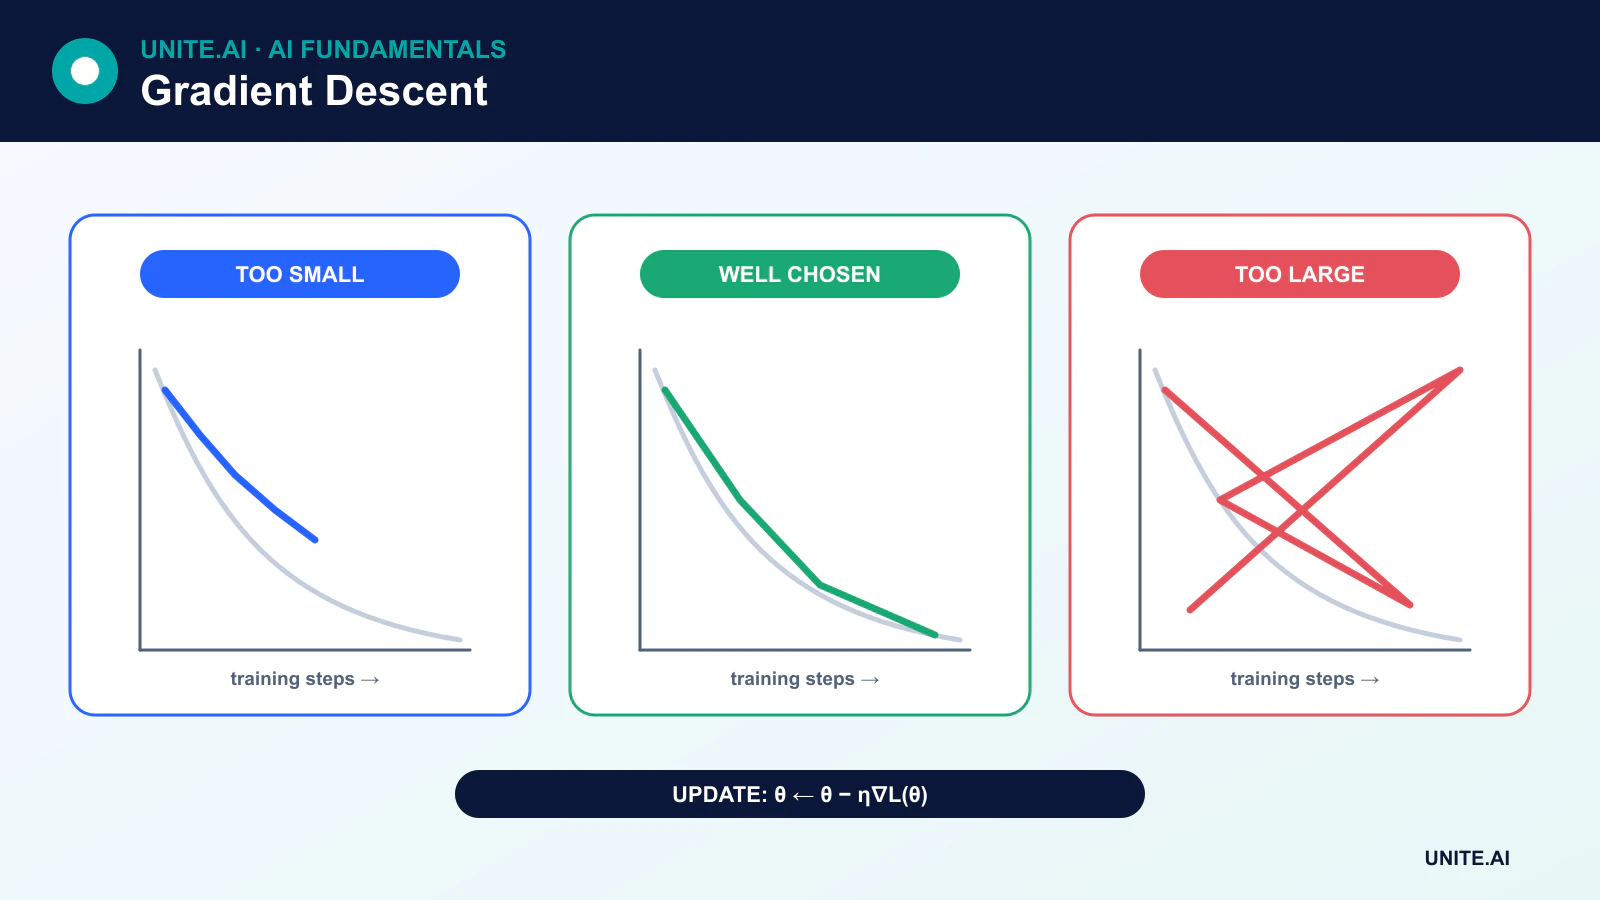
θ ← θ - η∇L(θ)
Gradient ∇L(θ) zawiera po jednej pochodnej cząstkowej dla każdego parametru. Odejmowanie go powoduje lokalny spadek. Punkt stacjonarny ma gradient równy zero, ale może być minimum, maksimum, punktem siodłowym lub płaskim obszarem. Powierzchnie strat w deep learningu są niekonweksyjne, więc trening nie gwarantuje znalezienia jedynego globalnego minimum ani zerowej straty.
Metody wsadowe, stochastyczne i mini‑batchowe
Spadek gradientowy wsadowy
Spadek gradientowy wsadowy oblicza gradient przy użyciu pełnego zestawu treningowego przy każdej aktualizacji. Szacunek jest stabilny, ale może być kosztowny pod względem czasu i pamięci, a jedna aktualizacja może nie w pełni wykorzystywać nowoczesne akceleratory.
Spadek gradientowy stochastyczny
Czysty spadek gradientowy stochastyczny używa jednego losowo wybranego przykładu przy każdej aktualizacji. Jego gradienty są szumne, co może wspomagać eksplorację powierzchni straty, ale operacje na pojedynczym przykładzie mogą być nieefektywne na sprzęcie równoległym.
Spadek gradientowy mini‑batchowy
Trening w trybie mini‑batchów szacuje gradient na podstawie podzbioru przykładów. Łączy szum statystyczny z efektywnymi operacjami macierzowymi i jest typowym podejściem w deep learning. Rozmiar batcha wpływa na pamięć, przepustowość, szum gradientu, normalizację i czasami na uogólnianie.
Wybór współczynnika uczenia
Zbyt duży współczynnik może przeskoczyć użyteczne obszary lub spowodować rozbieżność. Zbyt mały może sprawić, że trening będzie niepraktycznie wolny lub utknie w płaskich regionach. Optymalna skala zależy od optymalizatora, rozmiaru batcha, modelu, inicjalizacji i celu.
Harmonogramy mogą stopniowo rozgrzewać się, maleć w określonych punktach, podążać za krzywą cosinusową lub reagować na postęp walidacji. Współczynnik nie musi monotonicznie maleć po każdej aktualizacji. Ciepłe restarty i cykliczne harmonogramy celowo zwiększają go w niektórych fazach treningu.
Momentum
Momentum utrzymuje wykładniczą średnią ruchomą poprzednich gradientów. Może przyspieszyć postęp w spójnych kierunkach i zmniejszyć oscylacje wzdłuż stromych, wąskich kierunków. Momentum w stylu Nesterova ocenia lub przybliża gradient po spojrzeniu w przód wzdłuż kierunku momentum.
Adaptacyjne optymalizatory
RMSProp skaluje aktualizacje przy użyciu średniej ruchomej kwadratów gradientów. Adam łączy momenty pierwszego rzędu podobne do momentum z skalowaniem drugiego momentu. AdamW oddziela zanikanie wag od adaptacyjnej aktualizacji gradientu i jest szeroko stosowany w transformerach.
Adaptacyjne optymalizatory często ułatwiają wczesny trening, ale nie są automatycznie lepsze dla każdego modelu czy ostatecznego celu uogólnienia. Porównania optymalizatorów wymagają dopasowanych harmonogramów i starannego strojenia.
Przycinanie i akumulacja gradientów
Przycinanie gradientów ogranicza normę lub wartości gradientu, aby zmniejszyć wpływ wybuchających gradientów, szczególnie w treningu rekurencyjnym lub niestabilnym. Akumulacja gradientów sumuje gradienty z kilku mniejszych batchów przed aktualizacją, przybliżając większy efektywny batch, gdy pamięć jest ograniczona.
Monitorowanie optymalizacji
Śledź stratę treningową i walidacyjną, metryki zadania, współczynnik uczenia, normy gradientów, normy parametrów oraz błędy numeryczne. Spadek straty treningowej przy pogarszającej się wydajności walidacji wskazuje na przeuczenie, a nie na sukces optymalizacji, który powinien automatycznie trwać.
Optymalizacja minimalizuje podany cel. Niska strata nie dowodzi, że dane, metryka lub zachowanie w rzeczywistym świecie są odpowiednie. Wycieki, słabe etykiety i niezgodny cel mogą wygenerować dobrze zoptymalizowany, ale szkodliwy model.
Geometria optymalizacji i reguły aktualizacji
Spadek gradientowy aktualizuje parametry w przeciwnym kierunku do gradientu funkcji straty. Pełny batch używa każdego przykładu treningowego przy każdym kroku; spadek stochastyczny używa jednego; metody mini‑batchowe szacują gradient z podzbioru i dominują w deep learningu. Współczynnik uczenia określa skalę kroku. Zbyt mały marnuje obliczenia lub powoduje zatrzymanie; zbyt duży powoduje oscylacje lub rozbieżność. Momentum gromadzi ruch w danym kierunku, podczas gdy adaptacyjne metody, takie jak Adam, skalują współrzędne przy użyciu momentów gradientu. Ich różne ukryte uprzedzenia mogą prowadzić do modeli o podobnej stracie treningowej, ale różnym uogólnianiu.
Powierzchnie strat w sieciach neuronowych zawierają płaskie i ostre regiony, siodła, symetrie oraz słabo uwarunkowane kierunki. Skalowanie cech, normalizacja, inicjalizacja, połączenia resztkowe i preconditionowanie zmieniają geometrię widzianą przez optymalizator. Harmonogramy mogą rozgrzewać się, maleć, cyklicznie się powtarzać lub reagować na plateau. Zanikanie wag różni się od jedynie dodania kary L2 w niektórych adaptacyjnych optymalizatorach. Rozmiar batcha wpływa na szum, pamięć, równoległość i regime współczynnika uczenia, dlatego porównania optymalizatorów wymagają dopasowanych budżetów treningowych i starannego strojenia.
Diagnostyka, reprodukowalność i zatrzymywanie
Śledź stratę treningową i walidacyjną, metryki zadania, normy gradientów i parametrów, współczynnik uczenia, przepustowość oraz ostrzeżenia numeryczne. Rozbieżność może wynikać z uszkodzonych batchów, nieprawidłowych etykiet, niestabilnej mieszanej precyzji lub niepoprawnego redukowania straty. Plateau może wskazywać na niewystarczającą pojemność, nasycone aktywacje, słabe cechy, nadmierną regularizację lub problem z harmonogramem. Przeuczenie wymaga danych, augmentacji, regularizacji lub wczesnego zatrzymania — nie jest to stwierdzenie, że optymalizator zawiódł. Przeanalizuj reprezentatywne błędy i porównaj prostą bazę przed zwiększaniem złożoności treningu.
Reprodukowalność wymaga ustalonych seedów, kolejności danych, kodu, konfiguracji, wersji sprzętu i bibliotek, choć niektóre jądra akceleratorów pozostają niedeterministyczne. Zapisuj punkty kontrolne ze stanem optymalizatora i harmonogramu, aby trening mógł być kontynuowany spójnie. Wybierz punkt kontrolny na podstawie kryteriów walidacji ustalonych z góry i zachowaj niezmieniony zestaw testowy. W treningu rozproszonym potwierdź efektywny rozmiar batcha, uśrednianie gradientów i obsługę awarii pracowników. Optymalizacja minimalizuje wybrany cel na dostępnych danych; nie zapewnia skalibrowanych prawdopodobieństw, rozumowania przyczynowego, sprawiedliwości, bezpieczeństwa ani użyteczności w rzeczywistym świecie.
Przykład praktyczny: dostrajanie optymalizatora dla modelu językowego
Zespół ustala tokenizator, kolejność danych, model, efektywny batch oraz budżet tokenów treningowych, a następnie porównuje SGD z momentum i AdamW przy różnych uzasadnionych harmonogramach współczynnika uczenia. Rejestrowane są rozgrzewka, malejący współczynnik, weight decay, przycinanie i precyzja. Każdy kandydat jest uruchamiany na kilku seedach, a walidacja wykorzystuje odseparowany przedział czasowy oraz oceny zadania. Przepustowość i zużycie energii są podawane razem ze stratą, aby nie wybrać nieco lepszego optymalizatora kosztem nieproporcjonalnych kosztów.
Diagnostyka ujawnia, czy niestabilność pochodzi z jednego fragmentu danych, zbyt dużego kroku, podprzepływu lub architektury modelu. Punkty kontrolne zachowują stan optymalizatora i harmonogramu i są wznawiane w teście. Ostateczny wybór opiera się na jakości i odporności walidacji, a nie na najniższej stracie treningowej. Zestaw testowy zamknięty jest uruchamiany raz po wyborze. Inferencja w produkcji jest osobno kalibrowana i monitorowana, ponieważ sukces optymalizatora podczas wstępnego treningu nie gwarantuje bezpiecznego lub prawdziwego zachowania.
Dowody wdrożeniowe i gotowość operacyjna
Decyzja produkcyjna wymaga więcej niż udanej demonstracji. Zdefiniuj docelowych użytkowników, środowisko operacyjne, wejścia, wyjścia, zależności, właściciela oraz konsekwencje każdego istotnego błędu. Ustal powtarzalną bazę odniesienia i wersjonowany zestaw ewaluacyjny przed strojeniem. Testuj typowe przypadki, warunki brzegowe, niepoprawne lub brakujące dane wejściowe, przesunięcie rozkładu, awarie zależności, niewłaściwe użycie oraz grupy lub środowiska najczęściej niedostatecznie obsługiwane. Mierz jakość zadania wraz z kalibracją lub niepewnością, opóźnieniem, przepustowością, kosztami zasobów, dostępnością, prywatnością i bezpieczeństwem. Zapisuj każdą transformację i próg, aby niezależny recenzent mógł odtworzyć wynik i odróżnić dowody od atrakcyjnego prototypu.
Przed uruchomieniem przydziel odpowiedzialność za wydanie, wyjątki, zmiany, wycofanie i wycofanie. Użyj stopniowanego wdrożenia, zachowaj bezpieczną alternatywę i zweryfikuj monitorowanie poprzez celowo wprowadzane awarie. Telemetria operacyjna powinna ujawniać jakość danych wejściowych, zachowanie wyjść, wersję modelu lub reguły, stan zależności, interwencje ludzkie oraz potwierdzone wyniki, bez gromadzenia niepotrzebnych wrażliwych danych. Zdefiniuj progi alarmowe i osobę odpowiedzialną za reakcję, a następnie przeglądaj dowody z rzeczywistego świata po wdrożeniu, zamiast zakładać, że offline’owa wydajność utrzyma się. Przeprowadzaj ponowną ocenę, gdy zmieniają się źródła danych, użytkownicy, modele, dostawcy, polityki, sprzęt lub cele. Utrzymany system wymaga także udokumentowanego przywracania, nauki z incydentów, procedur usuwania i przechowywania oraz jasnego momentu, w którym powinien zostać wyłączony lub zastąpiony.
Najczęściej zadawane pytania
Czy spadek gradientowy zawsze osiąga globalne minimum?
Nie. Dla funkcji wypukłych odpowiednie warunki dają silne gwarancje. Cele sieci głębokich są niekonwekcyjne, a praktyczne optymalizatory zazwyczaj dążą do użytecznego rozwiązania, a nie do udowodnienia, że znalazły jedyne globalne minimum.
Dlaczego zerowy gradient może być mylący?
Zerowy lub bardzo mały gradient może wskazywać na minimum, maksimum, punkt siodłowy, nasycenie lub płaskie plateau. Diagnostyka treningu musi brać pod uwagę historię strat, krzywiznę, skalę parametrów oraz wydajność walidacji.
Podstawowe źródła