Podstawy AI
Czym są sieci neuronowe?

 Dodaj Unite.AI do preferowanych źródeł w Google
Sztuczna sieć neuronowa to parametryzowany model matematyczny złożony z warstw połączonych operacji. Podczas trenowania sieć dostosowuje swoje parametry tak, aby przekształcać dane wejściowe w użyteczne wyniki. Sieci neuronowe potrafią przybliżać złożone zależności nieliniowe i uczyć się reprezentacji bezpośrednio z tekstu, obrazów, dźwięku, szeregów czasowych oraz innych danych.
Nazwa została historycznie zainspirowana neuronami biologicznymi, lecz współczesne sieci są systemami inżynieryjnymi, a nie realistycznymi symulacjami mózgu. Określenia takie jak „neuron” i „uczenie się” są użytecznymi skrótami, ale nie należy traktować ich jako dowodu na poznanie podobne do ludzkiego.
Kluczowe wnioski
- Neuron oblicza sumę ważoną, dodaje uczone obciążenie i stosuje funkcję aktywacji.
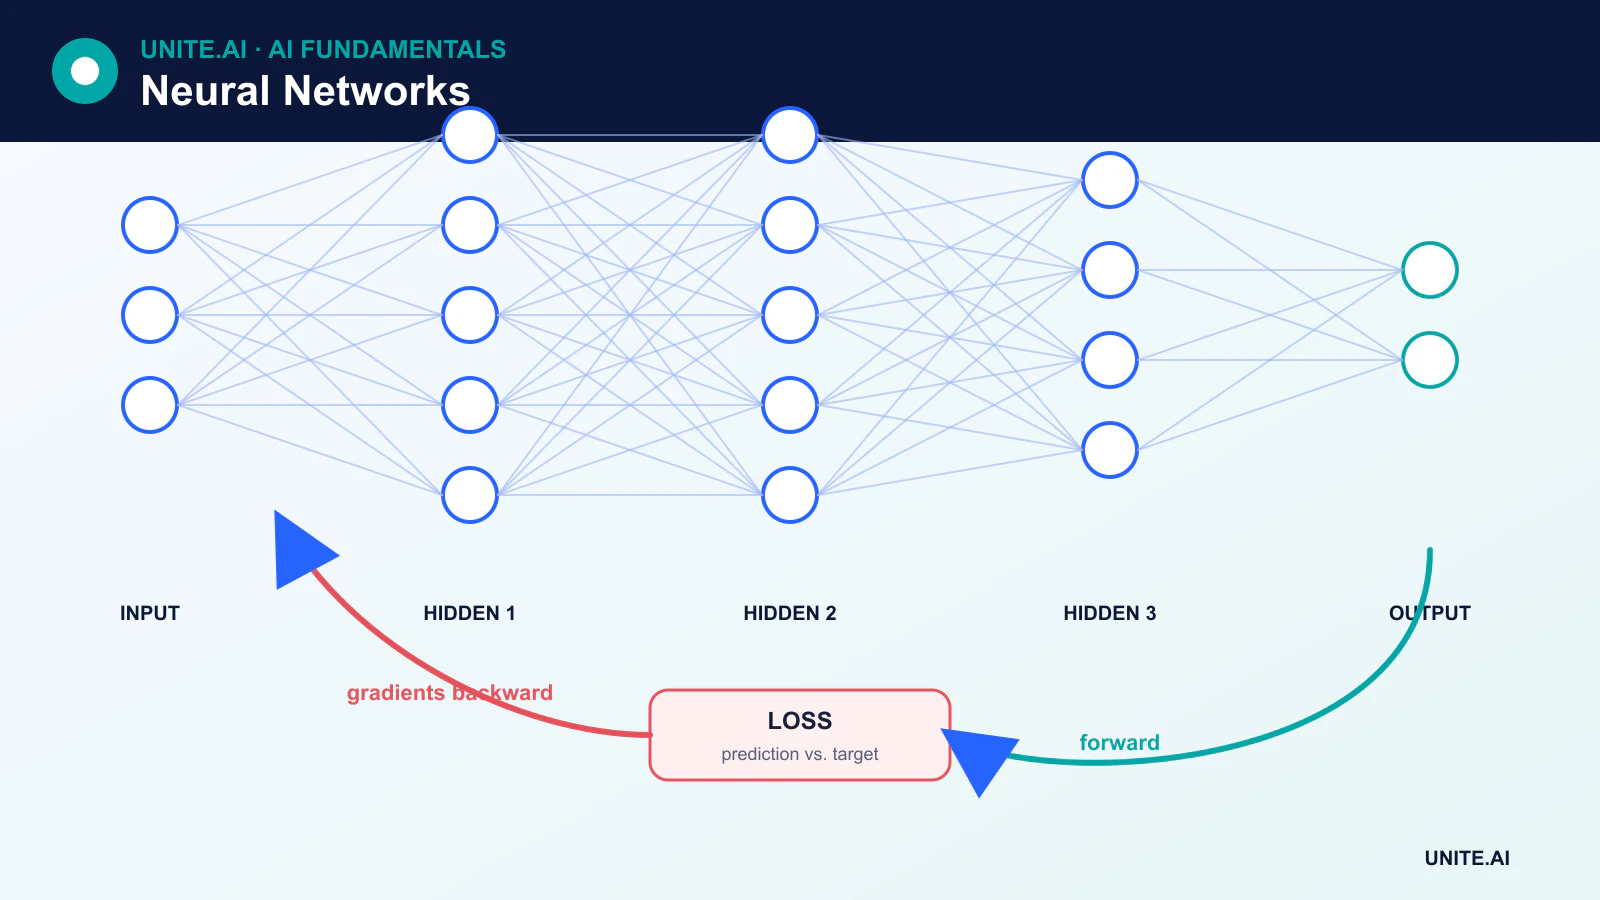
- Przejście w przód tworzy predykcje; funkcja straty mierzy błąd; propagacja wsteczna oblicza gradienty; optymalizator aktualizuje parametry.
- MLP, CNN, RNN i transformatory organizują połączenia na różne sposoby.
- Większa liczba warstw lub parametrów nie zapewnia automatycznie lepszego ani bardziej godnego zaufania modelu.
Od pojedynczego sztucznego neuronu do sieci
Dla wektora wejściowego x podstawowa jednostka oblicza:
z = Wx + bwyjście = aktywacja(z)
Macierz W zawiera uczone wagi, a b jest uczonym obciążeniem. Funkcja aktywacji wprowadza nieliniowość. Same wagi nie „przechodzą przez” aktywację; funkcję aktywacji stosuje się do sumy ważonej powiększonej o obciążenie.
Perceptron wielowarstwowy (MLP) składa się z kolejnych warstw gęstych. Warstwa wejściowa reprezentuje cechy, warstwy ukryte je przekształcają, a warstwa wyjściowa jest dostosowana do zadania — na przykład zwraca logity klas albo wartość regresji.
Jak uczą się sieci neuronowe
- Model inicjalizuje parametry podlegające uczeniu.
- Przejście w przód przetwarza partię danych i wytwarza predykcje.
- Funkcja straty porównuje predykcje z celem treningowym.
- Propagacja wsteczna wykorzystuje regułę łańcuchową do obliczania gradientów.
- Optymalizator, taki jak stochastyczny spadek gradientowy lub AdamW, aktualizuje wagi i obciążenia.
Propagacja wsteczna stała się podstawą trenowania sieci neuronowych dzięki pracom rozwijanym i popularyzowanym przez kilka dekad; nie powstała dopiero w niedawnej erze głębokiego uczenia. Współczesne frameworki implementują automatyczne różniczkowanie w trybie odwrotnym, dzięki czemu praktycy nie muszą ręcznie wyprowadzać każdego gradientu.
Dlaczego funkcje aktywacji mają znaczenie
Bez nieliniowych funkcji aktywacji wiele zwykłych warstw liniowych sprowadza się do jednego przekształcenia liniowego. ReLU jest szeroko stosowana ze względu na prostotę i wydajność. GELU i SiLU są częste we współczesnych architekturach. Sigmoid i softmax nadal sprawdzają się przy określonych interpretacjach wyjścia, lecz sigmoid może nasycać się w warstwach ukrytych i przyczyniać do zanikania gradientów.
Główne architektury sieci neuronowych
Splotowe sieci neuronowe
Sieci CNN stosują uczone filtry w lokalnych sąsiedztwach i współdzielą parametry pomiędzy pozycjami. Dzięki temu są wydajne dla obrazów i innych sygnałów o strukturze siatki.
Sieci rekurencyjne
Sieci RNN, LSTM i GRU aktualizują stan ukryty w kolejnych krokach sekwencji. Nadal są użyteczne w przetwarzaniu strumieniowym i szeregach czasowych, chociaż rekurencja ogranicza przetwarzanie równoległe i może utrudniać uczenie długich zależności.
Transformatory
Transformatory wykorzystują mechanizm uwagi do tworzenia reprezentacji zależnych od kontekstu. Połączenia rezydualne, normalizacja, informacja o pozycji i bloki feed-forward stanowią podstawowe elementy architektury. Transformatory są dziś fundamentem wielu dużych modeli językowych i multimodalnych.
Autoenkodery i sieci generatywne
Autoenkodery uczą się reprezentacji poprzez rekonstrukcję. Sieci GAN, modele dyfuzyjne i sieci autoregresyjne generują nowe próbki przy użyciu odmiennych celów i procedur treningowych.
Elementy umożliwiające trenowanie głębokich sieci
Współczesne systemy wykorzystują więcej niż warstwy i aktywacje. Połączenia rezydualne pozwalają informacjom i gradientom omijać bloki. Normalizacja stabilizuje aktywacje. Regularyzacja, augmentacja danych, dropout i zanik wag mogą ograniczać przeuczenie. Warstwy osadzające odwzorowują elementy dyskretne, takie jak tokeny, na wektory. Mechanizm uwagi sprawia, że reprezentacja może dynamicznie zależeć od innych elementów.
Mocne strony i ograniczenia
Sieci neuronowe mogą uczyć się cech z wielowymiarowych danych surowych i skalować wraz z ilością danych oraz mocą obliczeniową. Mogą jednak wymagać dużych zbiorów danych, specjalistycznego sprzętu i starannego strojenia. Ich predykcje bywają źle skalibrowane, kruche przy zmianie rozkładu, podatne na manipulacje adwersarialne lub trudne do wyjaśnienia.
Architektura powinna wynikać z zadania i ograniczeń wdrożeniowych. W wielu problemach tabelarycznych zespół drzew lub model liniowy może być szybszy i łatwiejszy do walidacji. W zastosowaniach wysokiego ryzyka skuteczność modelu trzeba oceniać według podgrup i trybów awarii, a nie wyłącznie za pomocą zagregowanego benchmarku.
Warstwy, aktywacje i przepływ informacji
Sieć neuronowa składa parametryzowane funkcje. Każda jednostka tworzy ważoną kombinację wejść, dodaje obciążenie i przekazuje wynik przez funkcję aktywacji, taką jak ReLU, sigmoid, tanh lub GELU. Układanie warstw umożliwia tworzenie hierarchicznych cech i nieliniowych granic decyzyjnych. Szerokość określa liczbę jednostek w warstwie, głębokość — kolejne przekształcenia, a sposób połączeń i współdzielenie wag kodują architekturę. Wynik sieci zależy łącznie od przetwarzania wstępnego, parametrów, normalizacji i trybu inferencji. Neuron jest operacją matematyczną, a nie dosłownym neuronem biologicznym ani samodzielnie znaczącym pojęciem.
Propagacja w przód oblicza predykcje; funkcja straty określa błąd; propagacja wsteczna stosuje regułę łańcuchową do gradientów; optymalizator aktualizuje parametry. Inicjalizacja, szybkość uczenia, statystyki partii, ścieżki rezydualne i normalizacja wpływają na to, czy gradienty zanikają, eksplodują czy pozostają użyteczne. Regularyzacja obejmuje zanik wag, dropout, augmentację, wczesne zatrzymanie i ograniczenia architektoniczne. Należy wykreślać przebieg treningu i walidacji, kontrolować statystyki gradientów i aktywacji oraz porównywać powtórzone uruchomienia. Duża sieć może zapamiętać dane treningowe, a mała może nie dopasować się do danych lub pominąć potrzebną strukturę.
Wybór architektury, ocena i wdrożenie
Perceptrony wielowarstwowe przetwarzają wektory o stałym rozmiarze; sieci splotowe wykorzystują strukturę lokalną; modele rekurencyjne i modele przestrzeni stanów przetwarzają sekwencje; transformatory używają uwagi; sieci grafowe wymieniają informacje wzdłuż krawędzi. Częste są architektury hybrydowe. Wybór powinien uwzględniać uprzedzenie indukcyjne, dane, rozmiar sekwencji lub obrazu, opóźnienie, pamięć, interpretowalność i dostępny sprzęt. Model należy porównać z liniowym lub drzewiastym punktem odniesienia i przeprowadzić ablacje, aby ustalić, która złożoność rzeczywiście pomaga. Sama liczba parametrów nie przewiduje jakości, kosztu inferencji ani zapotrzebowania na dane.
Obsługa w produkcji wymaga zamrożonego przetwarzania wstępnego, wyeksportowanego lub skompilowanego grafu, walidacji numerycznej i testów zasobów przy realistycznym obciążeniu. Kwantyzacja i przycinanie mogą zmniejszyć rozmiar, lecz mogą też zmienić zachowanie wobec rzadkich klas. Należy monitorować wejścia, wyjścia, kalibrację, opóźnienie i potwierdzone wyniki oraz testować dane adwersarialne i przesunięte. Modele, zależności i dane trzeba chronić za pomocą podpisanych artefaktów, kontroli dostępu i przeglądu łańcucha dostaw. Wyjaśnienia oparte na pojedynczych aktywacjach lub mapach istotności wymagają weryfikacji przyczynowej i behawioralnej. Sieci neuronowe są elastycznymi aproksymatorami funkcji, a nie gwarancją rozumienia, prawdy czy odporności.
Przykład praktyczny: neuronowy model prognozowania popytu
Detalista prognozuje tygodniowy popyt na produkty na podstawie sprzedaży, promocji, cen, świąt, dostępności i pogody. Sieć porównuje się z naiwną prognozą sezonową oraz modelami liniowymi i drzewiastymi przy użyciu kroczących podziałów czasowych. Przyszłe promocje uwzględnia się tylko wtedy, gdy są rzeczywiście znane w chwili prognozy, a braki magazynowe są modelowane, ponieważ obserwowana sprzedaż może zaniżać popyt. Ocena obejmuje ważony błąd bezwzględny, obciążenie systematyczne, pokrycie przedziałów oraz wyniki według rotacji produktu i sklepu.
Potok produkcyjny wersjonuje dostępność cech, model i horyzont, a także odmawia utworzenia prognozy, gdy wymagane dane wejściowe są nieaktualne. Planiści widzą przedziały i mogą nadpisać wynik z zapisaniem przyczyny. Monitoring wykrywa brakujące źródła, zmianę błędu, obciążenie i nietypowe prognozy; wyniki biznesowe oddziela się od trafności prognozy, ponieważ polityka zamawiania również wpływa na zapasy. Aktualizacja modelu działa równolegle w trybie cienia przez kilka cykli, a poprzedni prognozator pozostaje dostępny do wycofania zmian podczas zakłóceń sezonowych lub problemów z dostawcami.
Dowody wdrożenia i gotowość operacyjna
Decyzja o uruchomieniu produkcyjnym wymaga czegoś więcej niż udanej demonstracji. Należy określić docelowych użytkowników, środowisko pracy, wejścia, wyjścia, zależności, właściciela i konsekwencje każdej istotnej awarii. Przed strojeniem trzeba ustanowić odtwarzalny punkt odniesienia i wersjonowany zbiór ewaluacyjny. Testy powinny obejmować zwykłe przypadki, warunki brzegowe, nieprawidłowe lub brakujące wejścia, zmianę rozkładu, awarie zależności, niewłaściwe użycie oraz grupy lub środowiska najbardziej narażone na gorszą obsługę. Jakość zadania należy mierzyć łącznie z kalibracją lub niepewnością, opóźnieniem, przepustowością, kosztem zasobów, dostępnością, prywatnością i bezpieczeństwem. Każde przekształcenie i próg trzeba zapisać, aby niezależny recenzent mógł odtworzyć wynik i odróżnić dowód od atrakcyjnego prototypu.
Przed uruchomieniem należy przypisać odpowiedzialność za wydanie, wyjątki, zmiany, wycofanie i zakończenie eksploatacji. Warto zastosować etapowe wdrożenie, zachować bezpieczny mechanizm awaryjny i sprawdzić monitoring przez celowo wstrzyknięte błędy. Telemetria operacyjna powinna ujawniać jakość wejść, zachowanie wyjść, wersję modelu lub reguł, stan zależności, nadpisania przez człowieka i potwierdzone wyniki bez zbierania zbędnych danych wrażliwych. Trzeba ustalić progi alarmowe i właściciela reakcji, a po wdrożeniu analizować dowody z rzeczywistego działania zamiast zakładać, że wyniki offline się utrzymają. Ponowna ocena jest potrzebna przy każdej zmianie źródeł danych, użytkowników, modeli, dostawców, zasad, sprzętu lub celów. Utrzymywany system wymaga też udokumentowanego odzyskiwania, wniosków z incydentów, procedur usuwania i retencji oraz jasnego punktu, w którym powinien zostać wyłączony albo zastąpiony.
Najczęściej zadawane pytania
Czy każda sieć neuronowa jest głębokim uczeniem?
Nie. Mała sieć z jedną warstwą ukrytą jest siecią neuronową, natomiast głębokie uczenie zwykle oznacza architektury z wieloma wyuczonymi etapami przetwarzania. Granica jest umowna, a nie stanowi ścisłego progu naukowego.
Czy sieci neuronowe przechowują dane treningowe?
Przechowują wyuczone parametry, a nie zwykłą, przeszukiwalną kopię zbioru danych. Duże modele mogą jednak zapamiętywać i odtwarzać pojedyncze przykłady treningowe, co rodzi zagrożenia dla prywatności i praw autorskich, które trzeba testować.
Podstawowe źródła