
Podstawy AI
Czym jest wsteczna propagacja?

 Dodaj Unite.AI do preferowanych źródeł w Google
Backpropagation to algorytm używany do obliczania, jak zmienia się strata sieci neuronowej w odniesieniu do jej parametrów uczących się. Stosuje on regułę łańcuchową rachunku różniczkowego wstecz przez operacje zarejestrowane podczas przejścia w przód.
Backpropagation oblicza gradienty; nie decyduje samodzielnie o aktualizacji. Optymalizator, taki jak stochastic gradient descent lub AdamW, wykorzystuje te gradienty do zmiany wag, biasów i innych parametrów uczących się.
Kluczowe wnioski
- Przejście w przód buduje wartości pośrednie i generuje prognozę.
- Funkcja straty przekształca prognozę i wartość docelową w skalarne kryterium treningowe.
- Backpropagation wykorzystuje pochodne lokalne i regułę łańcuchową do efektywnego obliczania gradientów parametrów.
- Nowoczesne frameworki implementują automatyczną różniczkację w trybie odwrotnym na grafie obliczeniowym.
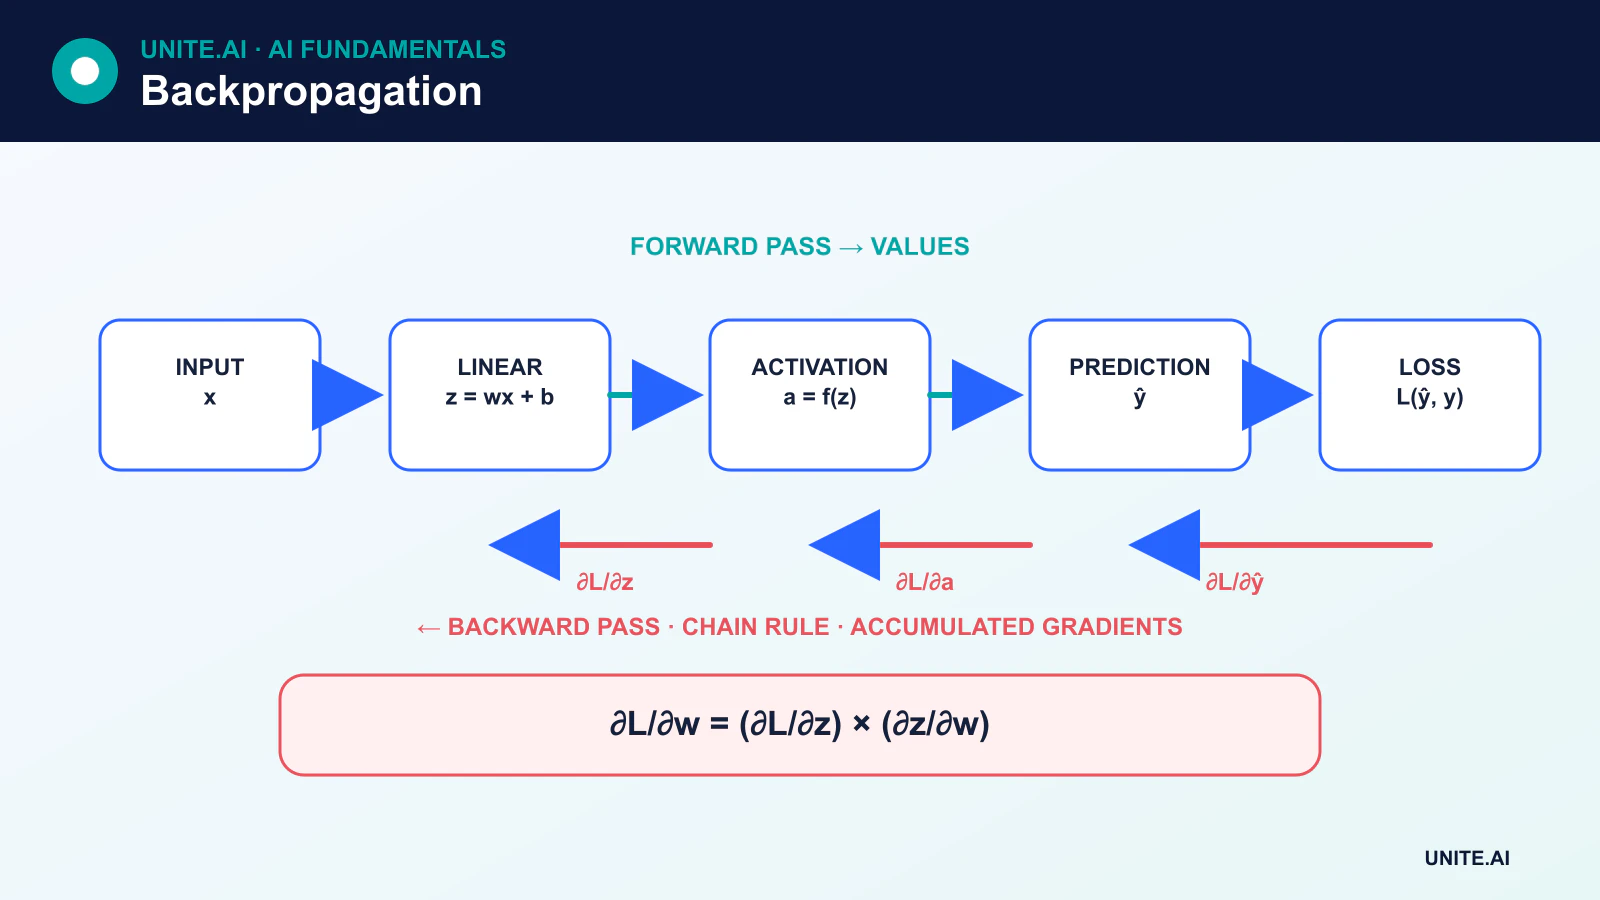
Przejście w przód
Rozważmy prostą jednostkę:
z = wx + bŷ = activation(z)
Wejściem jest x, natomiast w i b są uczącymi się wagami i biasami. Biasy zazwyczaj zmieniają się podczas treningu tak samo jak wagi. Sieć łączy wiele takich operacji, plus normalizację, uwagę, konwolucje, połączenia rezydualnych lub inne różniczkowalne bloki.
Przejście w przód ocenia te operacje i generuje prognozę. Strata, taka jak cross-entropy lub średni błąd kwadratowy, mierzy cel. Najlepsza funkcja straty zależy od zadania i interpretacji wyjścia.
Reguła łańcuchowa
Jeśli strata L zależy od wartości pośredniej z, a z zależy od parametru w, reguła łańcuchowa daje:
∂L/∂w = (∂L/∂z) × (∂z/∂w)
Głęboka sieć zawiera wiele ścieżek. Backpropagation przegląda graf obliczeniowy w odwrotnym kierunku, sumując wkłady, gdy wartość wpływa na stratę przez więcej niż jedną ścieżkę. Wynikiem jest gradient dla każdego uczącego się parametru, który uczestniczył w obliczeniach w przód.
Mały przykład liczbowy
Załóżmy ŷ = wx + b, przy x = 2, w = 3 i b = 1. Predykcja wynosi 7. Jeśli wartość docelowa to 5, a strata jest L = ½(ŷ - y)², wtedy:
∂L/∂ŷ = ŷ - y = 2∂ŷ/∂w = x = 2∂L/∂w = 2 × 2 = 4∂L/∂b = 2 × 1 = 2
Optymalizator może wtedy przesunąć w i b w kierunku przeciwnym do gradientu. Ten wzór jest specyficzny dla wybranej jednostki liniowej i straty kwadratowej; uniwersalna reguła wstecznej propagacji to reguła łańcuchowa na rzeczywistym grafie, a nie jednorazowe równanie „błędu”.
Backpropagation a spadek gradientu
Gradient descent to metoda optymalizacji. Backpropagation dostarcza potrzebne gradienty. Typowy krok treningowy wygląda następująco:
- Wyczyść lub zresetuj zapisane gradienty.
- Wykonaj przejście w przód.
- Oblicz stratę.
- Wykonaj przejście wstecz.
- Zastosuj aktualizację optymalizatora.
Rozdzielenie tych pojęć ułatwia zrozumienie momentum, AdamW, akumulacji gradientów i treningu w mieszanej precyzji.
Automatyczna różniczkacja
Frameworki takie jak PyTorch rejestrują operacje i budują graf podczas przejścia w przód. Automatyczna różniczkacja w trybie odwrotnym następnie efektywnie oblicza iloczyny wektor-Jakobian od wyjść do parametrów. Jest to bardziej ogólne niż ręczne kodowanie pochodnych dla stałej sieci i stanowi podstawę nowoczesnych frameworków deep learning.
Niektóre operacje są nie różniczkowalne lub mają niestabilne pochodne. Frameworki definiują podgradienty lub udokumentowane konwencje w określonych przypadkach, ale praktycy muszą nadal rozumieć odłączone tensory, operacje in-place oraz precyzję numeryczną.
Zanikające i eksplodujące gradienty
Powtarzalne mnożenie przez wiele warstw lub kroków czasowych może spowodować, że gradienty staną się bardzo małe lub bardzo duże. Zanikające gradienty spowalniają uczenie w wcześniejszych warstwach; eksplodujące gradienty destabilizują aktualizacje. Aktywacje z rodziny ReLU, ostrożna inicjalizacja, połączenia rezydualne, normalizacja, bramkowane rekurencje i przycinanie gradientów pomagają, ale żadna z nich nie jest uniwersalnym rozwiązaniem.
Sprawdzanie gradientów
Sprawdzanie gradientów metodą różnic skończonych porównuje gradient analityczny lub automatyczny z przybliżeniem numerycznym. Jest to wolne, ale przydatne przy debugowaniu własnych operacji. Monitorowanie norm gradientów oraz wykrywanie wartości NaN lub nieskończonych może ujawnić niestabilność podczas treningu.
Reguła łańcuchowa w grafie obliczeniowym
Backpropagation efektywnie oblicza gradienty skalarnej straty względem każdego różniczkowalnego parametru. Przejście w przód zapisuje wartości pośrednie w grafie obliczeniowym. Rozpoczynając od straty, automatyczna różniczkacja w trybie odwrotnym stosuje regułę łańcuchową, mnożąc pochodne lokalne i sumując wkłady tam, gdzie ścieżki się spotykają. Dla warstwy y=f(x,w), wrażliwość w górę względem y łączy się z pochodnymi cząstkowymi, aby uzyskać wrażliwości dla x i w. Backpropagation oblicza gradienty; optymalizator decyduje, jak parametry się zmieniają.
Prosta warstwa afiniczna generuje y=Wx+b. Gradient dla W jest iloczynem zewnętrznym gradientu w górę i wejścia, gradient dla b sumuje wartości w górę, a gradient wejścia mnoży się przez transponowaną macierz wag. Aktywacje dodają pochodne elementwise. Konwolucja, normalizacja, uwaga i rekurencyjne ponowne użycie stosują tę samą zasadę grafu, ale wymagają prawidłowych kształtów tensorów, broadcastingu, maskowania i współdzielenia parametrów. Frameworki zwalniają zapisane aktywacje po przejściu wstecz, chyba że są zachowane, więc pamięć często rośnie wraz z rozmiarem batcha, głębokością i długością sekwencji.
Niepowodzenia gradientów, weryfikacja i praktyka inżynierska
Iloczyny wielu pochodnych mogą zanikać lub eksplodować. Aktywacje podobne do ReLU, ostrożna inicjalizacja, normalizacja, połączenia rezydualne, bramkowanie i przycinanie gradientów rozwiązują różne mechanizmy. Nasycone aktywacje i operacje nie różniczkowalne mogą blokować użyteczne sygnały; przycięta wsteczna propagacja ogranicza historię sekwencji; mieszana precyzja może podciekać bez skalowania straty. Eksplodujące gradienty są objawem, więc przycinanie powinno towarzyszyć badaniu współczynnika uczenia, danych, architektury i błędów numerycznych, a nie ich ukrywaniu.
Weryfikuj własne operacje przy pomocy sprawdzania gradientów metodą różnic skończonych na małych danych o podwójnej precyzji, unikając punktów nie różniczkowalnych. Sprawdzaj normy gradientów, NaN-y, nieaktywne parametry oraz czy gradienty docierają do oczekiwanych modułów. Celowo wyczyść zgromadzone gradienty i rozróżniaj zachowanie treningu od ewaluacji w przypadku dropout i normalizacji. Zapisywanie punktów kontrolnych ponownie oblicza aktywacje, aby oszczędzić pamięć; trening rozproszony musi spójnie agregować gradienty. Malejąca strata treningowa pokazuje, że istnieje ścieżka optymalizacji, a nie że gradienty są koncepcyjnie poprawne, dane nie mają wycieków lub model się uogólnia.
Przykład praktyczny: weryfikacja własnej warstwy neuronowej
Inżynier implementuje różniczkowalną warstwę spektralną dla sieci audio. Niewielki test o podwójnej precyzji porównuje gradienty automatyczne z centralnymi różnicami skończonymi dla wejść i parametrów, wykluczając punkty, w których operacja jest celowo nie różniczkowalna. Kształt, broadcasting, padding i konwersja z zespolonych na rzeczywiste otrzymują osobne przypadki. Test weryfikuje zgromadzone gradienty, gdy parametr jest ponownie używany, i potwierdza, że zamaskowane ramki audio nie generują gradientu.
Podczas treningu panele kontrolne monitorują normy gradientów i aktywacji, NaN-y, nieaktywne parametry oraz skalowanie straty. Celowo uszkodzona partia potwierdza, że walidacja wykrywa niefinansowe wyjście przed aktualizacją optymalizatora. Implementacje w mieszanej precyzji i wyeksportowane są porównywane z referencją. Testy wznawiania z punktu kontrolnego obejmują stan optymalizatora i losową kolejność. Warstwa nie jest akceptowana jedynie dlatego, że całkowita strata spada; gradienty jednostkowe, stabilność numeryczna i uogólnienie w dół łańcucha muszą dostarczyć spójnych dowodów.
Dowody implementacji i gotowość operacyjna
Decyzja produkcyjna wymaga więcej niż udanej demonstracji. Zdefiniuj docelowych użytkowników, środowisko operacyjne, wejścia, wyjścia, zależności, właściciela oraz konsekwencje każdego istotnego błędu. Ustal odtwarzalną bazę i wersjonowany zestaw ewaluacyjny przed strojeniem. Testuj typowe przypadki, warunki brzegowe, niepoprawne lub brakujące dane wejściowe, przesunięcie rozkładu, awarię zależności, niewłaściwe użycie oraz grupy lub środowiska najprawdopodobniej niedoszacowane. Mierz jakość zadania wraz z kalibracją lub niepewnością, opóźnieniem, przepustowością, kosztami zasobów, dostępnością, prywatnością i bezpieczeństwem. Zapisz każdą transformację i próg, aby niezależny recenzent mógł odtworzyć wynik i odróżnić dowody od atrakcyjnego prototypu.
Przed uruchomieniem przydziel uprawnienia do wydania, wyjątków, zmian, wycofania i wycofania. Użyj stopniowanego wdrożenia, zachowaj bezpieczną alternatywę i zweryfikuj monitorowanie przy celowo wprowadzonych awariach. Telemetria operacyjna powinna ujawniać jakość danych wejściowych, zachowanie wyjść, wersję modelu lub reguły, stan zależności, interwencje ludzkie oraz potwierdzone wyniki, nie zbierając niepotrzebnych wrażliwych danych. Zdefiniuj progi alarmowe i właściciela reakcji, a następnie przeglądaj dowody z rzeczywistego świata po wdrożeniu, zamiast zakładać, że offline’owa wydajność będzie trwała. Ponownie oceniaj, gdy zmieniają się źródła danych, użytkownicy, modele, dostawcy, polityki, sprzęt lub cele. Utrzymany system wymaga również udokumentowanego odzyskiwania, nauki z incydentów, procedur usuwania i przechowywania oraz wyraźnego punktu, w którym powinien zostać wyłączony lub zastąpiony.
Najczęściej zadawane pytania
Czy backpropagation aktualizuje wagi?
Backpropagation oblicza gradienty. Optymalizator stosuje aktualizację wykorzystując te gradienty, jego współczynnik uczenia oraz ewentualnie stan, taki jak momentum lub adaptacyjne momenty.
Czy backpropagation jest biologicznie realistyczny?
Standardowy backpropagation jest algorytmem inżynierskim i nie jest uznawany za szczegółowy model uczenia się w biologicznych mózgach. Historyczna analogia do neuronów nie powinna być traktowana jako biologiczna równowartość.
Podstawowe źródła












