
Podstawy AI
Czym jest wizja komputerowa?

 Dodaj Unite.AI do preferowanych źródeł w Google
Wizja komputerowa to dziedzina tworzenia systemów, które wydobywają użyteczne informacje z obrazów i wideo. Model wizji może klasyfikować cały obraz, wykrywać obiekty, etykietować każdy piksel, odczytywać tekst, szacować pozycję, śledzić ruch lub łączyć treść wizualną z językiem.
Nowoczesne systemy wizji nie ograniczają się do odtwarzania wczesnego procesu wykrywania krawędzi w ludzkiej percepcji. Uczą się reprezentacji specyficznych dla zadania na podstawie danych, często wykorzystując splotowe sieci neuronowe, transformery wizji lub multimodalne modele bazowe.
Kluczowe wnioski
- Klasyfikacja, wykrywanie, segmentacja, OCR, śledzenie i generowanie to odrębne zadania wizji.
- Sieci CNN wbudowują lokalność i współdzielenie wag; transformery wizji używają uwagi pomiędzy fragmentami obrazu.
- Etykiety mogą pochodzić od ludzi, słabej nadzoru, danych syntetycznych lub celów samonadzorowanych.
- Sama dokładność jest niewystarczająca: ważne są także odporność, opóźnienie, prywatność, uprzedzenia i koszty awarii.
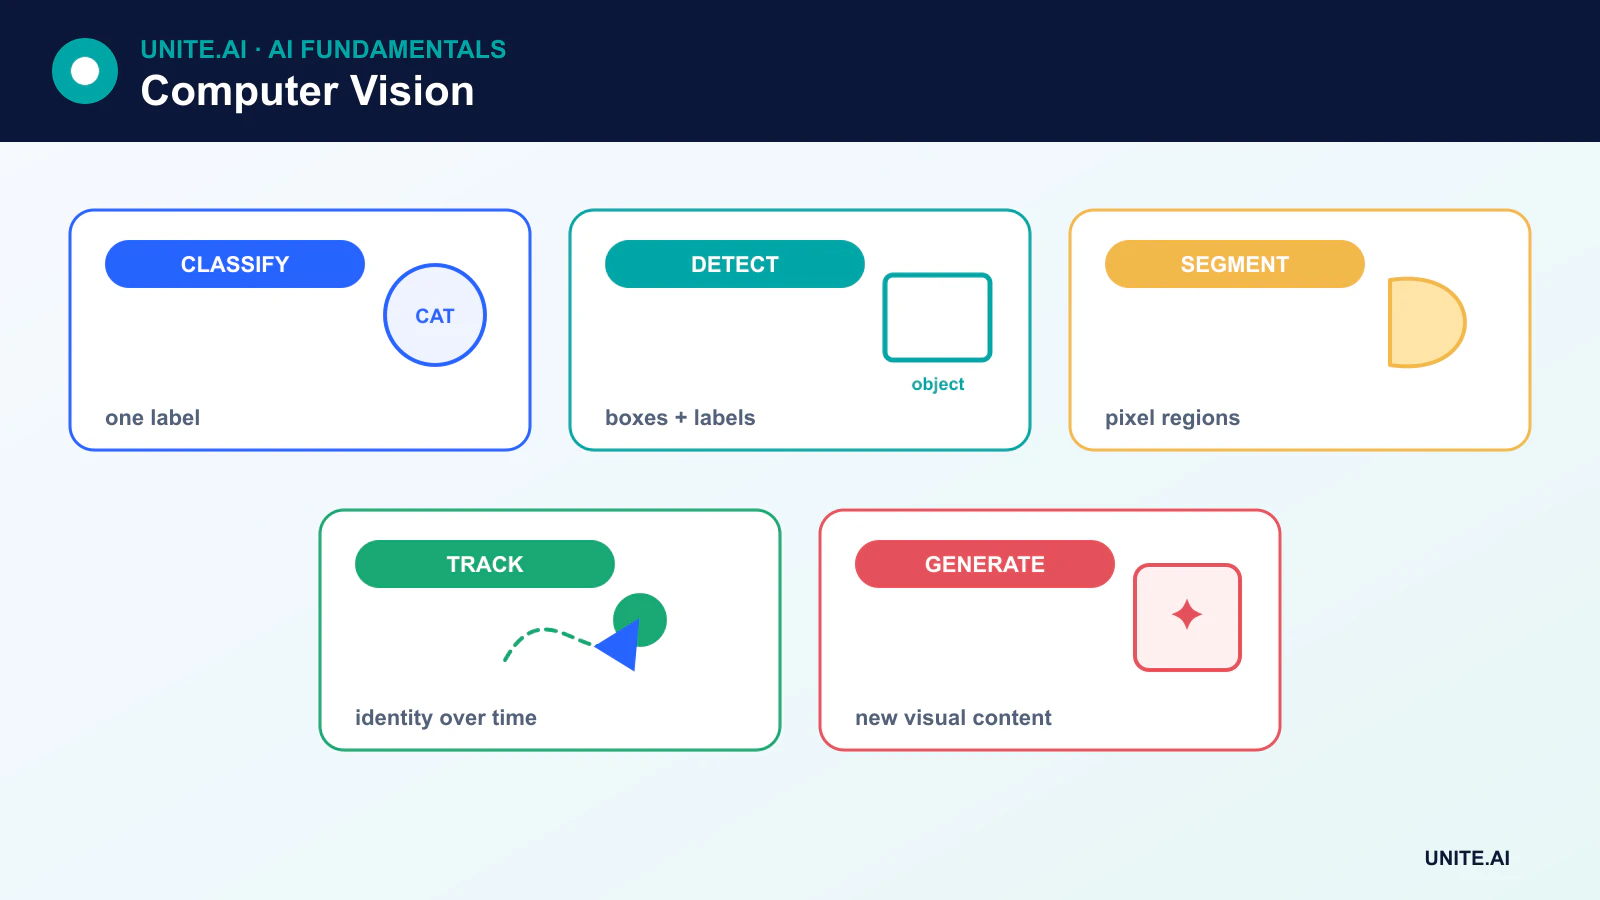
Główne zadania wizji komputerowej
- Klasyfikacja obrazu przypisuje jedną lub więcej etykiet do obrazu. Zobacz jak działa klasyfikacja obrazu.
- Wykrywanie obiektów przewiduje kategorie i ramki ograniczające dla wielu obiektów.
- Segmentacja semantyczna etykietuje każdy piksel według klasy, natomiast segmentacja instancji oddziela poszczególne obiekty.
- Rozpoznawanie znaków optycznych (OCR) wykrywa i transkrybuje tekst.
- Estymacja pozy przewiduje punkty charakterystyczne ciała lub obiektu.
- Śledzenie kojarzy wykrycia pomiędzy klatkami wideo.
- Generowanie i edycja obrazów tworzy lub przekształca treści wizualne, często przy użyciu modeli dyfuzyjnych.
Jak obrazy stają się wejściami modelu
Obraz cyfrowy jest już danymi numerycznymi: tensorem zawierającym wartości pikseli w wymiarach przestrzennych i kanałach. Wstępne przetwarzanie może zmieniać rozmiar, normalizować, przycinać lub augmentować obraz. Wideo dodaje wymiar czasu, a obrazowanie medyczne i naukowe może dodawać głębię, długość fali lub inne modalności.
Klasyczna wizja komputerowa wykorzystywała ręcznie projektowane cechy krawędzi, narożników i tekstur. Współczesne modele głębokie zazwyczaj uczą cechy wspólnie z zadaniem, choć metody klasyczne pozostają przydatne, gdy dane są ograniczone, reguły dobrze znane lub wymagana jest minimalna moc obliczeniowa.
Sieci CNN i wyuczone cechy lokalne
Sieć CNN stosuje wyuczone jądra na lokalnych sąsiedztwach. Wczesne warstwy mogą reagować na lokalne wzorce, podczas gdy późniejsze bloki łączą je w reprezentacje istotne dla zadania. Operacje pooling lub ze stride’em zmniejszają rozdzielczość przestrzenną, a połączenia rezydualnych ułatwiają optymalizację głębokich sieci.
Nowoczesny klasyfikator CNN często używa globalnego poolingu zamiast dużej liczby w pełni połączonych warstw. Detektory i sieci segmentacyjne dodają wyspecjalizowane głowice lub ścieżki dekodera, które zachowują informacje przestrzenne.
Transformery wizji i modele bazowe
Transformer wizji dzieli obraz na fragmenty, osadza je i używa mechanizmu uwagi do modelowania ich relacji. Transformery mogą skutecznie skalować się przy dużych zbiorach danych i wstępnym treningu, podczas gdy sieci CNN często oferują silniejsze wbudowane założenia i wydajność przy mniejszych skalach.
Modele multimodalne łączą obrazy z tekstem, umożliwiając użytkownikom wyszukiwanie, tworzenie podpisów, odpowiadanie na pytania lub kierowanie segmentacją przy użyciu języka. Modele te zwiększają możliwości, ale także dziedziczą słabości wynikające z szerokich danych internetowych, w tym stereotypy, materiały objęte prawem autorskim oraz nierównomierne pokrycie populacji i środowisk.
Etykiety, samonadzór i dane syntetyczne
Tworzenie ramek ograniczających, masek, punktów charakterystycznych i opisów może być kosztowne. Uczenie samonadzorowane wyprowadza cele z samych obrazów, podczas gdy słaby nadzór wykorzystuje szumne lub pośrednie etykiety. Dane syntetyczne mogą dodać rzadkie scenariusze, ale luki w symulacji mogą uniemożliwić przeniesienie wydajności syntetycznej na rzeczywisty świat.
Jakość anotacji musi być mierzona. Niejasne etykiety, niespójne granice i brakujące obiekty ograniczają maksymalną wydajność i mogą ukrywać awarie w podgrupach.
Jak ocenia się systemy wizji
Klasyfikacja używa metryk takich jak dokładność, precyzja, czułość, F1 oraz kalibracja. Wykrywanie najczęściej stosuje Intersection over Union i średnią precyzję (mAP). Segmentacja używa Intersection over Union lub miar w stylu Dice. Śledzenie dodaje metryki tożsamości i trajektorii.
Metryka musi odpowiadać warunkom wdrożenia. Model może uzyskać wysoką ocenę na starannie dobranym benchmarku, a mimo to zawieść w deszczu, przy słabym oświetleniu, nietypowych kątach kamery, nowych urządzeniach lub nieznanych populacjach. Ocena powinna uwzględniać zmianę rozkładu, warunki adwersarialne oraz opóźnienie operacyjne.
Prywatność, uprzedzenia i wdrożenie
Tw twarze, tablice rejestracyjne, domy, skany medyczne i wideo z miejsca pracy mogą ujawniać wrażliwe informacje. Zbieranie i przechowywanie powinny odbywać się na określonej podstawie prawnej i etycznej, z kontrolą dostępu i minimalizacją danych. Analiza twarzy i identyfikacja biometryczna wymagają szczególnej uwagi, ponieważ błędy i nadzór mogą powodować nierówne szkody.
Wdrożenie na brzegu (edge) może zmniejszyć opóźnienie i transfer danych. Edge AI, kwantyzacja, przycinanie i specjalistyczne akceleratory mogą uczynić systemy wizji praktycznymi na kamerach, pojazdach, robotach i urządzeniach mobilnych, ale kompresję należy ponownie ocenić pod kątem dokładności i uprzedzeń.
Od pikseli do zadań wizualnych
Wizja komputerowa przekształca obrazy lub wideo w wyniki zadań, takich jak klasyfikacja, wykrywanie, segmentacja, śledzenie, pozycja, głębia, przepływ optyczny lub rozpoznawanie tekstu. Definicja zadania określa anotację: etykieta obrazu nie może wytrenować precyzyjnej lokalizacji, a ramka ograniczająca nie opisuje w pełni maski segmentacji. Geometria kamery, obiektywy, ekspozycja, oświetlenie, ruch, kompresja i punkt widzenia kształtują rozkład danych. Zdefiniuj środowisko operacyjne i konsekwencje błędów przed wyborem modelu, ponieważ zbiór obrazów benchmarkowych może nie odzwierciedlać wdrożonego czujnika lub sceny.
Pipeline dekoduje i orientuje media, zmienia ich rozmiar lub dzieli na kafelki, normalizuje wartości, stosuje augmentację zachowującą etykiety, uruchamia model i przetwarza wyniki (logity, ramki, maski lub ślady). Detektory obiektów używają progów pewności i supresji; trackery kojarzą wykrycia w czasie; segmentacja może wymagać czyszczenia morfologicznego. Zachowaj przekształcenia współrzędnych, aby wyniki były zgodne z oryginalnym obrazem. Podziel dane według osoby, kamery, lokalizacji lub sesji nagrania, aby uniknąć pojawiania się prawie identycznych klatek w zestawach treningowych i testowych.
Ewaluacja, uprzedzenia, prywatność i operacje
Metryki muszą odpowiadać zadaniu i zastosowaniu. Klasyfikacja wymaga precyzji i czułości specyficznych dla klasy; wykrywanie używa Intersection-over-Union i średniej precyzji w różnych progach; segmentacja używa IoU lub Dice; śledzenie dodaje zmiany tożsamości; opóźnienie i czas trwania pominiętych zdarzeń mają znaczenie wideo. Raportuj wyniki według oświetlenia, odległości, urządzenia, zasłonięcia, odcienia skóry, wieku i innych istotnych warunków. Sprawdzaj kalibrację i błędy przy wysokiej pewności. Dane syntetyczne lub augmentowane mogą wypełniać luki, ale wymagają porównania z rzeczywistymi danymi wdrożeniowymi i nie mogą ujawniać scen testowych.
Wizja może zbierać osoby postronne, lokalizacje, dane biometryczne i wrażliwe zachowania. Minimalizuj przechwytywanie i przechowywanie, zabezpiecz strumienie, ogranicz użycie wtórne i zapewnij powiadomienie lub zgodę, gdy jest to wymagane. Testuj adwersarialne patche, odtwarzanie, zasłonięcie, awarie kamery i zmianę domeny. Monitoruj stan czujników, statystyki wejść, wskaźniki wyjść i potwierdzone wyniki; utrzymuj przegląd ludzki przy decyzjach o konsekwencjach. Rozmycie lub przycięcie może zmniejszyć ekspozycję, ale może też usunąć dowody. Wysoki wynik w laboratorium nie uzasadnia roszczeń dotyczących tożsamości, emocji czy intencji poza zweryfikowanym zadaniem.
Przykład praktyczny: wykrywanie pieszych przy przejściu w magazynie
Kamery monitorują ograniczone przejście pojazdów, a model wykrywa osoby, a nie ich identyfikuje. Dane obejmują dzień i noc, warunki pogodowe, ubiór, zasłonięcia, użytkowników wózków, pozycje kamer oraz puste sceny, podzielone według sesji nagrania. Detektor jest oceniany pod kątem przywołania zdarzeń, fałszywych alarmów, lokalizacji, czasu ostrzeżenia oraz wydajności w zależności od odległości. Inżynieria bezpieczeństwa definiuje maksymalne dopuszczalne opóźnienie i niezależne kontrolki fizyczne.
Alert wizji może spowolnić pojazd, ale awaryjne zatrzymania i bariery nie zależą od wyuczonego modelu. Zasłonięcie kamery, zamrożone klatki, utrata sieci i przekroczenie limitu czasu modelu generują wyraźne usterki. Przechowywanie surowego wideo jest minimalizowane, a dostęp logowany. Monitorowanie śledzi stan czujników, częstotliwość alertów, przeglądane incydenty i bliskie wypadki według warunków. Każda relokacja kamery lub zmiana układu wywołuje ponowną walidację, ponieważ pozorna podobieństwo obrazu nie gwarantuje tej samej geometrii ani ryzyka.
Dowody implementacji i gotowość operacyjna
Decyzja produkcyjna wymaga więcej niż udanej demonstracji. Zdefiniuj docelowych użytkowników, środowisko operacyjne, wejścia, wyjścia, zależności, właściciela oraz konsekwencje każdego istotnego błędu. Ustal powtarzalną bazę i wersjonowany zestaw ewaluacyjny przed dostrojeniem. Testuj typowe przypadki, warunki brzegowe, nieprawidłowe lub brakujące dane wejściowe, zmianę rozkładu, awarię zależności, niewłaściwe użycie oraz grupy lub środowiska najprawdopodobniej niedostatecznie obsłużone. Mierz jakość zadania wraz z kalibracją lub niepewnością, opóźnieniem, przepustowością, kosztami zasobów, dostępnością, prywatnością i bezpieczeństwem. Zarejestruj każde przekształcenie i próg, aby niezależny recenzent mógł odtworzyć wynik i odróżnić dowody od atrakcyjnego prototypu.
Przed uruchomieniem przydziel uprawnienia do wydania, wyjątków, zmian, wycofania i wycofania. Stosuj etapowe wdrożenie, zachowaj bezpieczną alternatywę i zweryfikuj monitorowanie poprzez celowo wprowadzane awarie. Telemetria operacyjna powinna ujawniać jakość danych wejściowych, zachowanie wyjść, wersję modelu lub reguły, stan zależności, interwencje ludzkie i potwierdzone wyniki bez gromadzenia niepotrzebnych wrażliwych danych. Zdefiniuj progi alarmów i właściciela reakcji, a następnie przeglądaj dowody z rzeczywistego świata po wdrożeniu, zamiast zakładać, że offline’owa wydajność będzie trwała. Ponownie oceniaj, gdy zmieniają się źródła danych, użytkownicy, modele, dostawcy, polityki, sprzęt lub cele. Utrzymany system wymaga także udokumentowanego odzyskiwania, nauki z incydentów, procedur usuwania i przechowywania oraz wyraźnego momentu, w którym powinien zostać wyłączony lub zastąpiony.
Najczęściej zadawane pytania
Czy wizja komputerowa jest tym samym co rozpoznawanie obrazu?
Nie. Rozpoznawanie obrazu zazwyczaj odnosi się do klasyfikacji lub identyfikacji. Wizja komputerowa obejmuje także lokalizację, segmentację, pomiar, śledzenie, rekonstrukcję, generowanie i wnioskowanie na podstawie informacji wizualnych.
Czy system wizji widzi tak jak człowiek?
Nie. Model przetwarza dane numeryczne zgodnie ze swoją architekturą i celem treningowym. Może przewyższyć ludzi w wąskim benchmarku, ale nie radzi sobie ze drobnymi zmianami, które człowiek łatwo opanowuje.
Podstawowe odniesienia












