
Podstawy AI
Jak działa klasyfikacja obrazów?

 Dodaj Unite.AI do preferowanych źródeł w Google
Klasyfikacja obrazów przewiduje etykietę dla całego obrazu. Odpowiada na pytania takie jak „Jaką kategorię produktu przedstawiono?” lub „Czy ten skan zawiera poszukiwany wynik?”. Nie lokalizuje ona jednak poszczególnych obiektów ani nie wyznacza ich pikseli.
Współczesne systemy zazwyczaj wykorzystują konwolucyjne sieci neuronowe lub transformatory wizji, często inicjalizowane wagami wstępnie wytrenowanymi. Niezawodna wydajność nadal zależy od etykiet, próbkowania, augmentacji, kalibracji oraz testowania w rzeczywistych warunkach wdrożenia.
Kluczowe wnioski
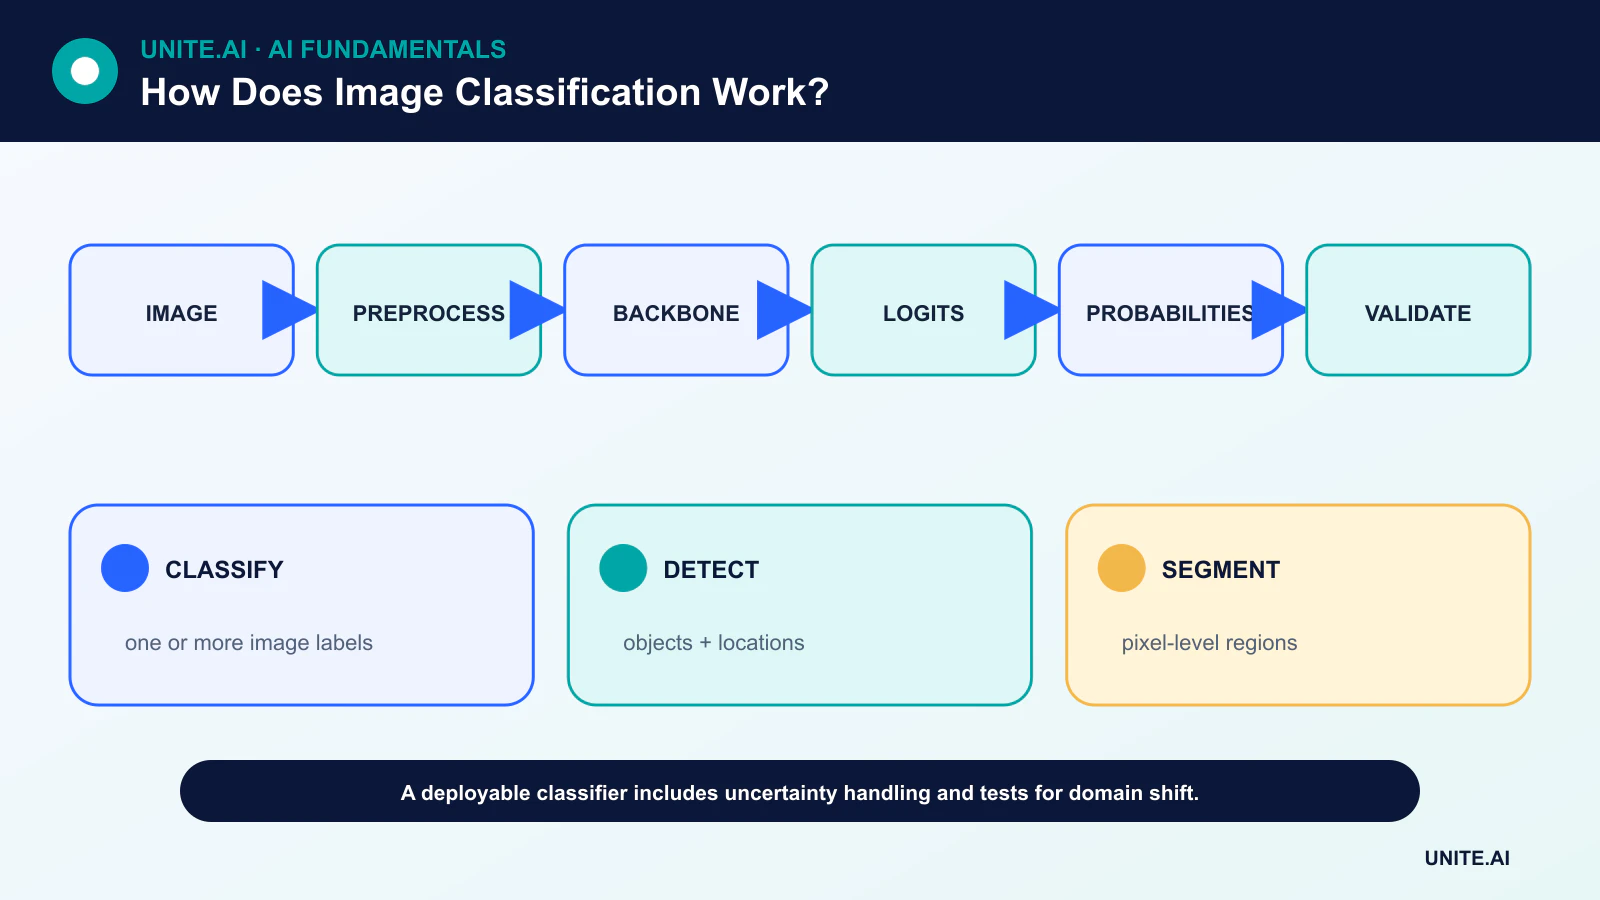
- Klasyfikacja etykietuje cały obraz; detekcja rysuje ramki wokół obiektów, a segmentacja przypisuje regiony na poziomie pikseli.
- Wstępne uczenie i transfer learning mogą zmniejszyć zapotrzebowanie na dane, ale niezgodność domen może zniwelować korzyść.
- Wskaźnik ogólnej dokładności może ukrywać niezrównoważenie klas, fałszywe skróty oraz słabą kalibrację.
- Jakość obrazu, urządzenie przechwytujące, geografia oraz zmiany w przepływie pracy mogą powodować przesunięcie rozkładu.
Od pikseli do wyników
Obrazy są skalowane lub przycinane, normalizowane i konwertowane na tensory. Augmentacja danych może stosować transformacje zachowujące etykiety, takie jak odbicia, przycięcia czy zmiany kolorów. Sieć bazowa mapuje piksele na cechy; głowica klasyfikacji generuje logity, które są przekształcane w względne wyniki klas.
Wybrany preprocessing musi odpowiadać środowisku wdrożenia. Centralne przycięcie usuwające istotny obiekt lub niezgodność normalizacji może pogorszyć wydajność, nawet gdy wytrenowane wagi pozostają niezmienione.
Sieci CNN i transformatory wizji
Sieci konwolucyjne używają lokalnych filtrów i współdzielonych wag do budowania cech przestrzennych. Połączenia rezydualnych ułatwiły optymalizację bardzo głębokich sieci CNN. Transformatory wizji dzielą obraz na fragmenty i wykorzystują mechanizm uwagi do modelowania zależności pomiędzy nimi.
Porównania architektur powinny kontrolować dane treningowe, augmentację, moc obliczeniową i rozdzielczość. Najlepszy model w publicznym benchmarku niekoniecznie będzie najlepszy dla urządzenia brzegowego, małego zestawu danych ani wymogu wyjaśnialności.
Transfer learning i projektowanie danych
Transfer learning zaczyna się od wag wytrenowanych na większym zestawie danych źródłowych. Zespół może zamrozić sieć bazową, dostroić późniejsze warstwy lub zaktualizować cały model. Dostosowywanie zazwyczaj wymaga niższej stawki uczenia i zestawu walidacyjnego chroniącego przed wyciekami.
Etykiety powinny opisywać to, co jest widocznie wnioskowalne. Jeśli diagnoza zależy od historii pacjenta, której nie ma na obrazie, klasyfikator nie może nauczyć się pełnej decyzji klinicznej. Duplikaty, klatki z jednego wideo oraz obrazy tego samego podmiotu muszą pozostać w tym samym podziale.
Metryki, niepewność i skróty
Dokładność Top-1 wymaga, aby klasa o najwyższym wyniku była poprawna; dokładność top‑k akceptuje poprawną klasę wśród k najwyższych wyników. Precyzja, czułość per klasa oraz macierz pomyłek ujawniają nierówne błędy.
Modele mogą wykorzystywać tła, znaki wodne, sprzęt akwizycji lub kadrowanie zamiast zamierzonego obiektu. Testy kontrfaktyczne, analiza podgrup i narzędzia saliency mogą pomóc wykryć skróty, ale mapa cieplna wyjaśnienia nie jest dowodem na przyczynowe rozumowanie.
Monitorowanie wdrożenia
Kontrole produkcyjne powinny obejmować uszkodzone pliki, nieoczekiwane wymiary, rozmycie, oświetlenie, modele kamer oraz nowe klasy. Pewność powinna być skalibrowana na danych przypominających środowisko wdrożenia, a wejścia spoza zakresu powinny być odrzucane lub poddawane przeglądowi.
Monitorowanie opóźnionych etykiet oraz zmian kosztów błędów jest niezbędne. Model, który wydaje się stabilny na podstawie statystyk wejść, może nadal zawieść, jeśli relacja między pikselami a etykietami ulegnie zmianie.
Tworzenie zestawu danych do klasyfikacji obrazów
Klasyfikacja obrazów przypisuje jedną lub więcej etykiet całemu obrazowi. Różni się od detekcji, która lokalizuje obiekty, oraz segmentacji, która etykietuje piksele. Zdefiniuj zakres klas, hierarchię, zasady wieloetykietowości, kategorie tła lub nieznane oraz jakie dowody muszą być widoczne. Zbierz kamery, lokalizacje, oświetlenie, kąty widzenia, odległości i obiekty reprezentatywne dla wdrożenia. Podziel dane według podmiotu, sceny, sesji lub źródła przed augmentacją; sąsiadujące klatki wideo lub zduplikowane obrazy produktów w różnych podziałach powodują poważne wycieki.
Instrukcje anotacji powinny obejmować zasłonięcia, niejednoznaczne obiekty, wiele klas, niską jakość oraz odmowę oznaczenia. Mierz zgodność i przeglądaj systematyczne rozbieżności. Samo zrównoważenie klas nie gwarantuje pokrycia: klasa choroby może obejmować jedno urządzenie, a klasa dzikiej przyrody jedno tło. Sprawdź metadane i bliskie duplikaty oraz zachowaj chroniony zestaw testowy pochodzący z niezależnego pozyskania. Dane syntetyczne i web scraping mogą zwiększyć różnorodność, ale wprowadzają problemy z licencjonowaniem, pochodzeniem, stylem i etykietami, które muszą być oceniane na rzeczywistych obrazach.
Modele, trening i ocena
Klasyczne metody łączą inżynierskie deskryptory z klasyfikatorem; nowoczesne systemy używają sieci konwolucyjnych lub transformerów wizji, często z wykorzystaniem transfer learningu. Wybór skalowania i przycięcia decyduje, które informacje przetrwają. Augmentacja powinna odzwierciedlać dopuszczalne wariacje i zachowywać etykiety. Optymalizuj funkcję straty odpowiednią dla zadania, radź sobie z niezrównoważeniem poprzez ważenie lub staranną próbkę, i wybieraj punkty kontrolne na danych walidacyjnych. Porównaj z prostą bazą i przeprowadzaj ablację augmentacji, rozdzielczości oraz wstępnej inicjalizacji, aby dowiedzieć się, skąd pochodzą zyski.
Raportuj precyzję, czułość, F1, macierz pomyłek oraz dokładność top‑k, gdy ma to znaczenie, kalibrację i wydajność w zależności od warunków. Testuj rozmycie, kompresję, oświetlenie, przycięcie, zasłonięcie, urządzenie oraz wejścia bez obsługiwanej klasy. Progi pewności mogą kierować niepewne przypadki do przeglądu; prawdopodobieństwo softmax nie jest gwarancją pewności, szczególnie przy przesunięciach. Testy tła kontrfaktycznego i zasłonięcia ujawniają uczenie się skrótów. W zastosowaniach związanych z bezpieczeństwem oceń najgorsze scenariusze awarii oraz konsekwencje fałszywych alarmów i pominięć.
Wdrożenie i monitorowanie
Spakuj dekodowanie, konwersję kolorów, orientację, normalizację, model i mapę etykiet razem. Zweryfikuj wyeksportowany lub kwantowany artefakt na docelowych urządzeniach i zmierz opóźnienie end‑to‑end, pamięć, zużycie energii oraz przepustowość. Monitoruj jakość obrazu, rozkłady wejść i wyjść, kalibrację, potwierdzone etykiety oraz stan czujników. Minimalizuj i zabezpieczaj przechowywanie obrazów, szczególnie twarzy, lokalizacji i osób postronnych. Zapewnij mechanizm awaryjny dla uszkodzonych lub spoza zakresu wejść oraz możliwość wycofania wersji modelu. Klasyfikacja odpowiada na zdefiniowane pytanie na poziomie obrazu; nie powinna być rozciągana na nieobsługiwane lokalizacje, tożsamość czy intencje.
Przykład praktyczny: klasyfikacja materiałów podlegających recyklingowi
Obiekt fotografuje przedmioty na taśmie i oznacza klasę materiału, zanieczyszczenie oraz nieznane. Obrazy są podzielone według dnia zbioru i partii obiektów, obejmując oświetlenie, mokre powierzchnie, zgniecenia, nakładanie się i puste taśmy. Mała sieć CNN oraz model wstępnie wytrenowany są porównywane z regułami koloru i kształtu. Wskaźnik czułości per klasa, błędne sortowanie, kalibracja, przepustowość oraz wyniki w zależności od kamery i warunków materiału determinują wybór.
Linia produkcyjna weryfikuje ekspozycję kamery i synchronizację taśmy, a następnie kieruje niepewne przedmioty do ogólnego strumienia zamiast wymuszać klasyfikację. Kwantowane wnioskowanie jest weryfikowane na dokładnym sprzęcie. Monitorowanie śledzi jakość wejść, wskaźniki klas, odrzuty oraz losowo wybrane kontrole ręczne; nowe opakowania wywołują przegląd aktualizacji danych. Model steruje ograniczonym sortownikiem z fizycznymi zabezpieczeniami, a awaria czujnika lub modelu przywraca mechanizm do stanu bezpiecznego zamiast cichego błędnego kierowania materiałem.
Dowody wdrożeniowe i gotowość operacyjna
Decyzja produkcyjna wymaga więcej niż udanej demonstracji. Zdefiniuj docelowych użytkowników, środowisko operacyjne, wejścia, wyjścia, zależności, właściciela oraz konsekwencje każdego istotnego błędu. Ustal odtwarzalną bazę i wersjonowany zestaw ewaluacyjny przed dostrojeniem. Testuj typowe przypadki, warunki brzegowe, nieprawidłowe lub brakujące wejścia, przesunięcie rozkładu, awarie zależności, niewłaściwe użycie oraz grupy lub środowiska najprawdopodobniej niedostatecznie obsłużone. Mierz jakość zadania wraz z kalibracją lub niepewnością, opóźnieniem, przepustowością, kosztami zasobów, dostępnością, prywatnością i bezpieczeństwem. Zapisz każdą transformację i próg, aby niezależny recenzent mógł odtworzyć wynik i odróżnić dowody od atrakcyjnego prototypu.
Przed uruchomieniem przydziel uprawnienia do wydania, wyjątków, zmian, wycofania i wycofania wersji. Stosuj etapowe wdrożenie, zachowaj bezpieczną alternatywę i zweryfikuj monitorowanie przy celowo wprowadzonych awariach. Telemetria operacyjna powinna ujawniać jakość wejść, zachowanie wyjść, wersję modelu lub reguły, stan zależności, interwencje ludzkie oraz potwierdzone wyniki bez gromadzenia niepotrzebnych danych wrażliwych. Zdefiniuj progi alarmowe i właściciela reakcji, a następnie przeglądaj dowody z rzeczywistego świata po wdrożeniu, zamiast zakładać, że offline’owa wydajność będzie trwała. Przeprowadzaj ponowną ocenę przy zmianie źródeł danych, użytkowników, modeli, dostawców, polityk, sprzętu lub celów. Utrzymany system wymaga także udokumentowanych procedur odzyskiwania, nauki po incydentach, usuwania i przechowywania oraz wyraźnego momentu, w którym powinien zostać wyłączony lub zastąpiony.
Najczęściej zadawane pytania
Czy klasyfikator obrazów może rozpoznać kilka obiektów?
Klasyfikator wieloetykietowy może wskazać, które kategorie są obecne, ale nie lokalizuje poszczególnych egzemplarzy. Do uzyskania ramek lub liczebności potrzebna jest detekcja obiektów.
Dlaczego model może zawieść na zdjęciach, które wydają się normalne dla człowieka?
Może on opierać się na artefaktach przechwytywania, teksturach lub korelacjach, które uległy zmianie. Małe różnice w preprocessing’u oraz przesunięcie domeny mogą również wpływać na wyuczone cechy.
Podstawowe źródła












