
AI-basisprincipes
Wat is Deep Learning?

 Voeg Unite.AI toe aan je voorkeursbronnen op Google
Deep learning is een familie van machine‑learning‑methoden die neurale netwerken met meerdere verwerkingslagen gebruiken om bruikbare representaties van gegevens te leren. Deze modellen aandrijven veel moderne systemen voor taal, afbeeldingen, audio, aanbevelingen, wetenschappelijke voorspellingen en generatieve AI.
Het woord deep verwijst naar het aantal transformaties tussen invoer en uitvoer, niet naar een machine die een dieper begrip bezit. Een deep model leert numerieke relaties die nuttig zijn voor zijn trainingsdoel, en de prestaties moeten nog steeds worden getest op nieuwe gegevens.
Belangrijkste punten
- Deep learning is een subset van machine learning.
- Lagen transformeren tensors met behulp van geleerde parameters, niet‑lineaire activaties, normalisatie en andere bewerkingen.
- Backpropagation berekent de gradiënten; een optimizer gebruikt die gradiënten om trainbare parameters, inclusief gewichten en biases, bij te werken.
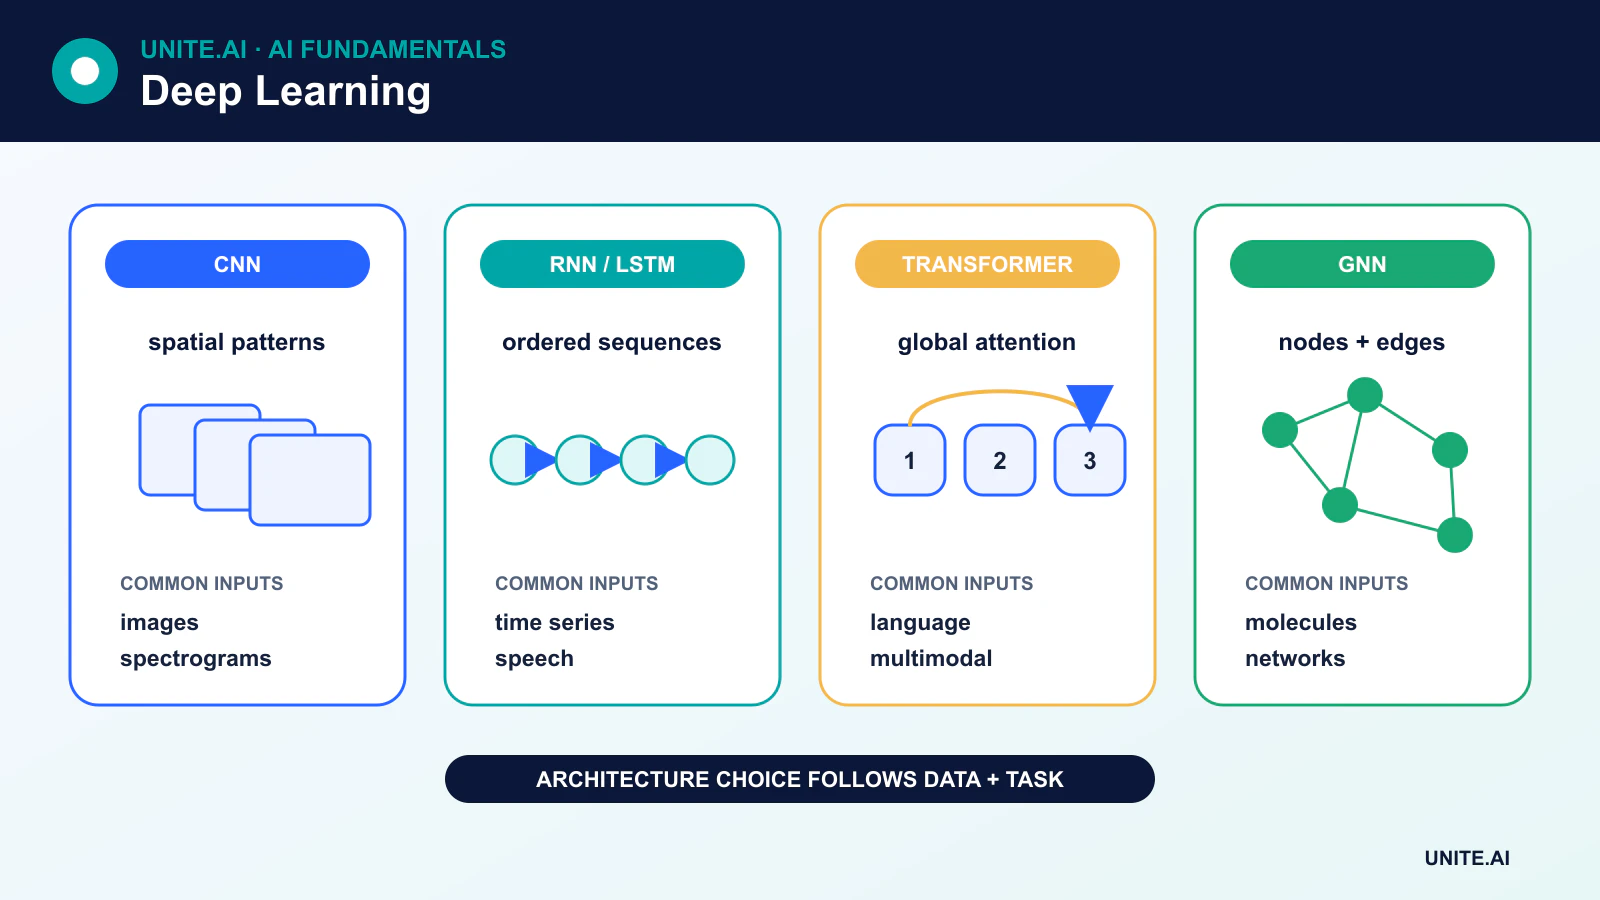
- CNN’s, recurrent netwerken, transformers, autoencoders en diffusiemodellen hebben verschillende structuren en sterktes.
Hoe een deep neuraal netwerk leert
Een neuraal netwerk ontvangt gegevens als tensors, of multidimensionale arrays van getallen. Een beeldtensor kan pixelkanalen coderen, terwijl een taalmodel vectoren gebruikt die tokens vertegenwoordigen. Elke laag voert een differentieerbare transformatie uit en geeft het resultaat door aan de volgende laag.
In een eenvoudige dense‑laag berekent het model een gewogen som van zijn invoer, voegt een trainbare bias toe, en past vervolgens een activatiefunctie toe:
output = activation(Wx + b)
De activatiefunctie introduceert niet‑lineariteit. Zonder deze zou het stapelen van gewone lineaire lagen nog steeds slechts een lineaire transformatie vertegenwoordigen. ReLU en zijn varianten zijn gangbaar in verborgen lagen, terwijl output‑activaties afhangen van de taak.
Training volgt doorgaans vier stappen:
- Een forward pass genereert voorspellingen.
- Een loss‑functie meet hoe de voorspellingen afwijken van het doel.
- Backpropagation past de kettingregel toe om de gradiënt van de loss ten opzichte van elke trainbare parameter te berekenen.
- Een optimizer zoals stochastic gradient descent of AdamW werkt de parameters bij.
Het herhalen van deze stappen over vele batches kan het model verbeteren, maar een lagere trainingsloss garandeert geen betrouwbare prestaties in de echte wereld. Validatie, regularisatie, representatieve gegevens en monitoring blijven essentieel.
Belangrijke deep‑learning‑architecturen
Multilayer perceptrons
Een multilayer perceptron (MLP) gebruikt volledig verbonden lagen waarbij elke output‑eenheid afhankelijk is van alle invoer van de voorgaande laag. MLP’s zijn nuttig voor tabulaire kenmerken en als componenten binnen grotere systemen, maar ze bouwen geen aannames in over beeldlokaliteit of volgorde van een reeks.
Convolutionele neurale netwerken
Convolutionele neurale netwerken (CNN’s) passen geleerde filters toe over lokale regio’s. Gewichtsdeling maakt ze efficiënt voor rasters zoals afbeeldingen en spectrogrammen. CNN’s blijven belangrijk voor visie en edge‑implementaties, hoewel vision‑transformers en hybride modellen ook veel worden gebruikt.
Recurrente netwerken, LSTM’s en GRU’s
Recurrente neurale netwerken (RNN’s) updaten een verborgen toestand terwijl een reeks wordt verwerkt. LSTM’s en gated recurrent units helpen informatie te behouden en verminderen het probleem van verdwijnende gradiënten waardoor basis‑RNN’s moeite hebben met lange afhankelijkheden. Ze elimineren niet elke beperking van lange context, maar blijven nuttig voor streaming‑signalen, tijdreeksgegevens en compacte sequentiële modellen.
Transformers
Transformers gebruiken attention om relaties tussen elementen van een reeks of set te modelleren. Hun vermogen om veel posities parallel te verwerken heeft hen geholpen om recursie te vervangen in de meeste grootschalige taalsystemen, en transformer‑varianten verwerken nu afbeeldingen, audio, video, eiwitten en multimodale gegevens.
Autoencoders en generatieve modellen
Een autoencoder comprimeert een invoer tot een representatie en reconstrueert de invoer daarvan. Dit creëert een zelf‑supervised reconstructiedoel; het zet niet automatisch niet‑gelabelde gegevens om in gelabelde voorbeelden.
Generative adversarial networks trainen een generator en discriminator in competitie. Diffusiemodellen leren een geleidelijk ruisproces om te keren. Autoregressieve transformers genereren één token of eenheid per keer. Deze benaderingen hebben verschillende trainingsdynamieken, controleerbaarheid en rekencapaciteit.
Waarom diepte helpt – en waarom architectuur belangrijk is
Meerdere lagen stellen een model in staat om eenvoudigere transformaties samen te stellen tot complexere. In visie kunnen sommige geleerde kenmerken evolueren van lokale texturen naar taak‑specifieke patronen. In taal bouwen attention‑lagen context‑afhankelijke token‑representaties op. Deze beschrijvingen zijn nuttige intuïties, geen vaste regels voor wat elke laag moet leren.
Moderne netwerken vertrouwen ook op residual‑verbindingen, normalisatie, zorgvuldige initialisatie, regularisatie en geoptimaliseerde hardware. Het simpelweg toevoegen van lagen of parameters kan een model moeilijker te trainen maken, trager, of gevoeliger voor overfitting. Model‑schaal helpt alleen wanneer de gegevens, het doel, de optimalisatie en de implementatie‑omgeving dit ondersteunen.
Training versus inferentie
Training past parameters aan en is meestal de rekenintensieve fase. Inferentie voert het getrainde model uit om een output te produceren. Inferentie kan nog steeds duur zijn voor grote modellen, daarom gebruiken teams kwantisatie, distillatie, batching, caching, sparsity en gespecialiseerde hardware zoals neural processing units.
Beperkingen en verantwoord gebruik
Deep modellen kunnen bias overnemen, gevoelige informatie onthouden, falen bij distributieverschuiving, en overtuigende maar onjuiste outputs produceren. Ze kunnen ook moeilijk te interpreteren zijn en duur om te trainen. Evaluatie moet meer omvatten dan een gemiddelde benchmark: teams hebben prestaties op klasse‑ of subgroepniveau, robuustheid, calibratie, beveiliging, latentie, energieverbruik en de gevolgen van falen nodig.
Representaties, optimalisatie en architectuurkeuzes
Deep netwerken leren opeenvolgende representaties via geparameteriseerde lagen. Lineaire transformaties mengen invoer; niet‑lineaire activaties stellen het netwerk in staat complexe functies te benaderen; normalisatie en residual‑verbindingen helpen bij optimalisatie; attention, convolutie, recursie of state‑space‑operaties coderen verschillende structurele aannames. Diepte vergroot het aantal transformaties, niet gegarandeerde intelligentie. Architectuur moet de modaliteit, datavolume, latentie, geheugen en invarianten van de taak weerspiegelen. Een kleiner convolutioneel model kan een transformer overtreffen wanneer gegevens beperkt zijn en lokale ruimtelijke structuur domineert.
Training berekent een loss, differentieert deze met backpropagation, en werkt parameters bij met een optimizer zoals stochastic gradient descent of Adam. Batch‑grootte, leersnelheid, schema, initialisatie, regularisatie en numerieke precisie beïnvloeden elkaar. Curves voor trainings‑ en validatieloss helpen onder‑fitten, over‑fitten, instabiliteit en lekken te onderscheiden, maar ze bewijzen geen bruikbaarheid in de echte wereld. Gebruik onafhankelijke evaluatiegegevens, herhaalde runs waar variantie belangrijk is, ablatie‑studies en vergelijking met eenvoudigere baselines. Grote aantallen parameters verhogen ook de behoefte aan datagovernance, compute‑planning en reproduceerbare configuratie.
Deep modellen veilig en efficiënt bedienen
Implementatie kan een gehoste endpoint, dedicated accelerator, browser, telefoon of embedded apparaat gebruiken. Export en compilatie kunnen operatoren fuseren, gewichten en activaties kwantiseren, of numeriek gedrag wijzigen, dus valideer het uitgerolde artefact in plaats van alleen de trainings‑checkpoint. Meet cold start, stabiele latentie, doorvoer, geheugen, energie en kwaliteit bij realistische batch‑ en sequentiegroottes. Compressiemethoden — pruning, distillatie, kwantisatie en low‑rank adaptatie — ruilen grootte of snelheid in voor nauwkeurigheid en technische complexiteit en moeten worden beoordeeld op gevoelige klassen en randgevallen.
Deep modellen kunnen zelfverzekerd falen bij distributieverschuiving, adversarial invoer, schijnbare correlatie en slecht vertegenwoordigde groepen. Monitor invoer‑ en output‑distributies, taakresultaten, calibratie, resource‑gebruik en afhankelijkheidsversies. Gebruik toegangscontrole, ondertekende artefacten, beschermde trainingsdata, red‑team‑oefeningen en snelheidslimieten passend bij het dreigingsmodel. Uitleg zoals saliency‑maps of attention‑weergaven zijn diagnostisch bewijs, geen bewijs van causaliteit. Combineer ze met gedrags‑tests, tegenfeitelijke scenario’s, menselijke beoordeling, incidentrespons en expliciete limieten op geautomatiseerde beslissingen.
Voorbeeld: trainen van een beelddefectdetector
Een fabriek verzamelt productafbeeldingen van verschillende camera’s, shifts, materialen en bekende defectklassen, en splitst vervolgens op productiebatch zodat bijna‑dubbele items niet over partitions heen kunnen. Een kleine convolutionele baseline wordt vergeleken met een voorgetraind deep netwerk. Augmentatie reproduceert gevalideerde verlichting- en gezichtspuntvariatie zonder defecten te wissen. Evaluatie rapporteert per‑defect recall, false‑reject‑rate, calibratie, inferentie‑latentie en robuustheid tegen onscherpte, schittering, camera‑vervanging en zeldzame materiaalkleuren.
Het geëxporteerde model en de exacte resize‑, kleur‑ en normalisatiecode worden getest op de productielijn‑hardware voor duurzame doorvoer en thermisch gedrag. Low‑confidence gevallen gaan naar inspecteurs; een onafhankelijke regel stopt de lijn bij een veiligheid‑kritieke sensormislukking. Afbeeldingen worden alleen bewaard zoals toegestaan en model‑artefacten zijn ondertekend. Monitoring koppelt voorspellingen aan latere inspectieresultaten en productielots. Een nieuwe camera of materiaal triggert een gecontroleerde herbeoordeling in plaats van stilzwijgende online‑learning van niet‑gecontroleerde labels.
Bewijs van implementatie en operationele gereedheid
Een productiebeslissing vereist meer dan een succesvolle demonstratie. Definieer de beoogde gebruikers, operationele omgeving, invoer, uitvoer, afhankelijkheden, eigenaar en de consequentie van elke belangrijke fout. Stel een reproduceerbare baseline en een versie‑gecontroleerde evaluatieset vast vóór afstemming. Test gewone gevallen, randvoorwaarden, misvormde of ontbrekende invoer, distributieverschuiving, afhankelijkheidsuitval, misbruik, en de groepen of omgevingen die waarschijnlijk onderbediend zijn. Meet taakkwaliteit samen met calibratie of onzekerheid, latentie, doorvoer, resource‑kosten, toegankelijkheid, privacy en beveiliging. Leg elke transformatie en drempel vast zodat een onafhankelijke reviewer het resultaat kan reproduceren en bewijs kan onderscheiden van een aantrekkelijk prototype.
Voor de lancering moet autoriteit worden toegewezen voor release, uitzonderingen, wijzigingen, rollback en pensionering. Gebruik een gefaseerde uitrol, behoud een veilige fallback, en verifieer monitoring met doelbewust geïnjecteerde fouten. Operationele telemetrie moet de invoer‑kwaliteit, output‑gedrag, model‑ of regelversie, afhankelijkheids‑gezondheid, menselijke overrides en bevestigde uitkomsten onthullen zonder onnodige gevoelige gegevens te verzamelen. Definieer alarm‑drempels en een verantwoordelijke voor respons, en beoordeel vervolgens bewijs uit de praktijk na implementatie in plaats van te veronderstellen dat offline prestaties aanhouden. Her‑evalueer telkens wanneer gegevensbronnen, gebruikers, modellen, leveranciers, beleidsregels, hardware of doelstellingen veranderen. Een onderhouden systeem heeft ook gedocumenteerd herstel, incident‑leren, verwijder‑ en retentierichtlijnen, en een duidelijk punt waarop het moet worden uitgeschakeld of vervangen nodig.
Primaire referenties












