AI-basisprincipes
Wat zijn neurale netwerken?

 Voeg Unite.AI toe aan je voorkeursbronnen op Google
Een kunstmatig neuraal netwerk is een geparametriseerd wiskundig model opgebouwd uit lagen van onderling verbonden bewerkingen. Tijdens het trainen past het netwerk zijn parameters aan zodat invoer wordt omgezet in bruikbare uitvoer. Neurale netwerken kunnen complexe niet‑lineaire relaties benaderen en representaties leren direct uit tekst, afbeeldingen, audio, tijdreeksen en andere gegevens.
De naam is historisch geïnspireerd op biologische neuronen, maar moderne netwerken zijn technisch‑engineered systemen en geen realistische simulaties van de hersenen. Termen als ‘neuron’ en ‘leren’ zijn handige afkortingen en moeten niet worden aangezien voor bewijs van mensachtige cognitie.
Belangrijkste punten
- Een neuron berekent een gewogen som, voegt een trainbare bias toe en past een activatiefunctie toe.
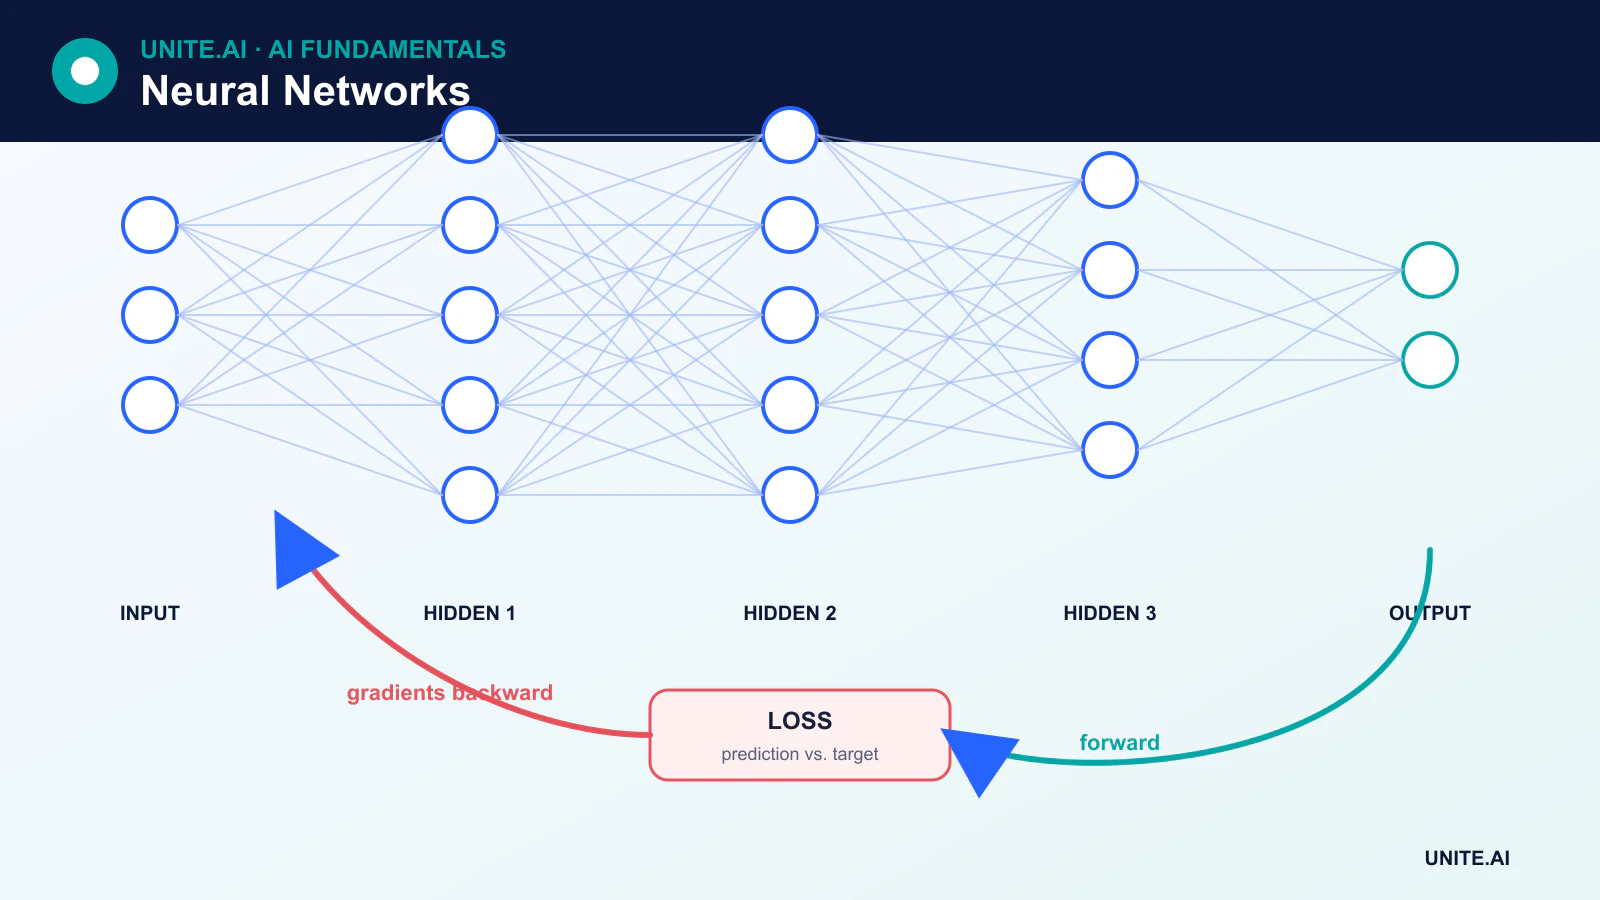
- Een forward‑pass genereert voorspellingen; een verliesfunctie meet de fout; backpropagation berekent de gradiënten; een optimizer werkt de parameters bij.
- MLP’s, CNN’s, RNN’s en transformers organiseren de verbindingen op verschillende manieren.
- Meer lagen of parameters leveren niet automatisch een beter of betrouwbaarder model op.
Van een enkel kunstmatig neuron tot een netwerk
Voor een invoervector x berekent een basiseenheid:
z = Wx + boutput = activation(z)
W bevat trainbare gewichten en b is een trainbare bias. De activatiefunctie introduceert niet‑lineariteit. De gewichten ‘passeren’ de activatie niet zelfstandig; de activatie wordt toegepast op de gewogen som en de bias.
Een multilayer perceptron (MLP) stapelt dichte lagen. De invoerlaag vertegenwoordigt de kenmerken, verborgen lagen transformeren deze, en de uitvoerlaag is ontworpen voor de taak — bijvoorbeeld klasse‑logits of een regressiewaarde.
Hoe neurale netwerken leren
- Het model initialiseert trainbare parameters.
- Een forward‑pass verwerkt een batch en genereert voorspellingen.
- Een verliesfunctie vergelijkt de voorspellingen met het trainingsdoel.
- Backpropagation gebruikt de kettingregel om gradiënten te berekenen.
- Een optimizer, zoals stochastic gradient descent of AdamW, werkt gewichten en biases bij.
Backpropagation werd centraal in de training van neurale netwerken door werk dat zich over meerdere decennia ontwikkelde en populair werd; het werd niet voor het eerst gecreëerd in het recente deep‑learning tijdperk. Moderne frameworks implementeren reverse‑mode automatische differentiatie zodat beoefenaars niet handmatig elke gradiënt hoeven af te leiden.
Waarom activatiefuncties belangrijk zijn
Zonder niet‑lineaire activaties vallen meerdere gewone lineaire lagen samen tot één lineaire transformatie. ReLU wordt veel gebruikt omdat het eenvoudig en efficiënt is. GELU en SiLU komen vaak voor in moderne architecturen. Sigmoid en softmax blijven nuttig voor specifieke uitvoerinterpretaties, maar sigmoid kan verzadigen in verborgen lagen en bijdragen aan verdwijnende gradiënten.
Belangrijkste architecturen van neurale netwerken
Convolutionele neurale netwerken
CNNs passen geleerde filters toe over lokale buurten en delen parameters over posities. Deze eigenschappen maken ze efficiënt voor afbeeldingen en andere raster‑achtige signalen.
Recurrente netwerken
RNNs, LSTMs, en GRUs werken een verborgen toestand bij over een reeks. Ze blijven nuttig voor streaming‑ en tijdreeks‑taken, hoewel recursie parallel verwerken beperkt en problemen kan geven bij lange afhankelijkheden.
Transformers
Transformers gebruiken attention om context‑afhankelijke representaties te creëren. Residual‑verbindingen, normalisatie, positie‑informatie en feed‑forward‑blokken vormen kernonderdelen van de architectuur. Transformers vormen nu de basis van veel grote taal‑ en multimodale modellen.
Auto‑encoders en generatieve netwerken
Auto‑encoders leren representaties via reconstructie. GANs, diffusiemodellen en autoregressieve netwerken genereren nieuwe monsters met verschillende doelstellingen en trainingsprocedures.
Componenten die diepe netwerken trainbaar maken
Moderne systemen gebruiken meer dan alleen lagen en activaties. Residual‑verbindingen laten informatie en gradiënten blokken omzeilen. Normalisatie stabiliseert activaties. Regularisatie, data‑augmentatie, dropout en gewicht‑decay kunnen overfitting verminderen. Embedding‑lagen mappen discrete items zoals tokens naar vectoren. Attention laat een representatie dynamisch afhangen van andere elementen.
Sterktes en beperkingen
Neurale netwerken kunnen kenmerken leren uit hoogdimensionale ruwe data en schalen met data en rekencapaciteit. Ze kunnen echter ook grote datasets, gespecialiseerde hardware en zorgvuldige afstemming vereisen. Hun voorspellingen kunnen slecht gekalibreerd zijn, breekbaar onder distributieverandering, kwetsbaar voor adversaire manipulatie, of moeilijk te verklaren.
De architectuur moet aansluiten bij de taak en implementatie‑beperkingen. Voor veel tabulaire problemen kan een boom‑ensemble of lineair model sneller en makkelijker te valideren zijn. Voor toepassingen met hoge inzet moet de modelprestaties worden geëvalueerd per subgroep en faalmodus, niet alleen via een aggregaat‑benchmark.
Lagen, activaties en informatiestroom
Een neuraal netwerk bestaat uit geparametriseerde functies. Elke eenheid vormt een gewogen combinatie van invoer, voegt een bias toe en geeft het resultaat door een activatie zoals ReLU, sigmoid, tanh of GELU. Het stapelen van lagen maakt hiërarchische kenmerken en niet‑lineaire beslissingsgrenzen mogelijk. Breedte bepaalt het aantal eenheden per laag; diepte bepaalt opeenvolgende transformaties; connectiviteit en gewichtsdeling definiëren de architectuur. De uitvoer van het netwerk hangt samen met preprocessing, parameters, normalisatie en de inferentiemodus. Een neuron is een wiskundige bewerking, geen letterlijke biologische neuron of een op zichzelf betekenisvol concept.
Forward‑propagation berekent voorspellingen; een verliesfunctie kwantificeert de fout; backpropagation past de kettingregel toe op de gradiënten; een optimizer werkt de parameters bij. Initialisatie, leersnelheid, batch‑statistieken, residual‑paden en normalisatie beïnvloeden of gradiënten verdwijnen, exploderen of bruikbaar blijven. Regularisatie omvat gewicht‑decay, dropout, augmentatie, early stopping en architecturale beperkingen. Plot het trainings‑ en validatiegedrag, inspecteer gradiënt‑ en activatiestatistieken, en vergelijk herhaalde runs. Een groot netwerk kan trainingsdata memoriseren, terwijl een klein netwerk kan onder‑fitten of noodzakelijke structuur mist.
Selectie, evaluatie en inzet van architecturen
Multilayer perceptrons verwerken vaste vectoren; convolutionele netwerken benutten lokale structuur; recurrente en state‑space modellen verwerken sequenties; transformers gebruiken attention; graaf‑netwerken wisselen informatie uit langs randen. Hybriden zijn gebruikelijk. Kies op basis van inductieve bias, data, sequentie‑ of afbeeldingsgrootte, latentie, geheugen, interpreteerbaarheid en beschikbare hardware. Evalueer ten opzichte van een lineaire of boom‑baseline en voer ablatie‑studies uit om te leren welke complexiteit relevant is. Alleen het aantal parameters voorspelt geen kwaliteit, inferentiekosten of databehoefte.
Implementatie vereist bevroren preprocessing, een geëxporteerde of gecompileerde graaf, numerieke validatie en resource‑tests onder realistische belasting. Kwantisatie en pruning kunnen de grootte verkleinen, maar kunnen het gedrag van zeldzame klassen wijzigen. Monitor invoer, uitvoer, calibratie, latentie en bevestigde uitkomsten; test op adversaire en verschoven data. Bescherm modellen, afhankelijkheden en data via ondertekende artefacten, toegangscontrole en supply‑chain review. Uitleg vanuit individuele activaties of saliency vereist causale en gedragsverificatie. Neurale netwerken zijn flexibele functie‑approximatoren, geen garantie voor begrip, waarheid of robuustheid.
Voorbeeld: een neurale vraagvoorspeller
Een retailer voorspelt de wekelijkse vraag naar artikelen op basis van verkoop, promoties, prijs, feestdagen, beschikbaarheid en weer. Het netwerk wordt vergeleken met seizoens‑naïeve, lineaire en boom‑baselines via rollende tijdsplitsingen. Toekomstige promoties worden alleen meegenomen wanneer ze daadwerkelijk bekend zijn op het moment van de voorspelling, terwijl stock‑outs worden gemodelleerd omdat waargenomen verkoop de vraag kan onderschatten. Evaluatie maakt gebruik van gewogen absolute fout, bias, intervaldekking en resultaten per artikel‑snelheid en winkel.
De implementatie‑pipeline versieert functionaliteit, model en horizon en weigert een voorspelling wanneer vereiste invoer verouderd is. Planners zien intervallen en kunnen overschrijven met geregistreerde redenen. Monitoring detecteert ontbrekende feeds, veranderende fouten, bias en ongebruikelijke voorspellingen; bedrijfsresultaten worden gescheiden van voorspellingsnauwkeurigheid omdat bestellingsbeleid ook invloed heeft op de voorraad. Een model‑update wordt over meerdere cycli in de schaduw gezet, en de vorige voorspeller blijft beschikbaar voor rollback tijdens seizoens‑ of leveranciers‑verstoring.
Bewijs van implementatie en operationele gereedheid
Een productie‑beslissing vereist meer dan een succesvolle demonstratie. Definieer de beoogde gebruikers, operationele omgeving, invoer, uitvoer, afhankelijkheden, eigenaar en de consequentie van elke belangrijke fout. Stel een reproduceerbare baseline en een versie‑gecontroleerde evaluatieset vast vóór afstemming. Test gewone gevallen, randvoorwaarden, misvormde of ontbrekende invoer, distributieverandering, uitval van afhankelijkheden, misbruik, en de groepen of omgevingen die waarschijnlijk onderbediend zijn. Meet taakkwaliteit samen met calibratie of onzekerheid, latentie, doorvoersnelheid, resource‑kosten, toegankelijkheid, privacy en beveiliging. Leg elke transformatie en drempel vast zodat een onafhankelijke reviewer het resultaat kan reproduceren en bewijs kan onderscheiden van een aantrekkelijk prototype.
Voor de lancering moet autoriteit worden toegewezen voor release, uitzonderingen, wijzigingen, rollback en pensionering. Gebruik een gefaseerde uitrol, behoud een veilige fallback, en verifieer monitoring met bewust geïnjecteerde fouten. Operationele telemetrie moet de kwaliteit van invoer, het gedrag van uitvoer, model‑ of regelversie, gezondheid van afhankelijkheden, menselijke overrides en bevestigde uitkomsten onthullen zonder onnodige gevoelige data te verzamelen. Definieer alarm‑drempels en een verantwoordelijke voor respons, en beoordeel vervolgens bewijsmateriaal uit de praktijk na implementatie in plaats van aan te nemen dat offline prestaties blijven bestaan. Her‑evalueer telkens wanneer gegevensbronnen, gebruikers, modellen, leveranciers, beleid, hardware of doelstellingen veranderen. Een onderhouden systeem heeft ook gedocumenteerd herstel, incident‑leren, verwijder‑ en retentieprocedures, en een duidelijk moment waarop het moet worden uitgeschakeld of vervangen nodig.
Veelgestelde vragen
Is elk neuraal netwerk deep learning?
Nee. Een klein netwerk met één verborgen laag is een neuraal netwerk, terwijl deep learning doorgaans verwijst naar architecturen met meerdere geleerde verwerkingsstappen. De grens is conventioneel en niet een strikte wetenschappelijke drempel.
Opslaan neurale netwerken hun trainingsdata?
Ze slaan geleerde parameters op, niet een gewone doorzoekbare kopie van de dataset. Desondanks kunnen grote modellen individuele trainingsvoorbeelden memoriseren en reproduceren, wat privacy‑ en auteursrechtenrisico’s oplevert die getest moeten worden.
Primaire referenties