AI-basisprincipes
Wat is Few-Shot Learning?

 Voeg Unite.AI toe aan je voorkeursbronnen op Google
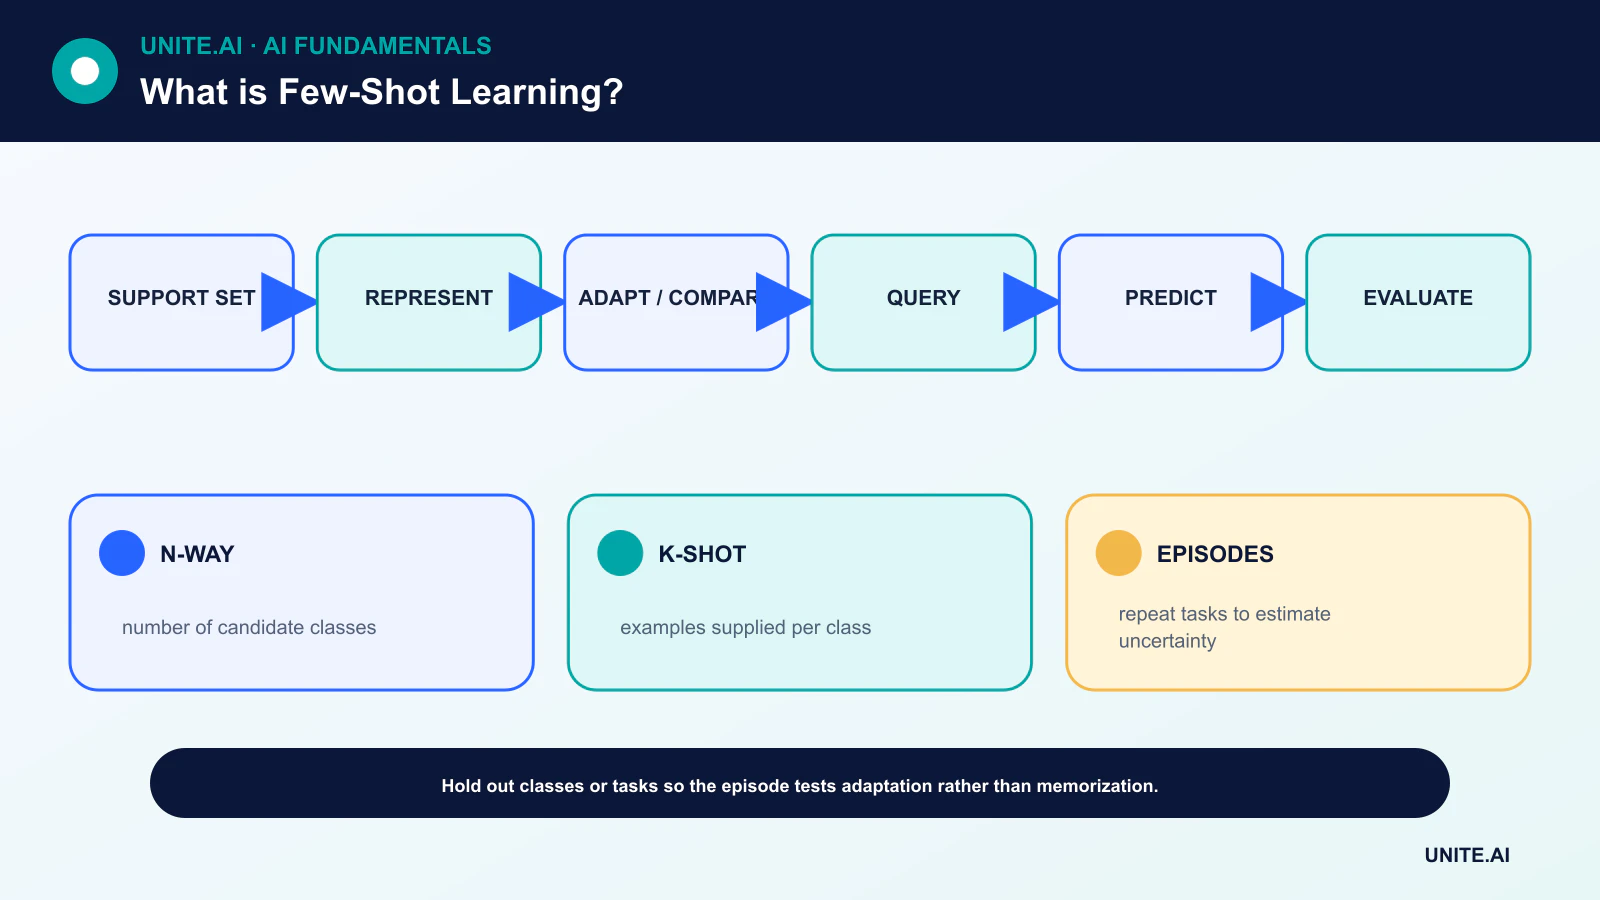
Few-shot learning bestudeert hoe een model zich kan aanpassen aan een nieuwe taak of klasse met slechts een klein aantal gelabelde voorbeelden. In klassieke benchmarks levert een episode een supportset—bijvoorbeeld vijf klassen met één of vijf voorbeelden per klasse—en vraagt het model om niet‑geziene queries te classificeren.
De term wordt ook gebruikt voor in-context leren, waarbij een voorgetraind taalmodel enkele demonstraties in zijn prompt ontvangt zonder parameters bij te werken. Deze instellingen delen een doel met weinig voorbeelden, maar gebruiken verschillende aanpassingsmechanismen en vereisen verschillende evaluatie‑ontwerpen.
Belangrijkste conclusies
- N-way K-shot beschrijft N klassen en K gelabelde supportvoorbeelden per klasse.
- Metric‑learning methoden vergelijken queries met geleerde representaties van supportvoorbeelden.
- Meta‑learning optimaliseert over veel taken zodat een nieuwe taak snel kan worden geleerd.
- Weinig voorbeelden vergroten label‑fouten, lekken, klasse‑ambiguïteit en onzekerheid, waardoor baselines en het rapporteren van vertrouwen belangrijk zijn.
Episodes, supportsets en querysets
Een few-shot episode scheidt een kleine gelabelde supportset van een queryset die voor evaluatie wordt gebruikt. Tijdens meta‑training ziet het model veel van dergelijke episodes. Een sterke evaluatie houdt volledige klassen, taken of domeinen apart, zodat de test‑episode adaptatie meet in plaats van memorisatie.
Rapporteer nauwkeurigheidsdistributies over vele episodes in plaats van één handige steekproef. Vergelijk met eenvoudige nearest‑neighbor‑ en lineaire baselines; een geavanceerde methode die geen beter resultaat behaalt dan een goed getrainde representatie plus een basisklassificator, rechtvaardigt mogelijk haar complexiteit niet.
Metric learning en prototypes
Matching‑netwerken en verwante methoden embedden support‑ en query‑voorbeelden in een ruimte waarin nabije vectoren dezelfde label zouden moeten delen. Prototypische netwerken middelen de support‑embeddings per klasse en classificeren een query op basis van de afstand tot die klasse‑prototypes.
Dit verbindt few-shot learning aan de kwaliteit van representaties. Een voorgetraind deep-learning model kan reeds relevante kenmerken goed organiseren, terwijl een niet‑passende representatie elke afstand misleidend kan maken.
Optimalisatie‑gebaseerde meta‑learning
Model‑Agnostic Meta‑Learning zoekt naar parameters die zich kunnen aanpassen met een klein aantal gradientstappen. Andere methoden leren een optimizer, een initiële toestand of een regel voor parameterupdates. De outer‑loop evalueert de prestaties na adaptatie over taken.
Meta‑learning gaat ervan uit dat nuttige structuur wordt gedeeld tussen trainings‑ en doeltaak. Wanneer de doel‑distributie sterk verschilt, kan snelle adaptatie falen. Validatie moet variëren in aantal shots, klassen, domeinen en taak‑moeilijkheid in plaats van één benchmark als universeel te beschouwen.
Transfer learning en dataniveau‑strategieën
Transfer learning is vaak het sterkste praktische startpunt: bevries een voorgetrainde encoder, train een kleine head, en fine‑tune selectief als er voldoende data beschikbaar zijn. Data‑augmentatie kan invarianten introduceren, maar onrealistische synthetische voorbeelden kunnen bias versterken of shortcuts creëren.
Active learning kan prioriteit geven aan welke voorbeelden gelabeld moeten worden, terwijl semi‑supervised learning extra ongelabelde data kan benutten. Dit zijn complementaire strategieën, geen synoniemen voor few-shot learning.
Few-shot prompting verschilt
Een transformer kan een patroon afleiden uit demonstraties die in zijn context worden geplaatst. Er is geen permanente parameter‑update vereist. Volgorde, formulering en labelbalans kunnen de output wezenlijk veranderen, en voorbeelden kunnen een groot deel van het context‑venster innemen.
Gebruik een representatieve evaluatieset, versioneer elke prompt en demonstratie, en test zero‑shot, few‑shot en fine‑tuned alternatieven. Een kleine supportset ondersteunt geen sterke, populatie‑brede beweringen, vooral niet voor zeldzame of veiligheid‑kritieke gevallen.
Few-shot learning paradigma’s en taakconstructie
Few-shot learning heeft als doel een taak uit te voeren met zeer weinig gelabelde voorbeelden. In metric‑gebaseerde methoden mappt een encoder voorbeelden naar een ruimte waarin dichtstbijzijnde prototypes of buren klassen representeren. Optimalisatie‑gebaseerde meta‑learning traint een initiële toestand of update‑regel voor snelle adaptatie. Transfer learning fine‑tuned een voorgetraind model op een kleine doelset. In‑context learning levert voorbeelden in een prompt zonder gewichten bij te werken. Deze mechanismen verschillen, dus beweringen moeten specificeren of parameters veranderen, welke voorafgaande training plaatsvond en hoe voorbeelden worden geselecteerd.
Evaluatie moet trainings‑ en testklassen, taken, onderwerpen of domeinen scheiden volgens de beweerde generalisatie. Een N‑way K‑shot episode bevat N klassen en K supportvoorbeelden per klasse, plus query‑voorbeelden voor scoring. Herhaalde episodes schatten de variantie door supportselectie. Voor prompting kunnen voorbeeldvolgorde, labelformulering, formaat en demonstratie‑gelijkenis de resultaten wezenlijk beïnvloeden. Vergelijk met zero‑shot, nearest‑neighbor, linear‑probe en gewone fine‑tuning baselines met dezelfde representatie en databudget.
Datakwaliteit, onzekerheid en negatieve transfer
Met weinig voorbeelden hebben verkeerd gelabelde of atypische gevallen een buitensporige invloed. Definieer annotatieregels, inspecteer elk supportitem en behoud een onbekende of onthoudende uitkomst. Data‑augmentatie en synthetische voorbeelden kunnen alleen helpen wanneer ze de taak behouden en realistische variatie toevoegen. Een voorgetraind model kan shortcuts of bias uit zijn bron‑domein overdragen. Test out‑of‑domain gevallen, zeldzame groepen en de gevoeligheid voor het verwijderen van één supportvoorbeeld. Rapporteer betrouwbaarheidsintervallen over taken en random seeds, niet één gunstige prompt.
Active learning kan om labels vragen voor informatieve gevallen, terwijl semi‑supervised methoden ongelabelde data gebruiken onder extra aannames. Retrieval kan dynamisch relevante demonstraties selecteren, maar moet test‑label lekken vermijden. Adaptatie kan snel overfitten, dus beperk updates, gebruik regularisatie en valideer op afzonderlijke voorbeelden. Voor taken met hoge inzet rechtvaardigen enkele labels zelden autonome beslissingen; gebruik het model om prioriteit te geven of review te assisteren totdat voldoende uitkomst‑bewijs bestaat.
Productie‑operatie
Versioneer het basismodel, de embedding of prompt‑template, demonstraties, labelschema en adaptatie‑parameters. Bescherm voorbeelden omdat prompts of gradients gevoelige records kunnen blootleggen. Monitor de prestaties terwijl klassen en taal veranderen, en verfris supportvoorbeelden via een beheerde review in plaats van automatische zelf‑labeling. Few-shot learning vermindert de behoefte aan gelabelde doeldata door gebruik te maken van eerdere structuur; het elimineert niet de noodzaak voor representatieve evaluatie, zorgvuldige taakdefinitie, domeinexpertise of een veilige fallback wanneer de nieuwe taak buiten die voorafgaande kennis valt.
Voorbeeld: few-shot classificatie voor een nieuw product
Een supportteam heeft routeringslabels nodig voor een product met slechts vijf beoordeelde voorbeelden per issue. Het vergelijkt dichtstbijzijnde prototypes in een voorgetrainde embedding, een lineaire head, parameter‑efficiënte fine‑tuning en in‑context prompting. Productfamilies, klanten en latere berichten worden buiten meta‑training en modelselectie gehouden. Herhaalde sampling van supportsets rapporteert klasse‑recall, calibratie, variantie en gevoeligheid voor één verkeerd gelabelde demonstratie.
Berichten met lage zekerheid en zonder ondersteuning worden doorgestuurd naar algemene support, en beoordelaars corrigeren labels via een beheerde wachtrij. Voorbeelden worden geanonimiseerd, versioneerd en nooit geselecteerd uit de uiteindelijke testset. Monitoring volgt nieuwe vocabulaire, klasse‑percentages, correcties en meningsverschillen. Wanneer er voldoende labels zijn verzameld, wordt het few-shot systeem vergeleken met gewone supervised training. Een snelle opzet is nuttig, maar rechtvaardigt geen automatisering als de prestaties onstabiel blijven of als het nieuwe product aanzienlijk verschilt van eerdere taakfamilies.
Implementatie‑bewijs en operationele gereedheid
Een productie‑beslissing vereist meer dan een succesvolle demonstratie. Definieer de beoogde gebruikers, operationele omgeving, inputs, outputs, afhankelijkheden, eigenaar en de consequentie van elke belangrijke fout. Stel een reproduceerbare baseline en een versioneerde evaluatieset op vóór afstemming. Test gewone gevallen, randvoorwaarden, misvormde of ontbrekende input, distributieverandering, uitval van afhankelijkheden, misbruik, en de groepen of omgevingen die waarschijnlijk onderbediend zijn. Meet taakkwaliteit samen met calibratie of onzekerheid, latentie, doorvoersnelheid, resource‑kosten, toegankelijkheid, privacy en beveiliging. Leg elke transformatie en drempel vast zodat een onafhankelijke reviewer het resultaat kan reproduceren en bewijs kan onderscheiden van een aantrekkelijk prototype.
Voor de lancering moet autoriteit worden toegewezen voor release, uitzonderingen, wijzigingen, rollback en pensionering. Gebruik een gefaseerde uitrol, behoud een veilige fallback, en verifieer monitoring met opzettelijk geïnjecteerde fouten. Operationele telemetrie moet input‑kwaliteit, output‑gedrag, model‑ of regelversie, afhankelijkheids‑gezondheid, menselijke overrides en bevestigde uitkomsten onthullen zonder onnodige gevoelige data te verzamelen. Definieer alarmdrempels en een verantwoordelijke, en beoordeel vervolgens real‑world bewijs na implementatie in plaats van aan te nemen dat offline prestaties blijven bestaan. Evalueer opnieuw wanneer gegevensbronnen, gebruikers, modellen, leveranciers, beleid, hardware of doelstellingen veranderen. Een onderhouden systeem heeft ook gedocumenteerde herstel‑, incident‑leer‑, verwijder‑ en retentieprocedures nodig, en een duidelijk moment waarop het moet worden uitgeschakeld of vervangen.
Veelgestelde vragen
Is one-shot learning hetzelfde als few-shot learning?
One‑shot learning is het speciale geval met één gelabeld supportvoorbeeld per klasse of taak. Zero‑shot learning gebruikt geen gelabelde doelvoorbeelden.
Elimineert few-shot learning de behoefte aan data?
Nee. Het verschuift de afhankelijkheid naar pre‑training data, gerelateerde taken, representaties en aannames. De doel‑labels zijn weinig; de totale leergeschiedenis is meestal groot.
Primaire referenties