
AI-basisprincipes
Wat zijn grote taalmodellen (LLM’s)?

 Voeg Unite.AI toe aan je voorkeursbronnen op Google
Een groot taalmodel (LLM) is een neuraal netwerk dat is getraind op grote verzamelingen van sequenties om tokens of gerelateerde taaldoelen te voorspellen. De meeste huidige LLM’s gebruiken transformer-architecturen en kunnen via een gemeenschappelijke interface tekst genereren, classificeren, samenvatten, vertalen, opvragen en transformeren.
Een LLM is geen database of een gegarandeerde redeneerder. De output is een voorwaardelijke voorspelling die wordt gevormd door trainingsdata, post‑training, context, hulpmiddelen en decodering. Vloeiendheid kan samengaan met feitelijke fouten, onzekerheid, vooringenomenheid of onveilig gedrag.
Belangrijkste inzichten
- Tokenisatie zet tekst om in discrete eenheden; embeddings en aandacht bouwen contextuele representaties.
- Pre‑training leert brede patronen, terwijl fine‑tuning en voorkeurmethoden het taakgedrag vormgeven.
- Retrieval en hulpmiddelen kunnen actuele bewijzen of acties toevoegen, maar vereisen aparte permissies en validatie.
- Evalueer het uitgerolde systeem op kwaliteit, onderbouwing, veiligheid, latentie, kosten en drift.
Tokens, transformatoren en pre‑training
Tekst wordt opgesplitst in tokens. Een transformer zet ze om in vectoren, mengt informatie via aandacht‑ en feed‑forward‑lagen, en produceert een waarschijnlijkheidsverdeling over de volgende of ontbrekende token.
Zelf‑supervised doelstellingen genereren trainingssignalen uit ruwe sequenties. Schalen in parameters, data en rekenkracht kan verlies (loss) voorspelbaar verbeteren over bereiken, maar de kwaliteit van de dataset, architectuur, optimalisatie en evaluatie bepalen welke mogelijkheden zich in de praktijk manifesteren.
Post‑training en inferentie
Instruction‑tuning maakt gebruik van demonstraties; voorkeuroptimalisatie kan de output beter laten overeenstemmen met menselijke beoordelingen of een beleid. Bij inferentie definiëren een prompt en gesprekshistorie de context, terwijl temperatuur‑ en sampling‑instellingen de variabiliteit beïnvloeden.
RLHF en vergelijkbare methoden vormen gedrag in plaats van een volledige fact‑checker te installeren. Het model kan nog steeds een plausibel maar onbewezen antwoord genereren.
Retrieval, hulpmiddelen en agents
Retrieval‑augmented generation levert passages die zijn geselecteerd uit een externe collectie. Tool‑aanroepen laat toepassingscode databases raadplegen, berekeningen uitvoeren, zoeken of handelen. Deze patronen scheiden een deel van kennis en uitvoering van de modelgewichten.
De applicatie moet tool‑argumenten valideren, permissies afdwingen, citaten behouden en opgehaalde inhoud behandelen als onbetrouwbare invoer. Vector similarity search ondersteunt retrieval, maar bewijst niet dat een passage het antwoord ondersteunt.
Beperkingen en evaluatie
LLM’s kunnen hallucineren, memoriseerde inhoud blootleggen, kwaadaardige instructies opvolgen, vooringenomenheid reproduceren en falen bij taken die lijken op trainingsvoorbeelden. Een lange context garandeert niet dat elk feit wordt gebruikt of correct wordt verzoend.
Evalueer op representatieve private taken met gedocumenteerde prompts en versies. Meet ondersteuning via bronnen, weigering, calibratie, veiligheid, uitkomsten per subgroep, menselijke werklast, latentie en kosten. Houd toezicht na release omdat modellen, data en gebruikersgedrag veranderen.
Trainingsdata en modelontwikkeling
Pre‑trainingcorpora combineren webpagina’s, boeken, code, academisch materiaal, gesprekken en gelicentieerde of samengestelde bronnen. Pipelines detecteren taal, verwijderen duplicaten, filteren kwaliteit en onveilige inhoud, verwerken persoonlijke gegevens en kiezen mengverhoudingen. Deze keuzes vormen kennis, taaldekking, stijl, vooringenomenheid en memorisatie.
Optimalisatieprocessen batchen token‑sequenties en minimaliseren voorspellingsverlies met gradient descent. Gedistribueerde training verdeelt data, model‑tensors, pipeline‑stages of experts over accelerators. Checkpointing, numerieke stabiliteit, netwerkcommunicatie en fout‑herstel worden bij schaal grote engineering‑uitdagingen.
Evaluatie tijdens training volgt verlies en capaciteitsuites, maar benchmark‑vervuiling kan resultaten opblazen. Houd tijdsperioden en propriëtaire taken apart, zoek naar overlap, en rapporteer exacte prompts, decodering, tools en scoring. Een model kan het gemiddelde verlies verbeteren terwijl regressies verschijnen in veiligheid of bij een low‑resource taal.
Contextvensters, decodering en inferentie
Bij inferentie slaat de key‑value‑cache aandacht‑projecties op voor eerdere tokens zodat ze niet bij elke stap opnieuw berekend hoeven te worden. Cache‑geheugen groeit met het aantal lagen, de sequentie, batch‑grootte en representatie. Kwantisatie en paging verminderen de druk maar kunnen kwaliteit of latentie veranderen.
Greedy decodering kiest de token met de hoogste waarschijnlijkheid; temperatuur herschaalt kansen; top‑k en top‑p beperken de kandidaatset; beam‑search volgt meerdere sequenties. De beste strategie hangt af van of de taak determinisme, diversiteit, gestructureerde output of sequentiekanswaarde waardeert. Valideer altijd het schema na generatie.
Lange context vergroot de hoeveelheid beschikbare informatie, maar garandeert geen terugroep of redenering. Positie, afleiders, tegenstrijdigheden en prompt‑structuur beïnvloeden het gebruik. Retrieval kan een kleinere bewijsmateriaalset selecteren, terwijl samenvatten de geschiedenis comprimeert met het risico detail te verliezen. Meet prestaties over contextlengte en -locatie.
Adaptatie, implementatie en economie
Volledige fine‑tuning werkt alle parameters bij; parameter‑efficiënte methoden werken adapters of low‑rank‑matrices bij; doorlopende pre‑training past domein‑distributie aan; instruction‑ en voorkeur‑tuning vormen de antwoorden. Retrieval is vaak beter voor vaak veranderende feiten, terwijl tuning beter is voor gedrag en taakformaat. De methoden kunnen gecombineerd worden.
Implementatie‑opties omvatten gehoste API’s, beheerde eindpunten, zelf‑gehoste open weights, on‑device modellen en hybriden. Vergelijk gegevensverwerking, versiebeheer, latentie, doorvoer, regio’s, beschikbaarheid, model‑portabiliteit, ondersteuning en totale kosten. Zelf‑hosting draagt de verantwoordelijkheid voor beveiliging, schaalbaarheid, updates en misbruikmonitoring over.
Kosten per token zijn onvolledig. Een zwak model kan retries, langere prompts, meer review of dure fouten vereisen. Meet de kosten per succesvol voltooide taak bij een vereiste kwaliteit en risiconiveau. Gebruik caching, batching, kleinere gerouteerde modellen en deterministische code waar ze de volledige workflow verbeteren.
Voorbeeld: een LLM verankeren in bedrijfsdocumenten
Een documentassistent moet beginnen met een permissie‑bewuste corpus, stabiele document‑identifiers, versie‑ en ingangsdata, parseerbare structuur, en een evaluatieset van beantwoordbare, onbeantwoordbare, ambiguë en conflicterende vragen. Retrieval indexeert fragmenten en metadata, maar fragmentgrootte en overlap moeten overeenkomen met de documentstructuur. Zoekkwaliteit wordt onafhankelijk gemeten vóór generatie zodat een vloeiend model ontbrekend bewijs niet kan verbergen.
Tijdens runtime wordt de gebruiker geauthenticeerd, wordt retrieval gefilterd op toegang, wordt bewijs opgehaald en opnieuw gerangschikt, wordt een begrensde prompt geconstrueerd, wordt een geciteerd antwoord gegenereerd en wordt de vereiste output gevalideerd. Het model moet aangeven wanneer bronnen conflicteren of een antwoord niet ondersteunen. Het gebruik van tools en externe acties vereist aparte autorisatie. Bescherm tegen instructies die in opgehaalde documenten zijn ingebed door inhoud als data te behandelen in plaats van als hoger‑prioriteits systeem‑beleid.
Evalueer retrieval‑recall, citatie‑precisie, antwoord‑correctheid, onderbouwing, weigering, latentie en kosten over rollen en documenttypes. Houd model-, prompt-, index-, parser- en corpus‑versies bij voor elke test. In productie log je bewijs‑ID’s en feedback zonder privé‑tekst bloot te stellen, monitor je nieuw onbeantwoordbare vragen na inhoudsveranderingen, en behoud je een veilige fallback. Een LLM‑interface vervangt geen records‑beheer, toegangscontrole of verantwoordelijke vakinhoudelijke review.
Capaciteitsplanning moet de distributies van prompt‑ en outputlengte, gelijktijdige gebruikers, cache‑gedrag, tool‑latentie en retry‑percentages modelleren. Streaming verbetert de waargenomen latentie maar bemoeilijkt moderatie en annulering omdat onveilige of onjuiste inhoud de gebruiker kan bereiken voordat de volledige respons is gecontroleerd. Stel token‑ en tool‑budgetten in, isoleer tenants, bescherm provider‑referenties, en oefen failover tussen model‑versies uit zonder stilzwijgend het gedrag waar gebruikers op vertrouwen te wijzigen.
Praktische implementatie‑checklist
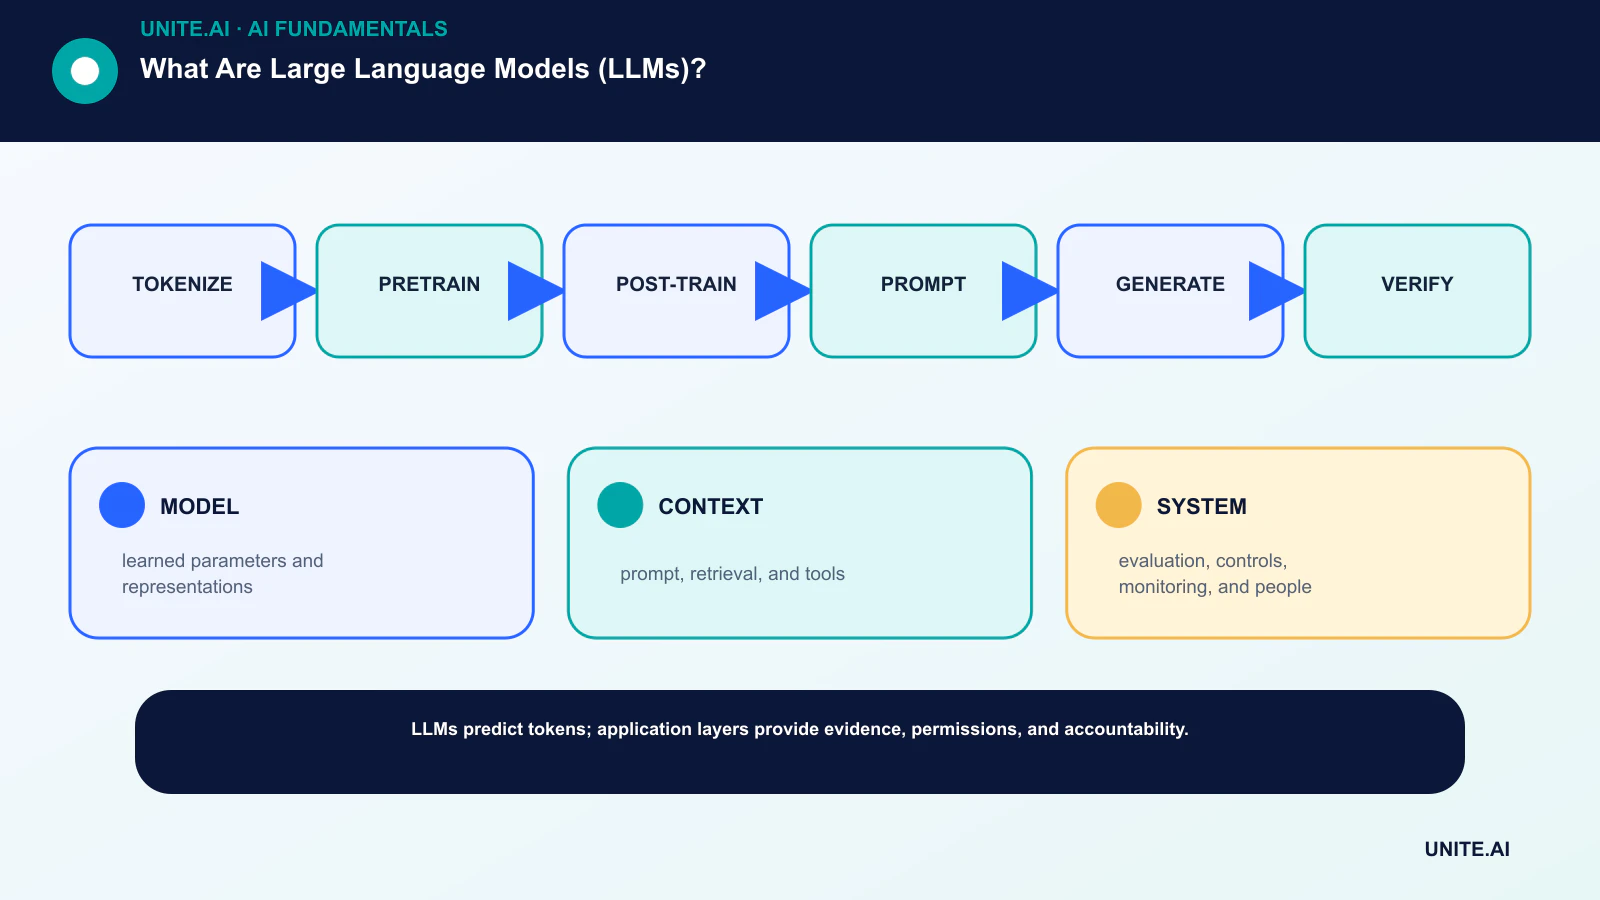
Zet het concept om in een begrensde, testbare workflow: tokeniseren → pre‑train → post‑train → prompt → genereren → verifiëren. Benoem een verantwoordelijke eigenaar, documenteer de data en afhankelijkheden, stel een eenvoudige baseline vast, bepaal acceptatie‑ en stopcriteria, test representatieve fouten, en definieer monitoring, rollback en review voordat de scope wordt uitgebreid. Leg versies en aannames vast zodat een ander team het resultaat kan reproduceren en begrijpt wat er veranderd is.
Voor de lancering voer je een gedocumenteerde readiness‑review uit met de mensen die het systeem bouwen, exploiteren, beveiligen en erdoor worden beïnvloed. Test normale gevallen, grensvoorwaarden, afhankelijkheidsfouten en misbruik; bewaar het bewijs en de onopgeloste risico’s. Definieer wie de release kan goedkeuren, een drempel kan wijzigen, een output kan overschrijven of de operatie kan stoppen. Herzie de beslissing nadat real‑world data beschikbaar is, want een technisch geslaagde pilot garandeert geen betrouwbare prestaties op grotere schaal.
- MODEL: geleerde parameters en representaties.
- CONTEXT: prompt, retrieval en tools.
- SYSTEM: evaluatie, controles, monitoring en mensen.
Veelgestelde vragen
Waarom worden LLM’s ‘groot’ genoemd?
Er bestaat geen universele parameterdrempel. ‘Groot’ verwijst naar de schaal ten opzichte van eerdere taalmodellen, inclusief parameters, trainingsdata, rekenkracht en de breedte van gebruik.
Begrijpen LLM’s taal?
Ze bouwen bruikbare interne representaties en vertonen complex gedrag, maar het woord ‘begrijpen’ heeft verschillende betekenissen. Prestaties moeten taak per taak worden aangetoond in plaats van afgeleid van vloeiendheid.
Primaire referenties












