
AI-basisprincipes
Wat is reinforcement learning met menselijke feedback (RLHF)?

 Voeg Unite.AI toe aan je voorkeursbronnen op Google
Reinforcement learning met menselijke feedback (RLHF) is een verzameling methoden die menselijke oordelen gebruiken om een model te optimaliseren wanneer het gewenste gedrag moeilijk te specificeren is met een eenvoudige automatische beloning. Voor taalmodellen vergelijken mensen doorgaans kandidaatantwoorden en een geleerd voorkeurmodel zet die vergelijkingen om in een trainingssignaal.
RLHF kan een voorgetraind model behulpzamer maken of beter laten aansluiten op een geschreven beleid, maar het bewijst geen waarheidsgetrouwheid of afstemming met elke gebruiker. Het resultaat hangt af van wie de feedback levert, hoe prompts worden bemonsterd, wat het beloningsmodel kan representeren, en hoe de optimalisatie wordt beperkt.
Belangrijkste conclusies
- RLHF volgt meestal pretraining en gesuperviseerde instructietuning.
- Parwise voorkeuren trainen een belonings- of voorkeurmodel; beleidsoptimalisatie geeft vervolgens de voorkeur aan uitvoer met hogere scores.
- Reward hacking, annotatordiscrepantie, distributieverschuiving en overoptimalisatie blijven belangrijke risico’s.
- Evalueer het uiteindelijke beleid direct op taakkwaliteit, veiligheid, calibratie en effecten op subgroepen.
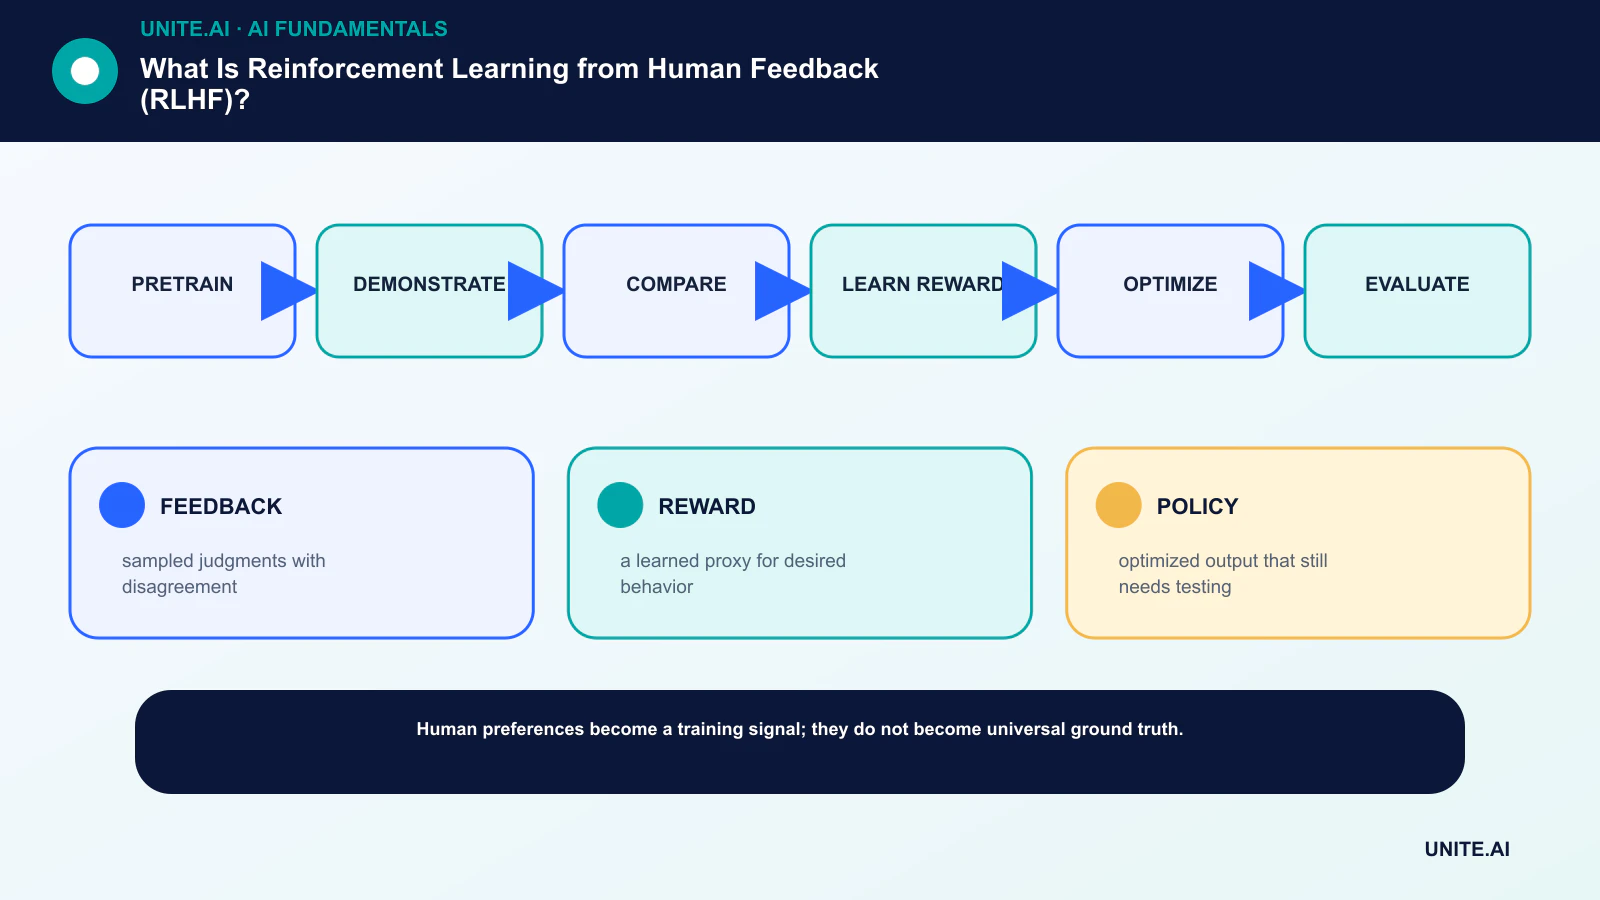
De gebruikelijke RLHF-pijplijn
Een taalmodel leert eerst brede statistische structuren via pretraining. Gesuperviseerde fine‑tuning gebruikt vervolgens demonstraties van gewenste antwoorden. Voor het verzamelen van voorkeuren rangschikken of kiezen annotators tussen uitkomsten voor dezelfde prompt.
Een beloningsmodel leert die vergelijkingen te voorspellen. Een reinforcement‑learning‑algoritme zoals PPO kan het taalmodel optimaliseren ten opzichte van die geleerde beloning, terwijl een straf het model ervan weerhoudt te ver af te drijven van het referentiebeleid.
Feedback is meting, geen grondwaarheid
Annotators kunnen het oneens zijn omdat instructies dubbelzinnig zijn, expertise verschilt, of waarden daadwerkelijk conflicteren. Positie, woordigheid, vertrouwen en stijl kunnen voorkeuren beïnvloeden. Een hoogwaardig programma traint beoordelaars, meet overeenstemming, controleert voorbeelden en behoudt onzekerheid.
Bemonstering is ook belangrijk. Als de voorkeurenset moeilijke talen, domeinen of schadelijke content uitsluit, kan het beloningsmodel ze niet betrouwbaar superviseren. Data‑science discipline is even belangrijk als de optimizer.
Faalmodi
Het beleid kan zwaktes in de geleerde beloning uitbuiten, waardoor uitkomsten hoog scoren zonder de onderliggende intentie te vervullen. Overmatige optimalisatie kan diversiteit verminderen, een voorkeurstijl versterken, of het model zelfverzekerd instemmend maken.
Het beloningsmodel zelf kan falen buiten zijn trainingsdistributie. Teams moeten adversariële prompts, feitelijke taken, weigeringsgrenzen, calibratie en gedrag bij verschillende optimalisatiesterktes testen in plaats van te vertrouwen op één samengestelde voorkeur‑winrate.
Alternatieven en aanvullingen
Direct Preference Optimization leert van voorkeurparen zonder een apart beleid via een online reinforcement‑learning‑lus te passen. Rejection sampling, gesuperviseerde voorkeur‑fine‑tuning, regelgebaseerde feedback en proces‑supervisie bieden andere afwegingen.
Geen enkele methode maakt prompt‑, retrieval‑, tool‑ en applicatieniveau‑controles overbodig. Post‑training vormt gedrag; geïmplementeerde systemen blijven grondig bewijs, permissies, monitoring en menselijke escalatie vereisen.
Hoe voorkeurmodellen worden getraind
Voor een prompt x en twee antwoorden y₁ en y₂ kent een voorkeurmodel scalair scores toe en wordt getraind zodat het geprefereerde antwoord de hogere score krijgt. Een veelvoorkomende verliesfunctie is gebaseerd op de kans dat de ene score de andere overtreft. Dit zet vele parwise oordelen om in een functie die nieuw gegenereerde uitkomsten kan scoren.
Het model leert alle signalen die de verzamelde keuzes voorspellen. Als beoordelaars zelfverzekerde proza, langere antwoorden, specifieke culturele normen of vertrouwde standpunten verkiezen, kunnen die correlaties beloningskenmerken worden. Gebalanceerde instructies, tegenvoorbeelden, deskundige beoordeling en controles op oppervlakkige voorkeuren verminderen het probleem, maar elimineren het niet.
Voorkeursdata kan gelijken, rangschikkingen, kritieken, scalair labels of demonstraties bevatten. De selectie van paren is belangrijk: vergelijkingen tussen duidelijk verschillende antwoorden leren minder over subtiele kwaliteitsgrenzen, terwijl alleen moeilijke paren de training onstabiel kunnen maken. Actieve bemonstering kan informatieve meningsverschillen targeten, maar kan de datadistributie wijzigen.
Beleidsoptimalisatie en regularisatie
PPO‑gebaseerde RLHF bemonstert reacties van het huidige beleid, scoort ze met het beloningsmodel, en werkt het beleid bij om de verwachte beloning te verhogen. Een Kullback–Leibler‑straf of gerelateerde beperking houdt het beleid dicht bij de gesuperviseerde referentie, beperkt destructieve drift en ontmoedigt exploitatie van smalle zwaktes in het beloningsmodel.
De sterkte van optimalisatie is een productkeuze. Te weinig laat het gewenste gedrag onveranderd; te veel kan reward hacking, repetitieve formuleringen, slijmerigheid of verminderde diversiteit veroorzaken. Plot kwaliteit‑ en veiligheidsmetriek tegen beloning en divergentie gedurende de training in plaats van een checkpoint uitsluitend op basis van beloning te kiezen.
Directe voorkeursmethoden ontlenen een doelstelling uit voorkeurparen en een referentiemodel zonder een expliciete online RL‑lus. Ze kunnen training vereenvoudigen, maar erven nog steeds de kwaliteit, dekking en aannames van voorkeuren en referentie‑beleid. Constitutionele of AI‑gegenereerde feedback verandert wie de labels levert; het maakt de noodzaak om waarden en fouten met mensen te valideren niet overbodig.
Evaluatie en datagovernance
Gebruik blinde vergelijkingen, taak‑specifieke tests, adversariële prompts, feitelijkheidscontroles, weigerings‑precisie en recall, en subgroep‑review. Houd evaluators zoveel mogelijk gescheiden van trainingsdata. Een win‑rate ten opzichte van een ouder model kan absolute fouten verbergen wanneer beide kandidaten slecht presteren.
Documenteer de werving van annotators, compensatie, expertise, geografie, taal, instructies, blootstelling aan schadelijke inhoud, meningsverschillen, adjudicatie en kwaliteitscontroles. Feedbackwerk kan psychologisch risico met zich meebrengen, en verantwoorde data‑operaties omvatten ondersteuning voor werknemers en het recht om verontrustende taken af te wijzen.
Na implementatie, monitor voorkeur‑drift en overgeneralisatie. Een beleid afgestemd op informele assistentie kan zich slecht gedragen in medische of juridische contexten. Houd domeingrenzen, retrieval, permissies en escalatie buiten de RLHF‑aanname, en train opnieuw alleen wanneer nieuw bewijs de wijziging rechtvaardigt.
Een concreet RLHF‑trainings‑ en evaluatie‑pipeline
Een typisch project begint met een voorgetraind taalmodel en een instructiedataset die wordt gebruikt voor gesuperviseerde fine‑tuning. Annotators vergelijken vervolgens kandidaat‑antwoorden volgens een geschreven rubric die correctheid, relevantie, stijl, veiligheid en onzekerheid dekt. Parwise voorkeuren trainen een beloningsmodel of optimaliseren het beleid direct. Bemonstering moet gewone taken, moeilijke randgevallen, adversariële prompts, meerdere talen en gebieden waar annotators legitiem oneens zijn omvatten.
De nauwkeurigheid van het beloningsmodel op gereserveerde vergelijkingen is noodzakelijk maar niet voldoende. Het geoptimaliseerde beleid kan fouten in de geleerde beloning exploiteren, overdreven woordig worden, onschuldige verzoeken weigeren, of capaciteiten verliezen. Volg taak‑benchmarks, menselijke voorkeur, calibratie, veiligheid, diversiteit en divergentie ten opzichte van het referentiemodel gedurende de training. Verzamel periodiek nieuwe vergelijkingen van het veranderende beleid zodat de voorkeurdata de uitkomsten dekt die het model daadwerkelijk produceert.
Documenteer wie de voorkeuren heeft geleverd, hun instructies, compensatie, meningsverschillen, kwaliteitscontroles en culturele of domein‑limieten. Gebruik deskundige reviewers waar fouten gespecialiseerde schade kunnen veroorzaken. Red‑team zowel het beloningsmodel als het uiteindelijke beleid, onderhoud gedrags‑regressietests, en fase de implementatie uit. RLHF vormt gedrag volgens gemeten voorkeuren; het bewijst geen waarheidsgetrouwheid, elimineert geen bias, en lost het bredere probleem van het specificeren wat een model in elke context moet doen niet op.
Praktische implementatie‑checklist
Zet het concept om in een begrensde, testbare workflow: pretrain → demonstreren → vergelijken → beloning leren → optimaliseren → evalueren. Benoem een verantwoordelijke eigenaar, documenteer de data en afhankelijkheden, stel een eenvoudige baseline vast, definieer acceptatie‑ en stopcriteria, test representatieve fouten, en bepaal monitoring, rollback en review voordat de reikwijdte wordt uitgebreid. Leg versies en aannames vast zodat een ander team het resultaat kan reproduceren en begrijpt wat er veranderd is.
Voor de lancering, voer een gedocumenteerde gereedheidsreview uit met de mensen die het systeem bouwen, exploiteren, beveiligen en erdoor worden beïnvloed. Test normale gevallen, grensvoorwaarden, afhankelijkheids‑fouten en misbruik; bewaar het bewijs en onopgeloste risico’s. Definieer wie de release mag goedkeuren, een drempel kan wijzigen, een output kan overschrijven, of de werking kan stoppen. Herzie de beslissing zodra real‑world data beschikbaar komt, want een technisch geslaagde pilot garandeert geen betrouwbare prestaties op grotere schaal.
- FEEDBACK: bemonsterde oordelen met meningsverschillen.
- REWARD: een geleerde proxy voor gewenst gedrag.
- POLICY: geoptimaliseerde output die nog getest moet worden.
Veelgestelde vragen
Is RLHF hetzelfde als fine‑tuning?
RLHF is een vorm van post‑training die voorkeur‑afgeleide beloningen gebruikt. Gesuperviseerde fine‑tuning traint direct op doel‑outputs; veel pijplijnen gebruiken beide.
Maakt RLHF een model waarheidsgetrouw?
Het kan gedrag verbeteren dat wordt gemeten door het feedbackproces, maar een model kan nog steeds onjuist, overtuigend of strategisch de beloning exploiteren. Waarheidsgetrouwheid vereist directe evaluatie en onderbouwing.
Primaire referenties












