
AI-basisprincipes
Wat is Deep Reinforcement Learning?

 Voeg Unite.AI toe aan je voorkeursbronnen op Google
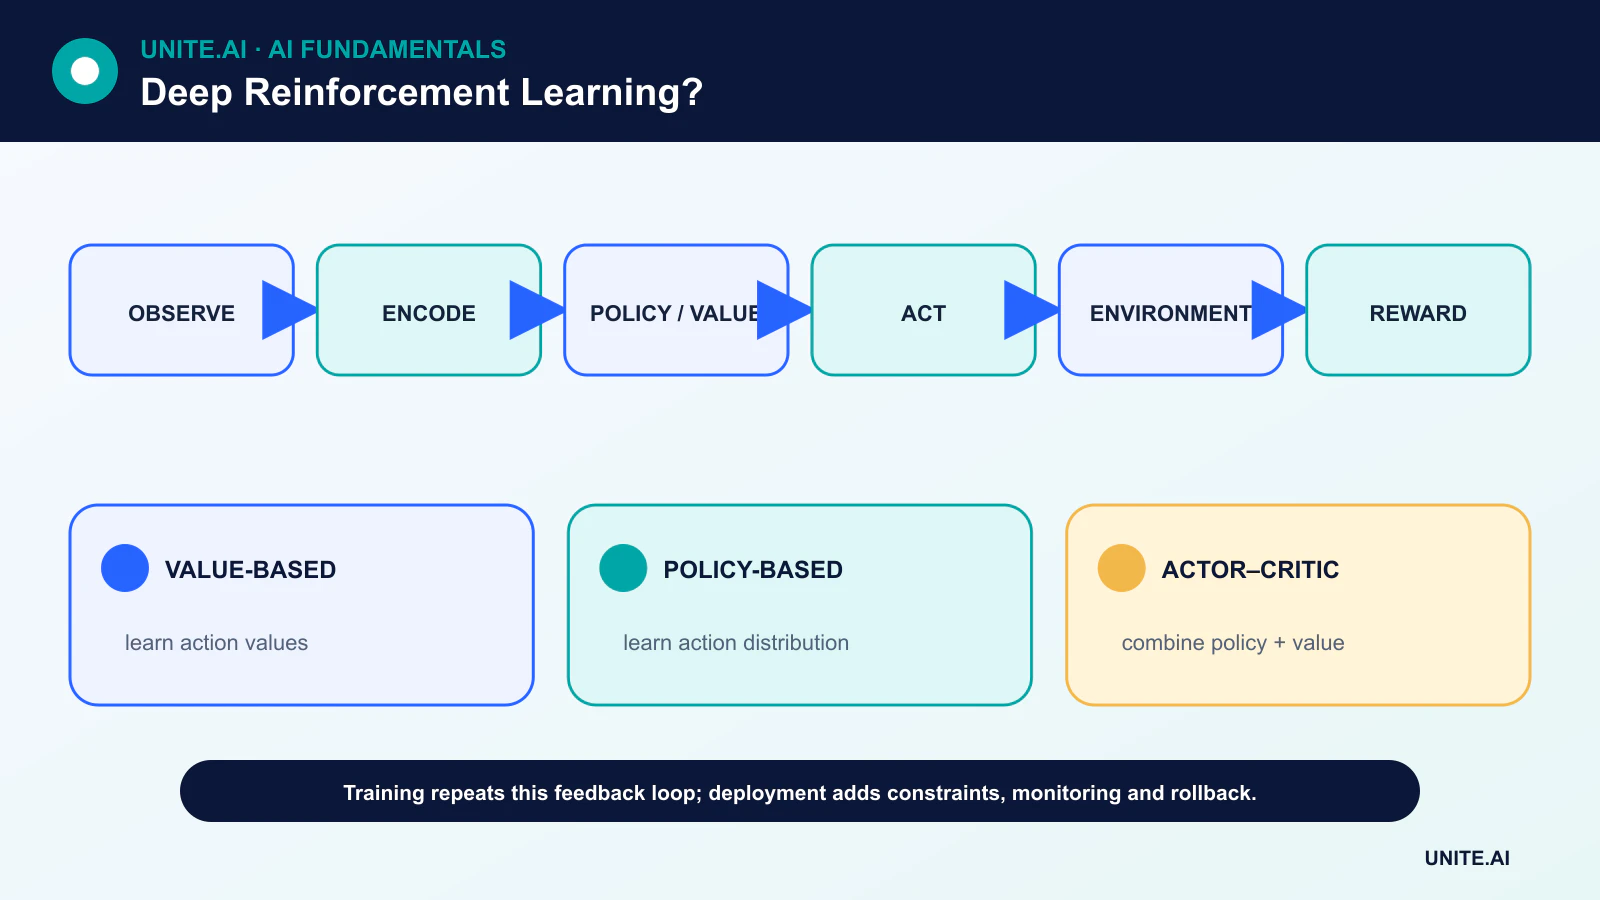
Deep reinforcement learning (deep RL) combineert reinforcement learning met diepe neurale netwerken. Een agent observeert een toestand, kiest een actie, ontvangt een beloning en een nieuwe observatie, en past vervolgens een beleid of waardefunctie aan om toekomstige beslissingen te verbeteren.
Het diepe netwerk verwijdert niet de moeilijke aspecten van reinforcement learning. Het biedt een flexibele manier om afbeeldingen, sensorgegevens, grote actieruimtes of complexe waardefuncties te representeren. Verkenning, vertraagde krediettoekenning, onstabiele training en veilige evaluatie in de echte wereld blijven centrale technische uitdagingen.
Belangrijkste punten
- Deep RL leert opeenvolgende beslissingen uit interactie in plaats van uit een vaste tabel met gelabelde voorbeelden.
- Waarde‑gebaseerde methoden schatten hoe goed acties zijn; beleids‑methoden leren direct de actieverdeling; actor‑critic‑methoden combineren beide.
- Replay‑buffers, target‑netwerken en zorgvuldige beloningsontwerp kunnen de training verbeteren, maar geen van allen garandeert betrouwbaar gedrag.
- Een hoge simulatorscore bewijst geen robuustheid, veiligheid of succesvolle overdracht naar de fysieke wereld.
Het beslissingsprobleem: toestanden, acties en beloningen
Veel deep‑RL‑taken worden gemodelleerd als een Markov‑beslissingsproces. Op tijd t ontvangt de agent een toestand of observatie st, kiest actie at, en ontvangt vervolgens beloning rt+1 en de volgende toestand. Het doel is de verwachte gedisconteerde opbrengst, niet noodzakelijk alleen de volgende beloning.
De discountfactor bepaalt hoe sterk verre beloningen meetellen. Een beloningsfunctie definieert wat het optimalisatieproces nastreeft, dus een onvolledige proxy kan gedrag opleveren dat technisch succesvol is maar operationeel ongewenst. Dit is één reden waarom beloningsontwerp en constraint‑testen dezelfde aandacht verdienen als modelarchitectuur.
Waarde‑gebaseerde, beleids‑gebaseerde en actor‑critic‑methoden
Een waarde‑gebaseerd algoritme schat een toestandwaarde of actiewaarde. Deep Q‑netwerken gebruiken een neuraal netwerk om Q‑waarden te benaderen en kiezen doorgaans de actie met de hoogste schatting, terwijl ze enige verkenning behouden. Een policy‑gradient‑algoritme optimaliseert daarentegen een geparameteriseerd beleid dat een actieverdeling oplevert.
Actor‑critic‑systemen behouden zowel een actor, die acties voorstelt, als een critic, die hun waarde schat. Dit ontwerp ondersteunt continue besturing maar introduceert onderling afhankelijke bronnen van schattingsfouten. Deep RL hangt daarom af van dezelfde fundamenten als deep learning, gradient descent en backpropagation.
Waarom replay‑buffers en target‑netwerken helpen
Aaneengesloten ervaringssamples zijn gecorreleerd, terwijl een netwerkupdate de doelen die later worden gebruikt wijzigt. Experience replay breekt een deel van die temporele correlatie door oudere overgangen te bemonsteren. Een target‑netwerk verandert langzamer dan het online netwerk, waardoor bootstrapped doelen minder volatiel zijn.
Deze mechanismen verbeteren de stabiliteit van de training, maar afstemming blijft belangrijk. Leerrate, verkenningsschema, beloningsschaal, replay‑samenstelling en netwerkgrootte kunnen allemaal het resultaat beïnvloeden. Er moeten meerdere willekeurige seeds worden gerapporteerd, omdat één enkele run misleidend kan zijn.
Offline RL, model‑gebaseerde RL en sim‑to‑real
Offline RL leert van een vaste gelogde dataset zonder nieuwe interacties te verzamelen. Het kan nuttig zijn wanneer verkenning duur of onveilig is, maar het beleid moet acties vermijden die slecht vertegenwoordigd zijn in de log. Model‑gebaseerde RL leert of gebruikt een transitiemodel om te plannen, waarbij extra aannames worden ingeruild voor monster‑efficiëntie.
Robotica traint vaak in simulatie, randomiseert fysieke parameters en verfijnt of valideert vervolgens op hardware. De realiteitskloof kan nog steeds fouten in perceptie, timing, contactdynamiek en niet‑gemodelleerde randgevallen blootleggen. Een reinforcement‑learning-systeem moet worden geëvalueerd onder perturbaties, distributieverschuiving en expliciete veiligheidsconstraints.
Evaluatie en implementatie
Een nuttige evaluatie scheidt trainings‑ en testomgevingen, rapporteert opbrengst‑distributies in plaats van alleen een beste score, en controleert op constraint‑schendingen, interventiefrequentie en worst‑case gedrag. Voor echte systemen hebben teams ook monitoring, rollback‑procedures, begrensde actieruimtes en een menselijke override nodig.
Deep RL is het meest overtuigend wanneer beslissingen opeenvolgend zijn, feedback beschikbaar is en handgeschreven regels ontoereikend zijn. Het is een slechte standaard wanneer er veel gelabelde data beschikbaar zijn, een conventionele optimizer het probleem oplost, of verkenning mensen of activa in gevaar zou brengen.
Deep RL‑architecturen en trainingssignalen
Deep reinforcement learning gebruikt neurale netwerken om een waardefunctie, beleid, omgevingsmodel of een combinatie daarvan te representeren. Een deep Q‑network voorspelt actiewaarden en leert van temporal‑difference‑doelen; experience replay vermindert correlatie tussen updates, terwijl een target‑network het bewegende doel stabiliseert. Policy‑gradient‑methoden optimaliseren de verwachte opbrengst direct, en actor‑critic‑methoden gebruiken een geleerde critic om de gradient‑variantie te verminderen. Continue acties vereisen vaak deterministische of stochastische actor‑critic‑varianten, terwijl discrete, hoog‑dimensionale acties zorgvuldige verkenning en output‑ontwerp nodig hebben.
Training is niet‑stationair omdat het beleid de verzamelde data verandert. Replay‑data wordt off‑policy, bootstrapped doelen hangen af van huidige schattingen, en functiebenadering kan fouten versterken — de combinatie wordt soms de dodelijke triade genoemd. Dubbele schatters verminderen over‑schatting van waarden; advantage‑functies verbeteren credit‑toekenning; entropie‑bonussen stimuleren verkenning; geknipte doelstellingen beperken destructieve beleidsupdates. Normaliseer observaties en beloningen alleen met een lek‑veilige toestand, en registreer omgeving, wrapper, actie‑herhaling, beëindiging en belonings‑pre‑processing omdat elk het probleem wijzigt.
Evaluatie, simulators en implementatie‑veiligheid
Rapporteer opbrengst‑distributies over onafhankelijke seeds en omgevingsinstellingen, niet de beste run. Evalueer monster‑efficiëntie, constraint‑schendingen, catastrofale uitkomsten, gevoeligheid voor beloningsschaal, en robuustheid tegen observatieruis, vertraging, actuator‑fouten en gewijzigde dynamiek. Vergelijk met gescripte besturing, klassieke besturing, gesuperviseerde imitatie en eenvoudigere RL. Houd omgevingsvariaties apart en test uitkomst‑metriek zonder beloning, omdat een agent de geprogrammeerde beloning kan exploiteren terwijl hij de beoogde taak niet voltooit. Video‑ en trajectinspectie onthullen vaak gedrag dat verborgen blijft in de geaggregeerde opbrengst.
Simulatie maakt verkenning mogelijk maar introduceert een realiteitskloof. Randomiseer relevante fysica en perceptie, kalibreer tegen echte metingen, en gebruik een conservatieve overdracht. Gelogde data of offline RL vermijdt online verkenning maar kan acties die niet door het gedragspolicy worden ondersteund niet betrouwbaar evalueren. Productiesystemen moeten de actieselectie, -snelheid, -bronnen en operationele envelope beperken; goedkeuring vereisen voor acties met hoge impact; en een geverifieerde veilige controller of stop‑mechanisme opnemen. Monitor beleid‑inputs, actieverdeling, beloning, echte uitkomsten en interventies, met rollback naar een geteste policy‑versie.
Een concreet besturingsvoorbeeld
Voor het routeren van magazijnrobots definieer je de toestand op basis van locatie, lading, batterij, nabijgelegen verkeer en taakwachtrij; acties op basis van toegestane bewegingen en oplaadbeslissingen; en beloning op basis van voltooide taken, energie, congestie en veiligheidsconstraints. Train eerst in een gekalibreerde simulator met gerandomiseerde vraag en sensorstoringen, en schaduw vervolgens echte beslissingen. Laat het geleerde beleid nooit de botsingsvermijding omzeilen. Evalueer de doorvoer samen met bijna‑ongelukken, deadlocks, batterijnoodgevallen en worst‑case vertraging. Het project slaagt alleen als het gelaagde systeem de operaties verbetert zonder onaanvaardbaar verkenningsrisico over te dragen op mensen of apparatuur.
Voorbeeld: DRL voor koeling van datacenters
Een datacenter beperkt een RL‑agent tot goedgekeurde koelingssetpoints en traint deze in een simulator gekalibreerd op historische weer‑, werkbelasting‑, temperatuur‑ en apparatuurresponsdata. De beloning omvat energie, maar harde constraints beschermen afzonderlijk temperatuur, luchtvochtigheid en cycli van apparatuur. Model‑predictive control en bestaande regels vormen de basislijn. Evaluatie bestrijkt seizoenen, sensorruis, actuatorvertraging, apparatuurverlies, ongewone belastingen en meerdere seeds, en rapporteert energie, overtredingen, variantie en herstel.
Het geleerde beleid draait in shadow‑modus vóór een proef in een beperkt gebied. Een externe veiligheidscontroller beperkt acties en operators kunnen ingrijpen. Actiesnelheid, toestandsdekking, model‑onzekerheid en daadwerkelijke faciliteitsresultaten worden gemonitord; een mismatch in de simulator of herhaalde interventies triggeren rollback. Bijgewerkte apparatuur of besturingslogica creëert een nieuwe omgevingsversie en validatie. Energiebesparingen worden alleen geaccepteerd wanneer betrouwbaarheid, thermisch marges, onderhoud en respons op storingen minstens even sterk zijn als de basislijn.
Implementatie‑bewijs en operationele gereedheid
Een productiebeslissing vereist meer dan een succesvolle demonstratie. Definieer de beoogde gebruikers, operationele omgeving, inputs, outputs, afhankelijkheden, eigenaar en de consequentie van elke belangrijke storing. Stel een reproduceerbare basislijn en een versie‑gebaseerde evaluatieset op vóór afstemming. Test gewone gevallen, randvoorwaarden, misvormde of ontbrekende input, distributieverschuiving, uitval van afhankelijkheden, misbruik, en de groepen of omgevingen die waarschijnlijk onderbediend zijn. Meet taakkwaliteit samen met calibratie of onzekerheid, latency, doorvoer, resource‑kosten, toegankelijkheid, privacy en beveiliging. Leg elke transformatie en drempel vast zodat een onafhankelijke reviewer het resultaat kan reproduceren en bewijs kan onderscheiden van een aantrekkelijk prototype.
Voor de lancering moet autoriteit worden toegewezen voor release, uitzonderingen, wijzigingen, rollback en pensionering. Gebruik een gefaseerde uitrol, behoud een veilige fallback, en verifieer monitoring met opzettelijk geïnjecteerde storingen. Operationele telemetrie moet input‑kwaliteit, output‑gedrag, model‑ of regelversie, afhankelijkheidsstatus, menselijke overrides en bevestigde uitkomsten onthullen zonder onnodige gevoelige data te verzamelen. Definieer alarm‑drempels en een verantwoordelijke voor respons, en beoordeel vervolgens real‑world bewijs na implementatie in plaats van aan te nemen dat offline prestaties blijven bestaan. Her‑evalueer telkens wanneer gegevensbronnen, gebruikers, modellen, leveranciers, beleidsregels, hardware of doelstellingen veranderen. Een onderhouden systeem heeft ook gedocumenteerde herstel‑, incident‑leer‑, verwijder‑ en retentieprocedures nodig, en een duidelijk punt waarop het moet worden uitgeschakeld of vervangen.
Veelgestelde vragen
Is deep reinforcement learning hetzelfde als deep learning?
Nee. Deep learning levert de functie‑approximatoren; reinforcement learning levert de interactie, beloning en het opeenvolgende‑beslissingsdoel.
Betekent een hoge beloning dat de agent het beoogde gedrag heeft geleerd?
Niet per se. Het betekent dat het beleid gedrag heeft gevonden dat goed scoort volgens de geïmplementeerde beloning en omgeving. Onafhankelijke veiligheids‑ en doel‑alignementtests blijven noodzakelijk.
Primaire referenties












