
AI-basisprincipes
Wat is Gradient Descent?

 Voeg Unite.AI toe aan je voorkeursbronnen op Google
Gradient descent is een optimalisatiemethode die modelparameters aanpast om een doelfunctie te verkleinen. Bij het trainen van neurale netwerken is dat doel meestal een verlies dat over voorbeelden wordt berekend. De gradiënt wijst in de richting van de steilste lokale toename, dus gradient descent neemt een stap in de tegenovergestelde richting.
De gradiënt beschrijft de lokale gevoeligheid; de grootte ervan is geen directe meting van hoe snel een model “leert”. Werkelijke voortgang hangt ook af van de leersnelheid, kromming, ruis, parametrisering, optimizer‑status en data.
Belangrijkste conclusies
- Backpropagation berekent gradiënten, terwijl gradient descent ze gebruikt om parameters bij te werken.
- Mini‑batchoptimalisatie is de standaardpraktische aanpak voor deep learning.
- De leersnelheid bepaalt de schaal van de update en kan een schema volgen in plaats van na elke stap te verkleinen.
- Momentum, AdamW, clipping en normalisatie pakken verschillende optimalisatieproblemen aan.
De basis‑update‑regel
Voor parametervector θ, leersnelheid η en verlies L:
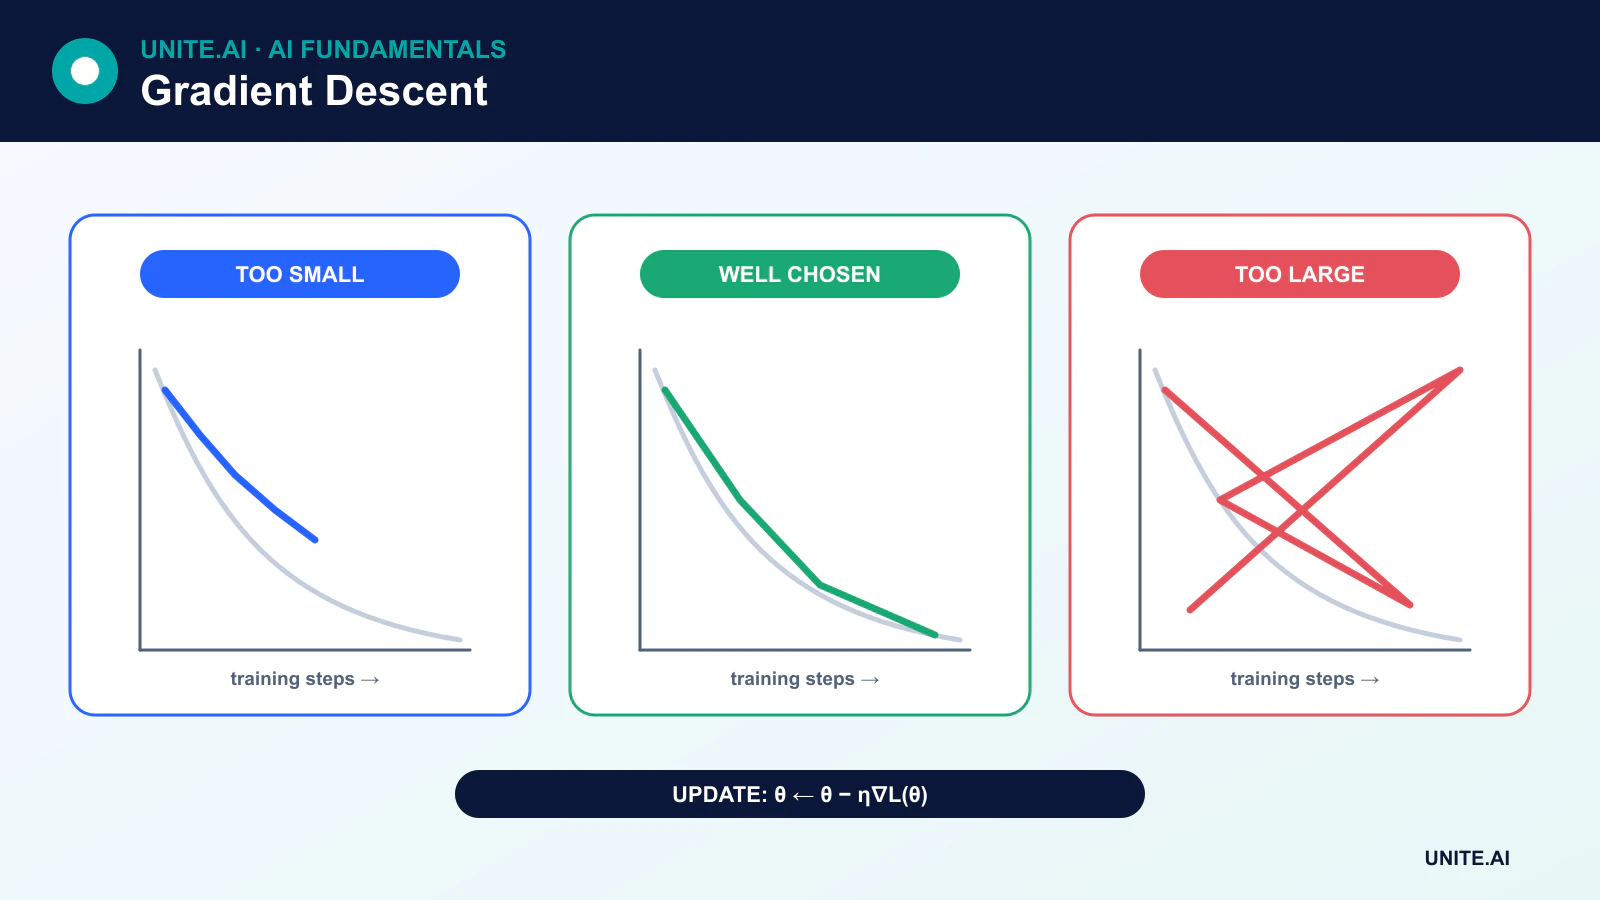
θ ← θ - η∇L(θ)
De gradiënt ∇L(θ) bevat één partiële afgeleide per parameter. Aftrekken ervan beweegt lokaal naar beneden. Een stationair punt heeft gradiënt nul, maar kan een minimum, maximum, zadelpunt of vlak gebied zijn. Verliesoppervlakken in deep learning zijn niet‑convex, dus training garandeert niet dat een uniek globaal minimum of nulverlies wordt gevonden.
Batch-, stochastische en mini‑batchmethoden
Batch‑gradient descent
Batch‑gradient descent berekent een gradiënt met behulp van de volledige trainingsset voor elke update. De schatting is stabiel, maar kan tijd- en geheugenintensief zijn, en één update kan moderne versnellers onderbenutten.
Stochastische gradient descent
Strikte stochastische gradient descent gebruikt één willekeurig geselecteerd voorbeeld per update. De gradiënten zijn ruisachtig, wat de verkenning van het verliesoppervlak kan bevorderen, maar bewerkingen met één voorbeeld kunnen inefficiënt zijn op parallelle hardware.
Mini‑batch gradient descent
Mini‑batchtraining schat de gradiënt op basis van een deelverzameling van voorbeelden. Het balanceert statistische ruis met efficiënte matrixbewerkingen en is de gebruikelijke aanpak in deep learning. De batchgrootte beïnvloedt geheugen, doorvoersnelheid, gradiëntruis, normalisatie en soms generalisatie.
Een leersnelheid kiezen
Een te grote leersnelheid kan nuttige regio’s overschrijden of divergentie veroorzaken. Een te kleine leersnelheid kan training onpraktisch traag maken of vastlopen in vlakke gebieden. De optimale schaal hangt af van de optimizer, batchgrootte, model, initialisatie en doel.
Schema’s kunnen geleidelijk opwarmen, afnemen bij mijlpalen, een cosinuscurve volgen of reageren op validatievoortgang. De leersnelheid hoeft niet monotone te krimpen na elke update. Warme herstarts en cyclische schema’s verhogen deze bewust tijdens delen van de training.
Momentum
Momentum behoudt een exponentieel voortschrijdend gemiddelde van eerdere gradiënten. Het kan voortgang versnellen langs consistente richtingen en oscillatie verminderen over steile, smalle richtingen. Nesterov‑stijl momentum evalueert of benadert de gradiënt nadat er vooruit gekeken is langs de momentum‑richting.
Adaptieve optimizers
RMSProp schaalt updates met behulp van een voortschrijdend gemiddelde van gekwadrateerde gradiënten. Adam combineert momentum‑achtige eerste momenten met schaalverdeling op basis van tweede momenten. AdamW ontkoppelt weight decay van de adaptieve gradiënt‑update en wordt veel gebruikt voor transformers.
Adaptieve optimizers maken vroege training vaak makkelijker, maar ze zijn niet automatisch superieur voor elk model of eind‑generalisatiedoel. Vergelijkingen van optimizers vereisen overeenkomende schema’s en zorgvuldige afstemming.
Gradient clipping en accumulatie
Gradient clipping beperkt de norm of waarden van een gradiënt om de impact van exploderende gradiënten te verminderen, vooral bij recurrente of onstabiele training. Gradient accumulation voegt gradiënten van meerdere kleinere batches samen vóór een update, waardoor een grotere effectieve batch wordt benaderd wanneer geheugen beperkt is.
Optimalisatie monitoren
Volg trainings‑ en validatieverlies, taak‑metriek, leersnelheid, gradiëntnormen, parameternormen en numerieke fouten. Een dalend trainingsverlies met verslechterende validatie‑prestaties duidt op overfitting, niet op een optimalisatiesucces dat automatisch moet doorgaan.
Optimalisatie minimaliseert het opgegeven doel. Een laag verlies bewijst niet dat de data, metriek of gedrag in de echte wereld geschikt zijn. Lekken, slechte labels en een niet‑uitgelijnd doel kunnen een goed geoptimaliseerd maar schadelijk model opleveren.
Optimalisatie‑geometrie en update‑regels
Gradient descent werkt parameters bij in de tegenovergestelde richting van de gradiënt van een verlies. Full‑batch descent gebruikt elk trainingsvoorbeeld per stap; stochastic descent gebruikt één; mini‑batch‑methoden schatten de gradiënt op uit een subset en domineren deep learning. De leersnelheid bepaalt de stapgrootte. Te klein verspilt rekenkracht of loopt vast; te groot oscilleert of divergeert. Momentum accumuleert een voortschrijdende richting, terwijl adaptieve methoden zoals Adam coördinaten schalen met behulp van gradiëntmomenten. Hun verschillende impliciete vooroordelen kunnen modellen opleveren met vergelijkbaar trainingsverlies maar verschillende generalisatie.
Verliesoppervlakken in neurale netwerken bevatten vlakke en scherpe regio’s, zadelpunten, symmetrieën en slecht geconditioneerde richtingen. Feature‑scaling, normalisatie, initialisatie, residual‑verbindingen en preconditionering veranderen de geometrie die de optimizer ziet. Schema’s kunnen opwarmen, afnemen, cyclisch zijn of reageren op plateaus. Weight decay verschilt van louter een L2‑penalty toevoegen in sommige adaptieve optimizers. Batchgrootte beïnvloedt ruis, geheugen, parallelisme en het leersnelheidsregime, dus optimizer‑vergelijkingen vereisen overeenkomende trainingsbudgetten en zorgvuldige afstemming.
Diagnose, reproduceerbaarheid en stoppen
Volg trainings‑ en validatieverlies, taak‑metriek, gradiënt‑ en parameternormen, leersnelheid, doorvoersnelheid en numerieke waarschuwingen. Divergentie kan voortkomen uit corrupte batches, ongeldige labels, onstabiele mixed precision of een onjuiste verliesreductie. Plateaus kunnen duiden op onder‑capaciteit, verzadigde activaties, slechte features, excessieve regularisatie of een schema‑probleem. Overfitting vereist data, augmentatie, regularisatie of early stopping — niet de bewering dat de optimizer gefaald heeft. Inspecteer representatieve fouten en vergelijk een eenvoudige baseline voordat je de trainingscomplexiteit vergroot.
Reproduceerbaarheid vereist seeds, data‑volgorde, code, configuratie, hardware‑ en bibliotheekversies, hoewel sommige accelerator‑kernels nondeterministisch blijven. Sla checkpoints op met optimizer‑ en scheduler‑status zodat training consistent kan worden hervat. Kies een checkpoint op basis van vooraf vastgestelde validatiecriteria en reserveer een onaangetaste testset. Bij gedistribueerde training moet de effectieve batchgrootte, gradiënt‑averaging en afhandeling van falende workers worden bevestigd. Optimalisatie minimaliseert het gekozen doel op beschikbare data; het garandeert geen gekalibreerde waarschijnlijkheden, causaal redeneren, eerlijkheid, veiligheid of bruikbaarheid in de echte wereld.
Voorbeeld: een optimizer afstemmen voor een taalmodel
Een team legt tokenizer, data‑volgorde, model, effectieve batch en trainings‑tokenbudget vast, en vergelijkt vervolgens SGD met momentum en AdamW over verdedigbare leersnelheidsschema’s. Warm‑up, decay, weight decay, clipping en precisie worden gelogd. Elke kandidaat draait met meerdere seeds, en validatie gebruikt een afgehouden tijdssegment plus taak‑evaluaties. Doorvoersnelheid en energie worden gerapporteerd naast het verlies, zodat een iets betere optimizer niet wordt gekozen tegen onevenredige kosten.
Diagnostiek onthult of instabiliteit voortkomt uit één data‑shard, te grote stapgrootte, onder‑flow of modelarchitectuur. Checkpoints bewaren optimizer‑ en scheduler‑status en worden in een test hervat. De uiteindelijke keuze is gebaseerd op validatie‑kwaliteit en robuustheid, niet op het laagste trainingsverlies. Een afgesloten testset wordt eenmaal uitgevoerd na selectie. Productie‑inference wordt apart gekalibreerd en gemonitord omdat optimizer‑succes tijdens pre‑training geen veilig of waarheidsgetrouw gedrag garandeert.
Implementatie‑bewijs en operationele gereedheid
Een productie‑beslissing vereist meer dan een succesvolle demonstratie. Definieer de beoogde gebruikers, operationele omgeving, invoer, uitvoer, afhankelijkheden, eigenaar en de consequentie van elke belangrijke fout. Stel een reproduceerbare baseline en een versie‑gebaseerde evaluatieset vast vóór afstemming. Test gewone gevallen, randvoorwaarden, misvormde of ontbrekende invoer, distributieverandering, uitval van afhankelijkheden, misbruik, en de groepen of omgevingen die waarschijnlijk onderbediend worden. Meet taak‑kwaliteit samen met calibratie of onzekerheid, latentie, doorvoersnelheid, resource‑kosten, toegankelijkheid, privacy en beveiliging. Leg elke transformatie en drempel vast zodat een onafhankelijke reviewer het resultaat kan reproduceren en bewijs kan onderscheiden van een aantrekkelijk prototype.
Voor de lancering moet autoriteit voor release, uitzonderingen, wijzigingen, rollback en pensionering worden toegewezen. Gebruik een gefaseerde uitrol, behoud een veilige fallback, en verifieer monitoring met opzettelijk geïnjecteerde fouten. Operationele telemetrie moet invoerkwaliteit, output‑gedrag, model‑ of regelversie, afhankelijkheidsstatus, menselijke overrides en bevestigde uitkomsten onthullen zonder onnodige gevoelige data te verzamelen. Definieer alarm‑drempels en een verantwoordelijke voor reacties, en beoordeel daarna real‑world bewijs na implementatie in plaats van te veronderstellen dat offline prestaties blijven bestaan. Her‑evalueer telkens wanneer gegevensbronnen, gebruikers, modellen, leveranciers, beleid, hardware of doelstellingen wijzigen. Een onderhouden systeem heeft ook gedocumenteerd herstel, incident‑leren, verwijder‑ en retentieprocedures, en een duidelijk punt waarop het moet worden uitgeschakeld of vervangen nodig.
Veelgestelde vragen
Bereikt gradient descent altijd het globale minimum?
Nee. Voor convexe doelstellingen bieden geschikte voorwaarden sterke garanties. Doelstellingen van diepe netwerken zijn niet‑convex, en praktische optimizers zoeken meestal een bruikbare oplossing in plaats van te bewijzen dat ze het unieke globale minimum hebben gevonden.
Waarom kan een nul‑gradiënt misleidend zijn?
Een nul‑ of zeer kleine gradiënt kan duiden op een minimum, maximum, zadelpunt, verzadiging of een vlak plateau. Trainingsdiagnostiek moet verlies‑geschiedenis, kromming, parameterschaal en validatie‑prestaties in overweging nemen.
Primaire referenties












