
AI-modellen en platforms
Onderzoekers ontwikkelen een benadering om neurale netwerken te vergelijken

 Voeg Unite.AI toe aan je voorkeursbronnen op Google
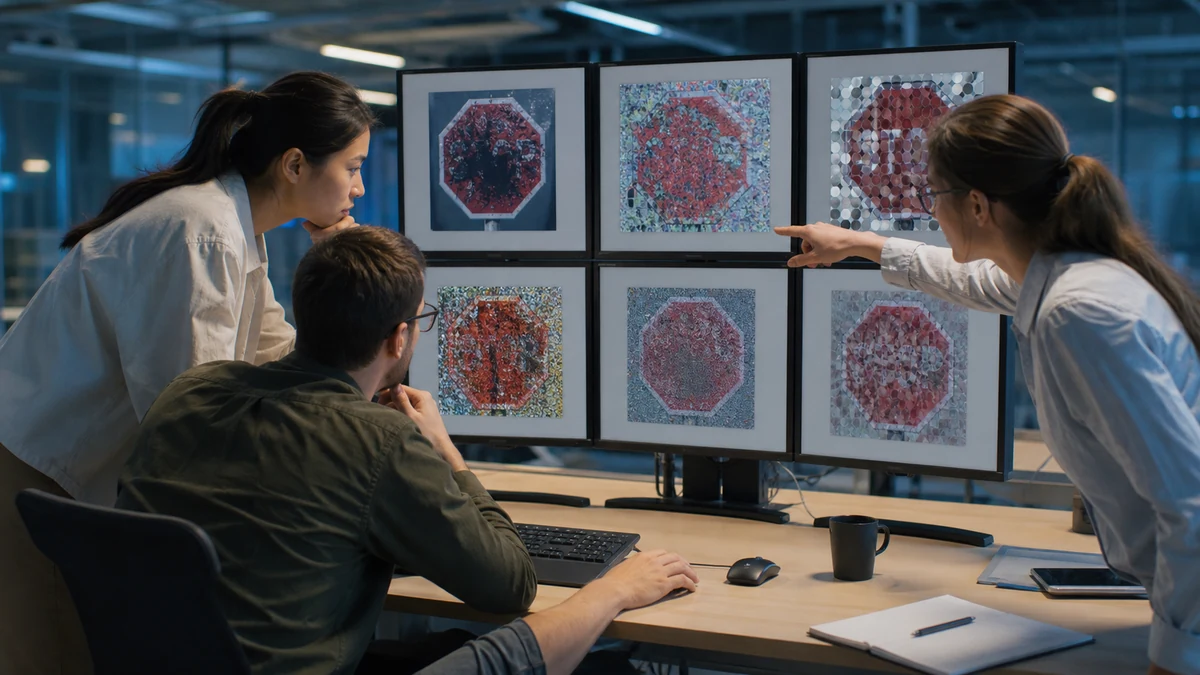
Een team van onderzoekers bij het Los Alamos National Laboratory heeft een innovatieve benadering ontwikkeld voor het vergelijken van neurale netwerken. Volgens het team kijkt deze nieuwe benadering binnenin de “black box” van kunstmatige intelligentie (AI) en helpt hen bij het begrijpen van het gedrag van neurale netwerken. Neurale netwerken, die patronen herkennen in datasets, worden gebruikt voor een breed scala aan toepassingen, zoals gezichtsherkenningssystemen en autonome voertuigen.
Het team presenteerde hun paper, “If You’ve Trained One You’ve Trained Them All: Inter-Architecture Similarity Increases With Robustness,” op de Conference on Uncertainty in Artificial Intelligence.
Haydn Jones is een onderzoeker in de Advanced Research in Cyber Systems-groep bij Los Alamos en de hoofdauteur van het onderzoeksrapport.
Beter Begrijpen van Neurale Netwerken
“De kunstmatige intelligentie-onderzoekscommunity heeft niet noodzakelijkerwijs een volledig begrip van wat neurale netwerken doen; ze geven ons goede resultaten, maar we weten niet hoe of waarom,” zei Jones. “Onze nieuwe methode vergelijkt neurale netwerken beter, wat een cruciale stap is naar een beter begrip van de wiskunde achter AI.
Het nieuwe onderzoek zal ook een rol spelen bij het helpen van experts bij het begrijpen van het gedrag van robuuste neurale netwerken.
Terwijl neurale netwerken hoge prestaties leveren, zijn ze ook kwetsbaar. Kleine veranderingen in omstandigheden, zoals een gedeeltelijk bedekt stopbord dat wordt verwerkt door een autonoom voertuig, kunnen ervoor zorgen dat het neurale netwerk het bord verkeerd identificeert. Dit betekent dat het mogelijk nooit stopt, wat gevaarlijk kan zijn.
Adversariële training van neurale netwerken
De onderzoekers zijn begonnen met het verbeteren van dit soort neurale netwerken door te kijken naar manieren om de robuustheid van het netwerk te verbeteren. Een van de benaderingen houdt in dat men “aanvalt” op netwerken tijdens hun trainingsproces, waarbij de onderzoekers opzettelijk afwijkingen introduceren terwijl ze de AI trainen om deze te negeren. Het proces, dat wordt aangeduid als adversariële training, maakt het moeilijker voor de netwerken om te worden misleid.
Het team paste de nieuwe maatstaf van netwerksimilariteit toe op adversariaal getrainde neurale netwerken. Ze waren verrast om te ontdekken dat adversariële training neurale netwerken in het domein van computerzicht doet convergeren naar vergelijkbare gegevensrepresentaties, ongeacht de netwerkarchitectuur, naarmate de grootte van de aanval toeneemt.
“We vonden dat wanneer we neurale netwerken trainen om robuust te zijn tegenover adversariale aanvallen, ze beginnen hetzelfde te doen,” zei Jones.
Dit is niet de eerste keer dat experts hebben geprobeerd de perfecte architectuur voor neurale netwerken te vinden. Echter, de nieuwe bevindingen laten zien dat de introductie van adversariële training de kloof aanzienlijk verkleint, wat betekent dat de AI-onderzoekscommunity mogelijk niet zo veel nieuwe architecturen hoeft te onderzoeken, aangezien het nu bekend is dat adversariële training verschillende architecturen doet convergeren naar vergelijkbare oplossingen.
“Door te ontdekken dat robuuste neurale netwerken op elkaar lijken, maken we het gemakkelijker om te begrijpen hoe robuuste AI in werkelijkheid zou kunnen werken,” zei Jones. “We kunnen zelfs hints ontdekken over hoe perceptie optreedt bij mensen en andere dieren.”



