AI-basisprincipes
Wat is Machine Learning?

 Voeg Unite.AI toe aan je voorkeursbronnen op Google
Machine learning (ML) is een tak van kunstmatige intelligentie waarin een systeem patronen uit data leert, zodat het voorspellingen, classificaties, aanbevelingen of beslissingen kan maken zonder dat een ontwikkelaar een aparte regel voor elk mogelijk geval schrijft. Het resultaat is geen machine die “denkt” als een persoon. Het is een statistisch model dat invoer naar bruikbare uitvoer mappt en kan worden geëvalueerd op data die het niet heeft gezien tijdens het trainen.
Machine learning bevindt zich binnen het bredere vakgebied van AI, terwijl deep learning een familie van machine-learning methoden is die gebouwd zijn rond meerlagige neurale netwerken. Dit onderscheid is belangrijk: niet elk AI‑systeem maakt gebruik van ML, en niet elk ML‑probleem vereist een neuraal netwerk.
Belangrijkste inzichten
- ML leert een relatie uit voorbeelden in plaats van alleen te vertrouwen op handgeschreven regels.
- Een bruikbaar model moet kunnen generaliseren naar nieuwe data, niet alleen het trainingset memoriseren.
- Supervised, unsupervised, semi-supervised, self-supervised en reinforcement learning lossen verschillende soorten problemen op.
- Datakwaliteit, evaluatie‑ontwerp en monitoring zijn even belangrijk als het algoritme.
Hoe machine learning werkt
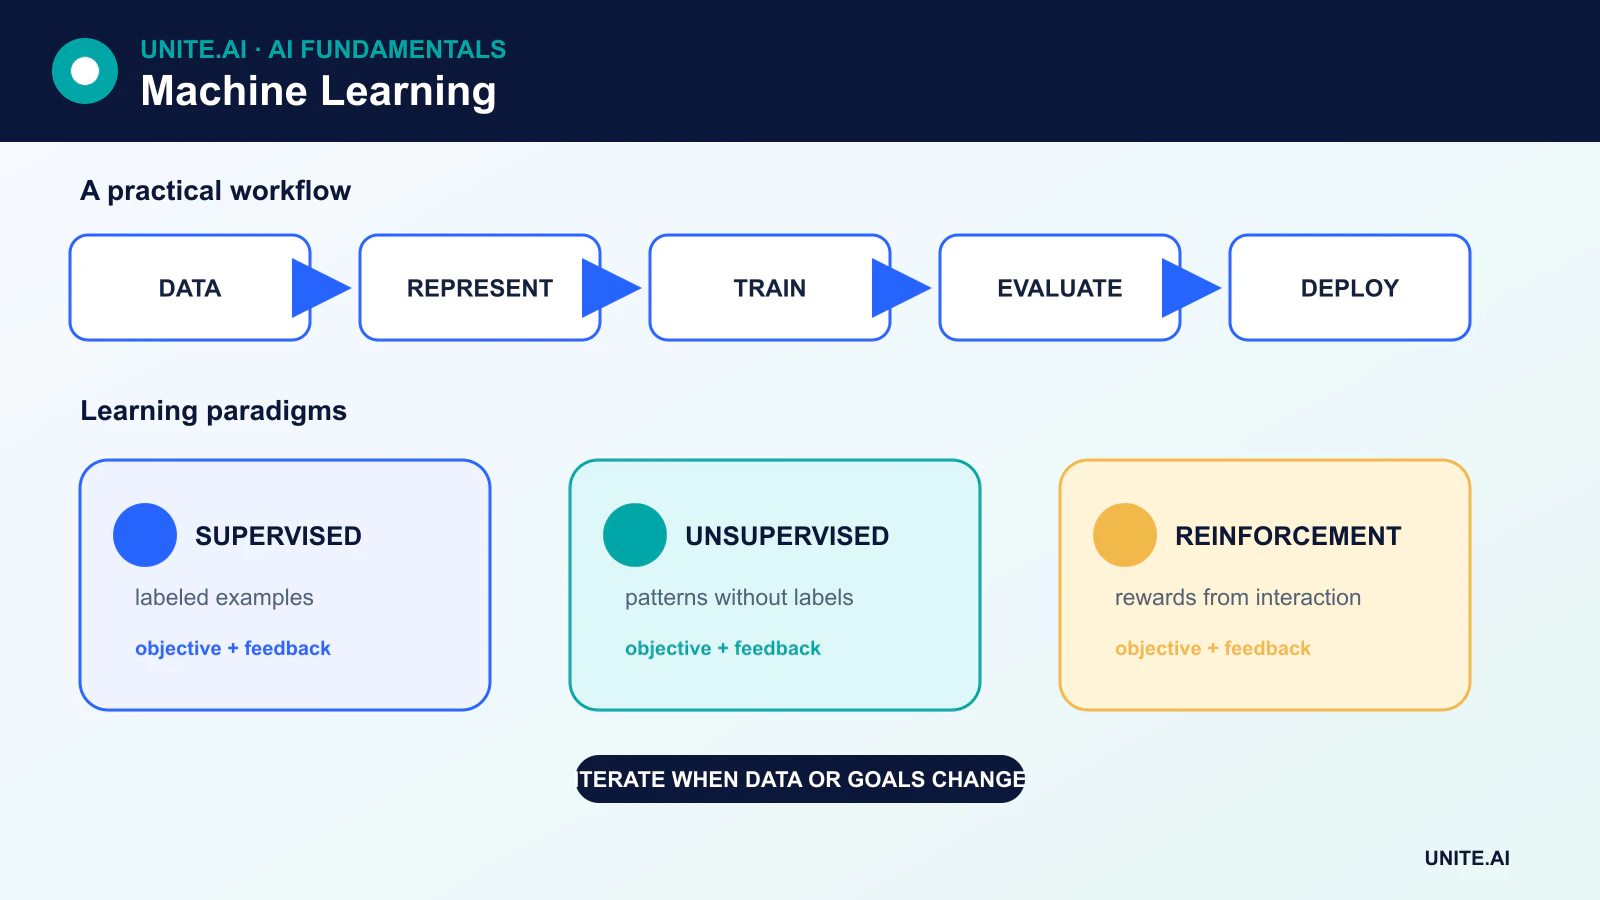
De meeste ML‑projecten kunnen worden begrepen als een reeks van zes fasen:
- Definieer de taak. Bepaal wat het systeem moet voorspellen of ontdekken en wat succes betekent in de echte toepassing.
- Verzamel en bereid data voor. Reinig records, behandel ontbrekende waarden, creëer bruikbare features en documenteer waar de data vandaan komt.
- Splits de data. Een trainingset wordt gebruikt om het model te trainen, een validatieset helpt bij het kiezen van instellingen, en een testset geeft een definitieve schatting op ongeziene data.
- Train het model. Een algoritme past de modelparameters aan om een verliesfunctie te verminderen of een ander leerdoel te behalen.
- Evalueer generalisatie. Meetwaarden moeten de taak, klassenbalans, foutkosten en de populatie waarop het model zal opereren weerspiegelen.
- Implementeer en monitor. Real‑world data kan veranderen, dus teams houden drift, prestatie‑degradatie, bias en operationele storingen in de gaten.
De variabelen die aan een model worden geleverd worden meestal features genoemd. Bij supervised learning wordt het gewenste antwoord het label of de target genoemd. De door een model geleerde parameters coderen een relatie tussen de features en de output; ze vormen geen database van expliciete regels.
De belangrijkste leerparadigma’s
Supervised learning
In supervised learning bevatten voorbeelden zowel invoer als bekende targets. Een classificatiemodel voorspelt categorieën, bijvoorbeeld of een transactie frauduleus is. Een regressiemodel voorspelt een continue waarde, zoals de verwachte energievraag.
Veelvoorkomende supervised‑algoritmen zijn decision trees, support vector machines, K-nearest neighbors, lineaire en logistische regressie, gradient‑boosted trees en neural networks. Een classificatiedrempel zoals 0,5 is een beslissing die wordt genomen nadat een model een score of waarschijnlijkheid heeft geproduceerd; het is geen onveranderlijke eigenschap van logistische regressie.
Unsupervised learning
Unsupervised learning werkt met data die geen target‑labels bevat. Het doel kan zijn om clusters te vinden, ongebruikelijke observaties te detecteren, een distributie te schatten of een lagere‑dimensionale representatie te creëren. Een cluster is een groep die wordt gesuggereerd door een gelijkenisregel; het is niet automatisch een betekenisvolle klasse in de echte wereld.
Voorbeelden zijn K-means clustering, principal component analysis, density estimation en sommige vormen van autoencoders. Een autoencoder leert zijn invoer te reconstrueren via een gecomprimeerde representatie. Het maakt niet automatisch grondwaarheidslabels.
Semi-supervised en self-supervised learning
Semi-supervised learning combineert een kleine gelabelde dataset met een grotere ongelabelde dataset. Self-supervised learning creëert een trainingssignaal uit de data zelf — bijvoorbeeld het voorspellen van gemaskeerde woorden of het matchen van twee getransformeerde weergaven van dezelfde afbeelding. Self‑supervision staat centraal in veel moderne transformer– en foundation‑model pipelines omdat het grote verzamelingen tekst, afbeeldingen, audio of video kan gebruiken zonder dat een persoon elk voorbeeld labelt.
Reinforcement learning
In reinforcement learning onderneemt een agent acties in een omgeving en ontvangt beloningen of kosten. Het doel is een beleid te leren dat de verwachte cumulatieve beloning maximaliseert. Dit verschilt van supervised learning omdat de juiste actie niet voor elke toestand wordt gegeven, en een actie kan beïnvloeden welke data de agent vervolgens tegenkomt.
Training, validatie en generalisatie
Een model dat goed presteert op zijn trainingsvoorbeelden kan nog steeds falen op nieuwe data. Deze fout staat bekend als overfitting. Teams beperken dit door geschikte modelcapaciteit, regularisatie, cross‑validation, data‑augmentatie, het voorkomen van lekken, en een echt onafhankelijke testset.
Er bestaat geen enkele metriek voor elke ML‑taak. Classificatie kan precisie, recall, F1, calibratie of een kostengewichtige maat vereisen in plaats van ruwe nauwkeurigheid. Regressie kan mean absolute error, root mean squared error of een domeinspecifiek verlies gebruiken. Clustering vereist verschillende vormen van interne of extern gevalideerde evaluatie. De metriek moet weerspiegelen wat een fout betekent voor de gebruiker of organisatie.
Machine learning-algoritmen zijn hulpmiddelen, geen garanties
Een algoritme brengt aannames met zich mee. Lineaire modellen gaan uit van een bepaalde vorm van relatie. K-nearest neighbors veronderstelt dat de gekozen afstand een betekenisvolle gelijkenis vertegenwoordigt. Naive Bayes gaat ervan uit dat features conditioneel onafhankelijk zijn gegeven de klasse. Decision trees delen de feature‑ruimte op met behulp van geleerde splitsregels; hun bladeren bevatten voorspellingen gebaseerd op groepen trainingsobservaties in plaats van noodzakelijk één observatie per blad.
De keuze van model hangt daarom af van de datagrootte, het type features, latency‑vereisten, interpretatiebehoeften en de kosten van fouten. Een eenvoudiger model kan een groter model overtreffen wanneer data beperkt is of operationele beperkingen snelheid en transparantie verkiezen.
Waar machine learning wordt toegepast
ML ondersteunt zoekranking, aanbevelingen, voorspellingen, anomaliedetectie, vertaling, spraakherkenning, computer vision, voorspellend onderhoud, fraudedetectie en wetenschappelijke analyse. Dezelfde technieken kunnen ook historische bias versterken, gevoelige informatie blootleggen of onvoorspelbaar gedrag vertonen bij een distributieverandering. Verantwoorde implementatie vereist documentatie, menselijk toezicht waar passend, beveiligingstesten en voortdurende monitoring.
From problem definition to a valid machine-learning experiment
Een machine‑learning project moet beginnen met een beslissing en een meetbaar resultaat, niet met een algoritme. Definieer de voorspellingsunit, target, observatietijd, beslissingstijd, beschikbare features en de kost van elke fout. Voor een churn‑model bijvoorbeeld zou het gebruik van gebeurtenissen die na annulering zijn geregistreerd de uitkomst lekken. Stel een eenvoudige regel of statistische basislijn vast, split vervolgens de data op tijd, klant, locatie of een andere grens die de implementatie weerspiegelt. Willekeurige rij‑splitsingen kunnen bijna identieke observaties in trainings‑ en testsets plaatsen en een misleidende score opleveren.
Feature engineering zet ruwe records om in representaties die het model kan gebruiken, maar elke feature vereist herkomst en een beschikbaarheidsgarantie. Pas normalisatie, vocabulaire, imputatie en dimensionaliteitsreductie alleen toe op trainingsdata, en breng vervolgens de geleerde transformatie aan op validatie‑ en testdata. Cross‑validation schat de variatie over monsters; een definitieve, onaangeraakte testset ondersteunt de release‑beslissing. Kies metriek op basis van consequenties: precisie en recall voor ongelijke classificatiefouten, calibratie wanneer waarschijnlijkheden acties aansturen, en kost‑ of nut‑gewogen maten wanneer fouten verschillende operationele effecten hebben.
Deployment, monitoring, and responsible operation
Productie‑inference herhaalt de volledige transformatie van de trainingsfase en levert een voorspelling binnen latency‑, doorvoers- en beschikbaarheidsbeperkingen. Verpak preprocessing met het model, valideer input‑schema’s, versie‑artefacten en vergelijk resultaten tussen offline‑ en serving‑implementaties. Kies een drempel op basis van de operationele capaciteit en fout‑trade‑off in plaats van standaard 0,5 te gebruiken. Rol uit via shadow‑evaluatie, een beperkte cohort of een experiment met guardrail‑metriek. Houd een deterministische fallback en een rollback‑pad voor afhankelijkheids‑falen of onaanvaardbaar gedrag.
Monitor input‑kwaliteit, feature‑drift, voorspellingsdistributie, calibratie, subgroep‑uitkomsten, latency, kosten en bevestigde labels zodra die beschikbaar komen. Drift is een signaal om te onderzoeken, geen automatisch bewijs dat retraining zal helpen. Retraining vereist beoordeelde data, reproduceerbare tests, goedkeuring en vergelijking met de huidige kampioen. Documenteer beoogde en ongeldige toepassingen, datarights, privacy, beveiliging, menselijke override en beroep waar mensen worden getroffen. Machine learning is een onderhouden beslissingssysteem; het modelbestand is slechts één vervangbaar onderdeel.
Worked example: predicting equipment failure
Een fabrikant definieert één voorspelling per machine‑dag: of er binnen zeven dagen een geverifieerde storing zal optreden, met alleen telemetry die beschikbaar is aan het begin van die dag. Het splitst op machine en tijd, vergelijkt met leeftijd‑ en drempel‑gebaseerde regels, past preprocessing toe op trainingsdata, en evalueert event‑recall, valse waarschuwingen, waarschuwing‑lead‑time, calibratie en onderhoudscapaciteit. Sensorvervanging en geplande stilleggingen worden gemodelleerd als operationele context in plaats van als gewone observaties.
Het model draait eerst in shadow‑modus. Waarschuwingen tonen bijdragende telemetry en onzekerheid, maar beheerders beslissen of ze moeten inspecteren. Bevindingen en bevestigde oorzaken worden beheerde labels; afwezigheid van een werkorder wordt niet verondersteld geen storing te betekenen. Een gefaseerde uitrol gebruikt waarschuwingslimieten en een handmatige fallback, terwijl monitoring sensor‑gezondheid, input‑drift, beoordeelde precisie, downtime en onnodig onderhoud bijhoudt. Retraining vindt alleen plaats nadat data‑ en drempel‑review een waarschijnlijke verbetering ten opzichte van het huidige geïmplementeerde systeem aantonen.
Implementation evidence and operational readiness
Een productie‑beslissing vereist meer dan een succesvolle demonstratie. Definieer de beoogde gebruikers, operationele omgeving, inputs, outputs, afhankelijkheden, eigenaar en de consequentie van elke belangrijke fout. Stel een reproduceerbare basislijn en een versie‑gecodeerde evaluatieset vast vóór afstemming. Test gewone gevallen, randvoorwaarden, misvormde of ontbrekende input, distributieverandering, afhankelijkheids‑uitval, misbruik, en de groepen of omgevingen die waarschijnlijk onderbediend worden. Meet taakkwaliteit samen met calibratie of onzekerheid, latency, doorvoer, resource‑kosten, toegankelijkheid, privacy en beveiliging. Leg elke transformatie en drempel vast zodat een onafhankelijke reviewer het resultaat kan reproduceren en bewijs kan onderscheiden van een aantrekkelijk prototype.
Voor de lancering moet autoriteit worden toegewezen voor release, uitzonderingen, wijzigingen, rollback en pensionering. Gebruik een gefaseerde uitrol, behoud een veilige fallback, en verifieer monitoring met opzettelijk geïnjecteerde storingen. Operationele telemetrie moet input‑kwaliteit, output‑gedrag, model‑ of regelversie, afhankelijkheids‑gezondheid, menselijke overrides en bevestigde uitkomsten onthullen zonder onnodige gevoelige data te verzamelen. Definieer waarschuwingsdrempels en een verantwoordelijke, en beoordeel vervolgens real‑world bewijs na implementatie in plaats van aan te nemen dat offline prestaties blijven bestaan. Herzie telkens wanneer datasources, gebruikers, modellen, leveranciers, beleidsregels, hardware of doelstellingen veranderen. Een onderhouden systeem heeft ook gedocumenteerd herstel, incident‑leren, verwijder‑ en retentieprocedures, en een duidelijk punt waarop het moet worden uitgeschakeld of vervangen nodig.
Primary references