
AI-basisprincipes
Supervised versus unsupervised leren

 Voeg Unite.AI toe aan je voorkeursbronnen op Google
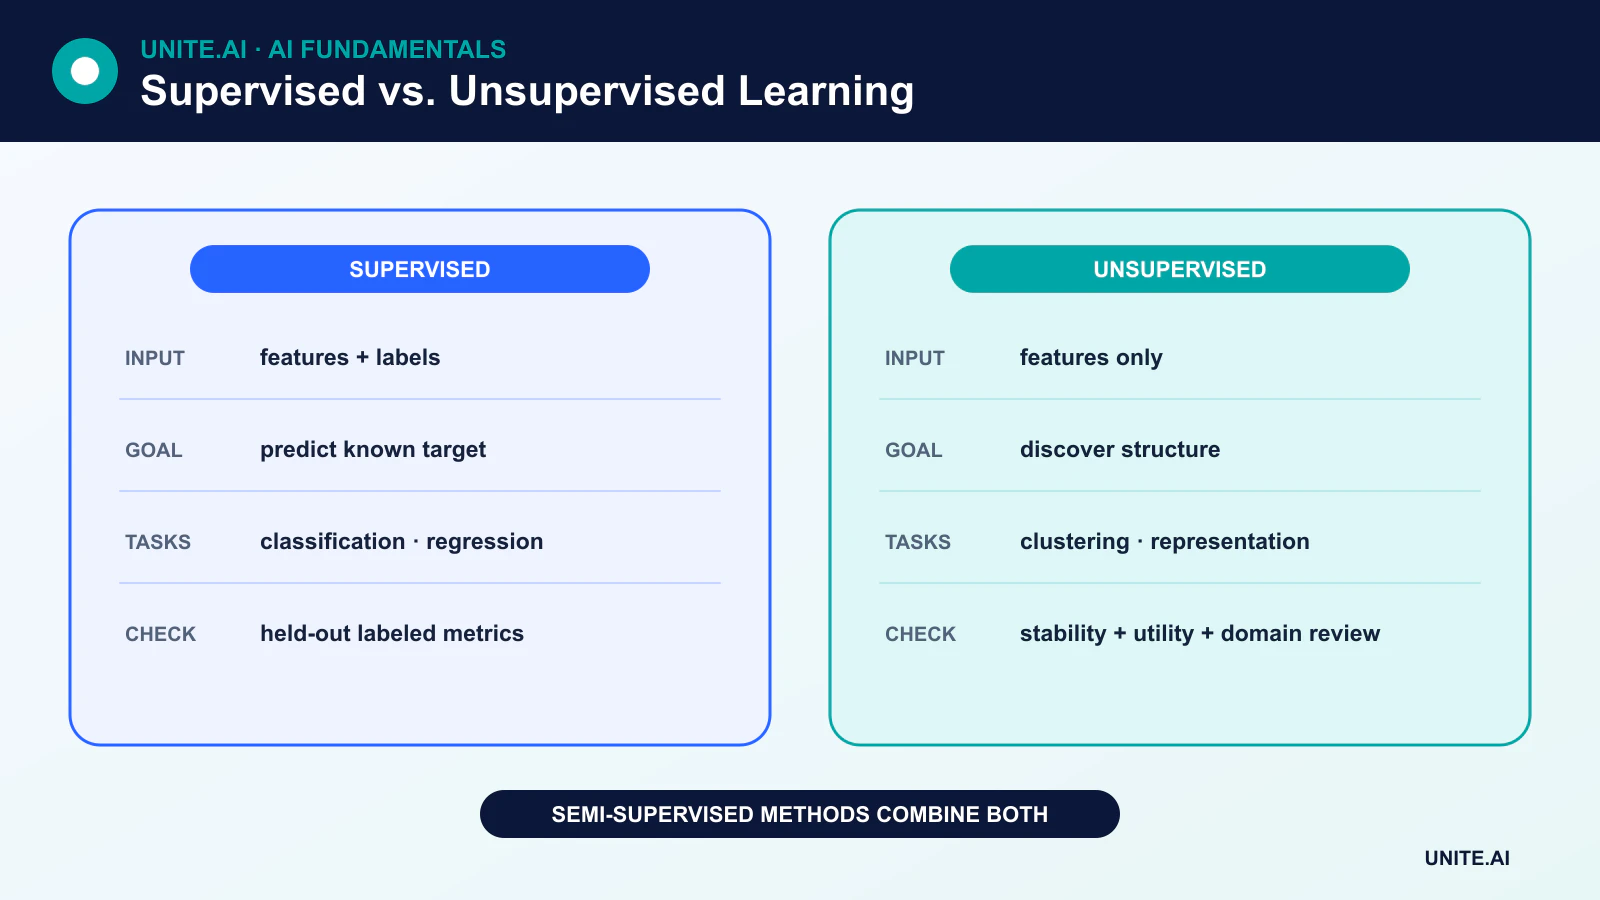
Supervised learning leert van voorbeelden die gekoppeld zijn aan doelantwoorden. Unsupervised learning zoekt naar structuur in data zonder doel‑labels. Het verschil is niet welke aanpak slimmer of nauwkeuriger is; het gaat om het type leersignaal dat beschikbaar is en de vraag die het systeem moet beantwoorden.
Dit zijn twee belangrijke paradigma’s binnen machine learning, maar moderne systemen gebruiken ook semi‑supervised, self‑supervised en reinforcement learning.
Belangrijkste conclusies
- Supervised learning voorspelt een bekende target; unsupervised learning ontdekt patronen of representaties.
- Classificatie en regressie zijn supervised‑taken; clustering, dichtheidsinschatting en veel dimensionaliteitsreductiemethoden zijn unsupervised.
- Unsupervised‑uitvoer is niet automatisch een reële klasse en kan moeilijker te evalueren zijn.
- Rekenkosten en nauwkeurigheid hangen af van het algoritme, de data, de taak en de evaluatie — niet alleen van het paradigma.
Hoe supervised learning werkt
Een supervised‑dataset bevat kenmerken X en een target y. Tijdens het trainen wordt het model aangepast zodat de voorspellingen de targets benaderen. Evaluatie maakt gebruik van gereserveerde gelabelde voorbeelden om te schatten hoe goed het model generaliseert.
Classificatie
Classificatie voorspelt een categorie: spam of geen spam, één documentonderwerp onder meerdere, of één of meer objecten in een afbeelding. Relevante metriek omvatten precisie, recall, F1, calibratie en kosten‑gevoelige maten. Nauwkeurigheid kan misleidend zijn wanneer één klasse zeldzaam is; een confusion matrix toont welke klassen met elkaar worden verward.
Regressie
Regressie voorspelt een continue waarde, zoals vraag, duur of temperatuur. Linear regression kan één of meerdere kenmerken gebruiken; het is niet beperkt tot een relatie tussen twee variabelen. Regressiemetrieken omvatten mean absolute error, root mean squared error en taak‑specifieke kosten.
Veelvoorkomende supervised‑algoritmen
Supervised‑methoden omvatten lineaire en logistieke modellen, decision trees, random forests, gradient boosting, support vector machines, K-nearest neighbors en neurale netwerken.
Logistic regression levert een score of waarschijnlijkheid die met een gekozen drempel naar een klasse kan worden omgezet. Een blad van een decision‑tree bevat een voorspelling gebaseerd op een regio van de feature‑ruimte, niet noodzakelijk één trainingsobservatie. KNN voorspelt op basis van nabijgelegen gelabelde trainingsvoorbeelden en vereist nog steeds een degelijke train/validation/test‑opzet.
Hoe unsupervised learning werkt
Unsupervised learning ontvangt kenmerken zonder een target‑kolom. Het doel wordt indirect gedefinieerd — bijvoorbeeld het minimaliseren van afstand binnen clusters, een invoer reconstrueren, de dichtheid van data schatten, of zoveel mogelijk variantie behouden in minder dimensies.
Clustering
K-means wijst punten toe aan een gekozen aantal clusters en werkt de clustercentra bij om de kwadratische afstand binnen clusters te verkleinen. Het algoritme ontdekt geometrische groeperingen onder een bepaalde afstands‑ en feature‑representatie. Deze groepen komen niet automatisch overeen met betekenisvolle klanttypen, diagnoses of andere domein‑labels.
Dimensionaliteitsreductie
Dimensionality reduction stelt data voor met minder variabelen. Principal component analysis vindt orthogonale richtingen die zoveel mogelijk variantie behouden onder een lineaire projectie. Andere methoden behouden verschillende noties van structuur en kunnen zeer verschillende visualisaties opleveren.
Anomalie‑ en dichtheidsinschatting
Unsupervised‑methoden kunnen inschatten waar data dicht is en ongebruikelijke waarnemingen markeren. Een anomaliescore bewijst geen fraude, falen of kwaadwillig gedrag; het identificeert een afwijking onder de gekozen representatie en het model.
Hoe unsupervised learning wordt geëvalueerd
Er bestaat geen universeel begrip van unsupervised “accuracy”. Een beoefenaar kan interne metriek zoals silhouette‑score gebruiken, stabiliteit over steekproeven vergelijken, bruikbaarheid in een downstream‑taak testen, of domeinexperts vragen of de ontdekte structuur betekenisvol is. Als er grondwaarheids‑labels bestaan voor evaluatie, kunnen externe clustering‑metriek worden gebruikt zonder het trainingsproces om te vormen tot supervised learning.
Voorbij de tweerichtingsvergelijking
Semi‑supervised learning
Semi‑supervised learning combineert een kleinere gelabelde set met een grotere ongelabelde set. Pseudo‑labeling, consistency regularization en op grafen gebaseerde methoden zijn voorbeelden. De ongelabelde data moet nog steeds voldoende lijken op de target‑distributie om nuttig te zijn.
Self‑supervised learning
Self‑supervised learning haalt doelen uit de invoer zelf, zoals het voorspellen van gemaskeerde tokens of het matchen van getransformeerde weergaven. Het vormt een basis voor moderne taal-, visie‑ en multimodale modellen, inclusief transformers.
Reinforcement learning
Reinforcement learning optimaliseert beslissingen via beloningen die voortkomen uit interactie. Het verschilt van zowel gelabelde voorspelling als statische patroonontdekking.
De juiste aanpak kiezen
Begin met de beslissing of het inzicht dat het systeem moet leveren. Als betrouwbare targets bestaan en voorspelling het doel is, is supervised learning vanzelfsprekend. Als het doel verkenning, representatie of groepering is, kan een unsupervised‑methode passen. Wanneer labels schaars zijn, kan self‑supervised of semi‑supervised pretraining gevolgd door supervised evaluatie effectiever zijn.
In elk geval kunnen data‑lekkage, bevooroordeelde sampling, zwakke proxy’s en distributieveranderingen de keuze van algoritme overheersen. Een technisch correct model dat op een verkeerd doel is getraind, kan nog steeds falen.
Leersignalen, doelstellingen en representatieve methoden
Supervised learning gebruikt voorbeelden gekoppeld aan target‑labels of -waarden en optimaliseert de voorspellingsfout. Classificatie, regressie, ranking en gestructureerde voorspelling verschillen in output en verlies. Unsupervised learning zoekt structuur zonder target‑labels via clustering, dichtheidsinschatting, dimensionaliteitsreductie, representation learning of generatief modelleren. Self‑supervised learning creëert voorspellingsdoelen uit de data zelf, terwijl semi‑supervised learning een kleine gelabelde set combineert met grotere ongelabelde data. Deze categorieën beschrijven het leersignaal; dezelfde neurale architectuur kan onder meerdere paradigma’s worden getraind.
Labels maken een doel expliciet, maar brengen annotatiekosten, ruis, beleidsassumpties en tijdsvertraging met zich mee. Ongelabelde data is makkelijker te verzamelen, maar vertelt een algoritme niet welke ontdekte structuur bruikbaar is. Een cluster kan verlichting, documentlengte of acquisitie‑bron weerspiegelen in plaats van een betekenisvolle categorie. Definieer evaluatie onafhankelijk: supervised‑modellen gebruiken gereserveerde gelabelde uitkomsten, terwijl unsupervised‑modellen stabiliteit, reconstructie, likelihood, retrieval, downstream‑nut of expertvalidatie nodig hebben. Visuele scheiding alleen is geen bewijs van een geldige structuur.
Een paradigma kiezen en veelvoorkomende fouten voorkomen
Gebruik supervised learning wanneer een stabiele target en representatieve labels bestaan. Gebruik unsupervised verkenning om samen te vatten, nieuwigheid te detecteren, te comprimeren of hypothesen te genereren, maar beschouw de output als voorlopig. Self‑supervised pretraining is waardevol wanneer ruwe data overvloedig is en downstream‑taken dezelfde representaties delen. Semi‑supervised methoden helpen alleen wanneer aannames over ongelabelde data en klasse‑structuur kloppen. Vergelijk met eenvoudige baselines en houd rekening met de totale kosten van verzameling, labeling, review, berekening en fouten in plaats van aan te nemen dat ongelabelde data automatisch goedkoop is.
Voorkom lekkage door gerelateerde entiteiten te scheiden voordat labels, augmentaties of pseudo‑labels worden afgeleid. Houd klassebalans, annotatie‑overeenstemming, cluster‑stabiliteit, collapsen en drift in de gaten. Pseudo‑labels kunnen vroege fouten versterken; clustering kan gevoelige attributen coderen; een voorgetrainde representatie kan bronbias overdragen. Menselijke review moet zich richten op grensgevallen en consequenties. In productie moet worden gedocumenteerd hoe het leersignaal is gecreëerd en wanneer het verouderd raakt. Het paradigma bepaalt waar supervisie het systeem binnenkomt, niet of menselijke keuzes en waarden aanwezig zijn.
Praktijkvoorbeeld: ontdekken en labelen van support‑onderwerpen
Een bedrijf gebruikt eerst unsupervised embeddings en clustering om thema’s in geanonimiseerde support‑berichten te verkennen. Analisten inspecteren representatieve en grensvoorbeelden en ontdekken dat sommige clusters de berichtlengte en het kanaal weerspiegelen in plaats van problemen. Ze ontwikkelen een supervised taxonomie met een onbekende klasse, annotatierichtlijnen en gemeten overeenstemming. Een classifier wordt vervolgens geëvalueerd op latere tijdsperioden, talen en producten tegen keyword‑ en nearest‑neighbor‑baselines.
Ongelabelde nieuwe berichten ondersteunen drift‑detectie maar trainen de classifier niet automatisch opnieuw. Reviewers labelen geselecteerde onzekere en opkomende gevallen via active learning, met kwaliteitscontroles en een gesloten evaluatieset. Monitoring volgt de prevalentie van topics, vertrouwen, meningsverschillen en routeringsresultaten. Wanneer een nieuw product wordt gelanceerd, worden de taxonomie en de capaciteit van downstream‑teams gezamenlijk bijgewerkt. De workflow gebruikt unsupervised methoden voor hypothesegeneratie en supervised bewijs voor operationele routering.
Implementatie‑bewijs en operationele gereedheid
Een productie‑beslissing vereist meer dan een succesvolle demonstratie. Definieer de beoogde gebruikers, operationele omgeving, inputs, outputs, afhankelijkheden, eigenaar en de consequentie van elke belangrijke fout. Stel een reproduceerbare baseline en een versie‑gebaseerde evaluatieset op vóór afstemming. Test gewone gevallen, grensvoorwaarden, misvormde of ontbrekende input, distributieverandering, uitval van afhankelijkheden, misbruik, en de groepen of omgevingen die waarschijnlijk onderbediend zijn. Meet taakkwaliteit samen met calibratie of onzekerheid, latency, doorvoer, resource‑kosten, toegankelijkheid, privacy en beveiliging. Leg elke transformatie en drempel vast zodat een onafhankelijke reviewer het resultaat kan reproduceren en bewijs kan onderscheiden van een aantrekkelijk prototype.
Voor de lancering moet autoriteit voor release, uitzonderingen, wijzigingen, rollback en pensionering worden toegewezen. Gebruik een gefaseerde uitrol, behoud een veilige fallback, en verifieer monitoring met opzettelijk ingevoerde fouten. Operationele telemetrie moet de input‑kwaliteit, output‑gedrag, model‑ of regelversie, gezondheid van afhankelijkheden, menselijke overrides en bevestigde uitkomsten onthullen zonder onnodige gevoelige gegevens te verzamelen. Definieer alarm‑drempels en een verantwoordelijke, en beoordeel vervolgens real‑world bewijs na de implementatie in plaats van aan te nemen dat offline prestaties blijven bestaan. Her‑evalueer telkens wanneer datasources, gebruikers, modellen, leveranciers, beleid, hardware of doelstellingen veranderen. Een onderhouden systeem heeft ook gedocumenteerd herstel, incident‑leren, verwijder‑ en retentieverfahren, en een duidelijk moment waarop het moet worden uitgeschakeld of vervangen nodig.
Primaire referenties












