
AI-basisprincipes
Wat is K-means clustering?

 Voeg Unite.AI toe aan je voorkeursbronnen op Google
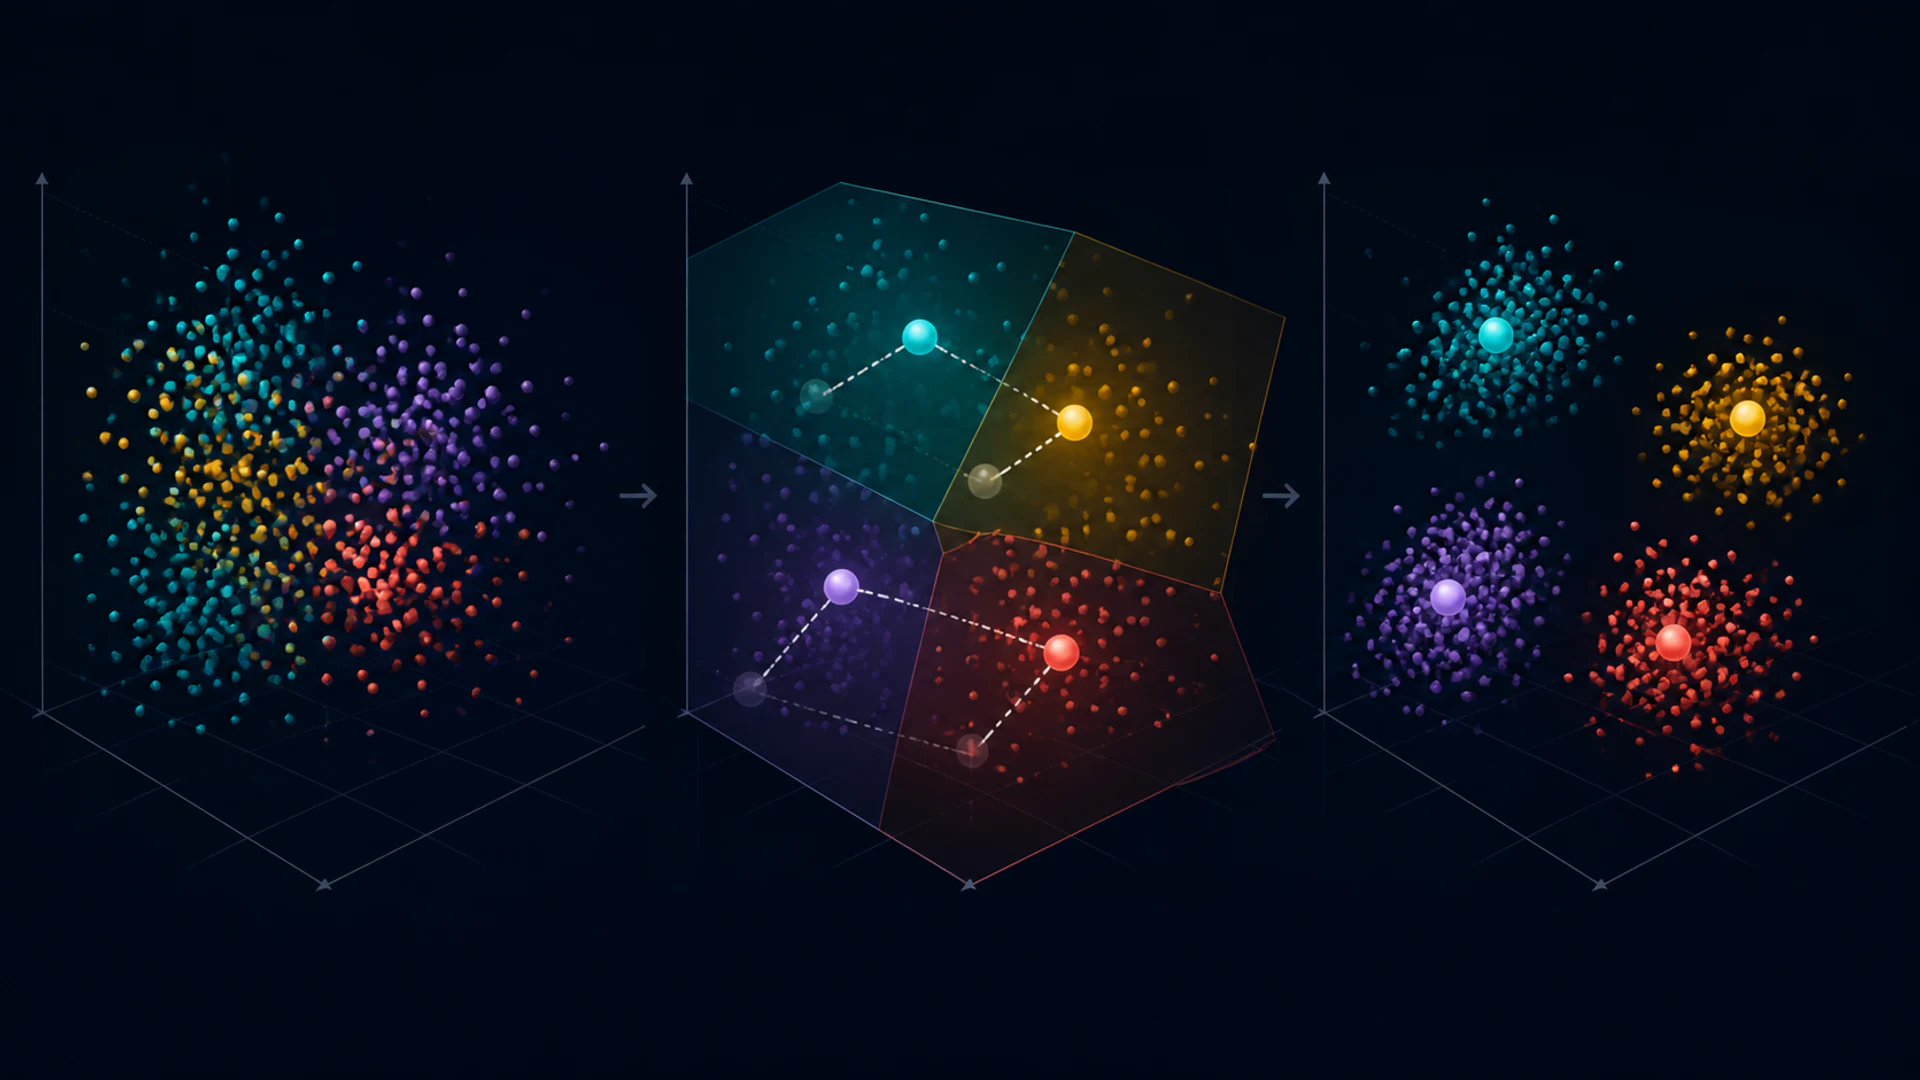
K-means is een onbegeleide algoritme dat numerieke waarnemingen in k clusters onderverdeelt. Het wisselt af tussen het toewijzen van elk punt aan het dichtstbijzijnde centroid en het herberekenen van elk centroid als het gemiddelde van de toegewezen punten.
Het algoritme is snel en nuttig, maar het resultaat wordt beïnvloed door schaling, afstand, initialisatie en de gekozen k. Een cluster is een wiskundige partitie, niet automatisch een reële categorie.
Belangrijkste conclusies
- K-means minimaliseert de binnen‑cluster kwadratische Euclidische afstand tot de centrioden.
- Initialisatie is belangrijk; k-means++ spreidt de startcentrioden en verbetert meestal de resultaten.
- Standaardiseer kenmerken wanneer hun eenheden of schalen vergelijkbaar moeten bijdragen.
- K-means heeft moeite met uitschieters, niet‑sferische clusters, ongelijke dichtheden en categorische data.
Doel en update‑lus
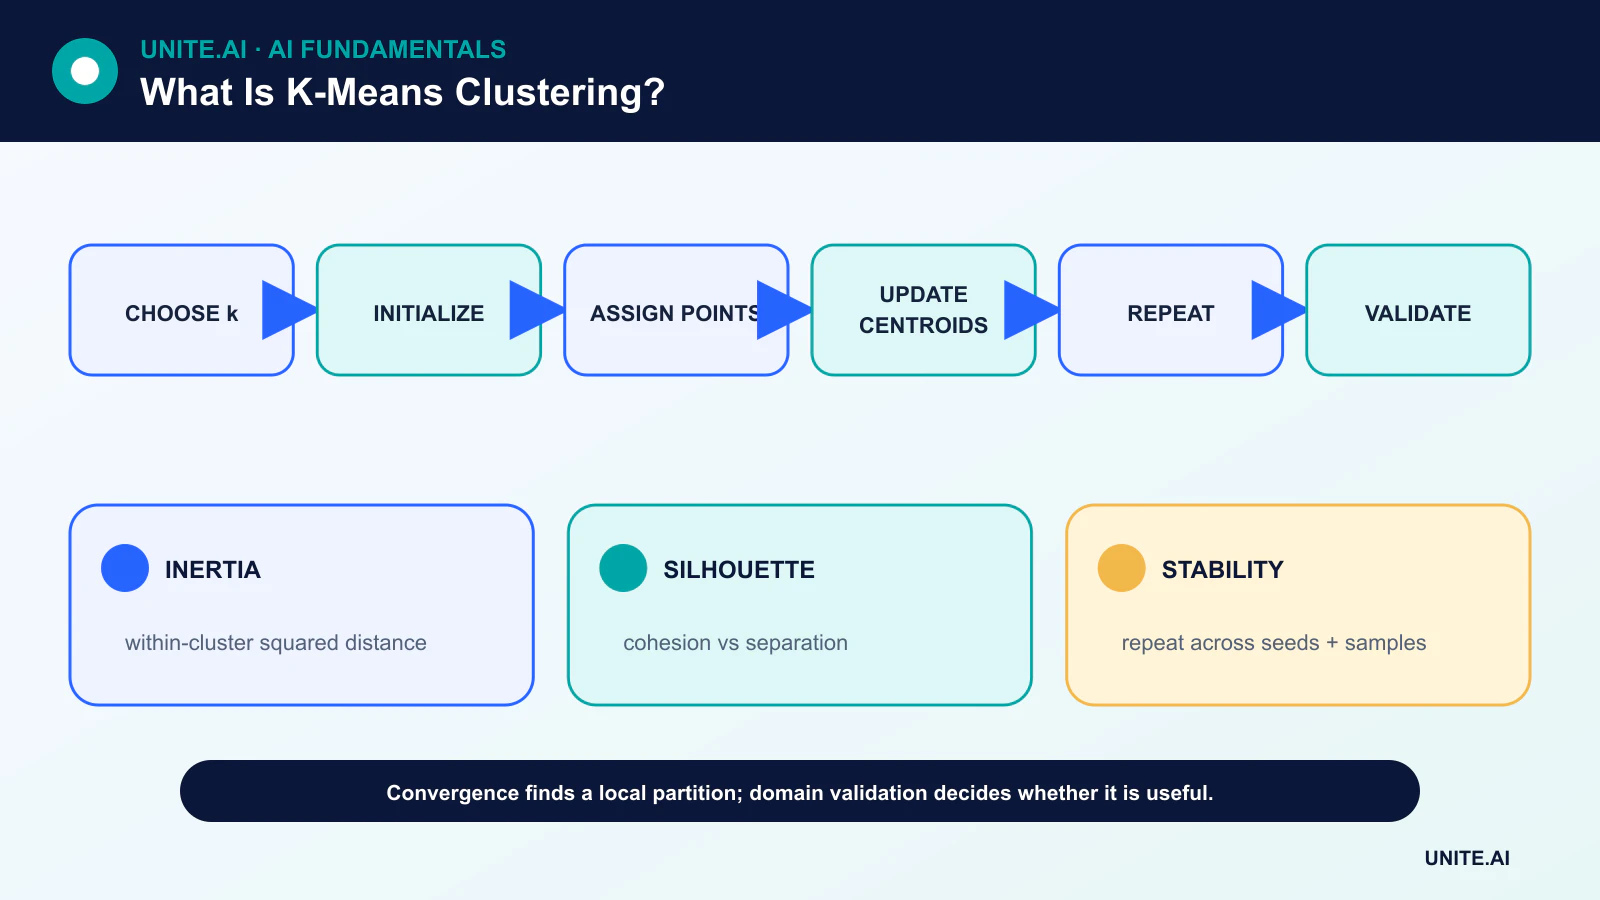
Gegeven k centrioden, wijst de toewijzingsstap elke waarneming toe aan de dichtstbijzijnde. De update‑stap vervangt elk centroid door het gemiddelde van de toegewezen waarnemingen. De binnen‑cluster som van kwadraten kan onder deze stappen niet toenemen, waardoor het proces convergeert naar een lokaal optimum.
Convergentie garandeert niet het globale optimum. Verschillende initiële centrioden kunnen tot verschillende partities leiden, daarom voeren implementaties meerdere initialisaties uit en behouden ze de oplossing met de laagste inertie.
Initialisatie en k-means++
Het willekeurig kiezen van alle startcentrioden uit één dichte regio kan een slechte oplossing of trage convergentie opleveren. K-means++ kiest zaadpunten met een kans die gerelateerd is aan de afstand tot bestaande zaadpunten, waardoor de dataset beter wordt bestreken.
Meerdere runs blijven nuttig. Noteer de willekeurige seed en het aantal initialisaties zodat resultaten reproduceerbaar zijn.
Schalen en afstand
Kwadratische Euclidische afstand maakt K-means gevoelig voor eenheden. Een kenmerk gemeten in duizenden kan een ander kenmerk gemeten tussen nul en één overheersen. Standaardisatie is gebruikelijk, maar domeinkennis moet bepalen of gelijke genormaliseerde variantie gelijke belangrijkheid weerspiegelt.
Uitschieters kunnen een gemiddelde ver van typische punten trekken. Robuuste schaling, trimmen of methoden gebaseerd op medoids kunnen beter zijn. One‑hot categorische kenmerken creëren een afstandsgeometrie die mogelijk niet overeenkomt met de gelijkenis van categorieën.
K kiezen en clusters valideren
Inertie daalt telkens wanneer k toeneemt, dus kan k niet alleen bepalen. De elleboogheuristiek zoekt naar afnemende verbetering. Silhouet‑analyse vergelijkt samenhang en scheiding. Stabiliteit over monsters en seeds voegt een extra controle toe.
De sterkste validatie is bruikbaarheid voor het beoogde domein. Vergelijk clusters met bekende uitkomsten, deskundige beoordeling of een downstream‑taak zonder te doen alsof post‑hoc labels objectief ontdekt zijn.
Beperkingen en alternatieven
K-means geeft de voorkeur aan compacte, ongeveer sferische groepen van gelijke schaal. Gaussiaanse mengmodellen vertegenwoordigen probabilistische ellipsoïdale componenten; DBSCAN‑achtige methoden identificeren dichte regio’s en ruis; hiërarchische clustering produceert een boom van samenvoegingen.
Dimensionaliteitsreductie kan de snelheid verbeteren of inputs ontgeluiden, maar het toepassen ervan op de volledige dataset kan de validatievraag veranderen. Mini‑batch K-means vermindert de berekening voor grote datasets ten koste van een benaderde update.
Doel, initialisatie en convergentie
K-means verdeelt numerieke waarnemingen in k clusters door de binnen‑cluster kwadratische Euclidische afstand tot centrioden te minimaliseren. Lloyd’s algoritme wisselt af tussen het toewijzen van elk punt aan het dichtstbijzijnde centroid en het herberekenen van centrioden totdat toewijzingen of het doel stabiel zijn. Het convergeert naar een lokaal optimum, niet per se het globale beste. K-means++‑initialisatie spreidt de initiële centra en verbetert meestal de resultaten, maar meerdere seeds blijven belangrijk. Standaardiseer kenmerken wanneer eenheden vergelijkbaar moeten bijdragen, omdat kwadratische afstand variabelen met een hoge schaal en uitschieters vergroot.
De methode gaat uit van ongeveer compacte, sferische, evenredig geschaalde clusters onder Euclidische geometrie. Ze heeft moeite met uitgerekte manifolds, ongelijke dichtheid, categorische data, zware uitschieters en geneste structuren. Lege clusters en dubbele punten vereisen een gedefinieerde afhandeling. Mini‑batch k-means schaalt naar grote datasets met een benaderingscompromis. Voor sparse tekst kan cosinus‑georiënteerde sferische k-means beter de richting overeenstemmen, terwijl mengmodellen, dichtheidsmethoden, hiërarchische clustering of k‑medoids andere aannames coderen.
K kiezen en betekenis valideren
Elleboogcurven, silhouet‑scores, informatieregelcriteria in verwante modellen en stabiliteit kunnen k informeren, maar geen van hen ontdekt een eenduidig correct aantal. Zakelijke bruikbaarheid en domeininterpretatie zijn belangrijk. Pas opnieuw toe over monsters en seeds, vergelijk centroid‑beweging en toewijzingsconsistentie, en valideer clusters op onafhankelijke uitkomsten die niet zijn gebruikt om ze te vormen. Een tweedimensionale projectie kan scheiding vervormen, dus onderzoek afstanden en voorbeelden in de originele of gevalideerde representatieruimte.
Clusters zijn beschrijvende groepen gecreëerd door de geselecteerde kenmerken en metriek; ze zijn geen natuurlijke soorten of causale segmenten. Profielen gebaseerd op dezelfde variabelen die voor clustering zijn gebruikt kunnen circulair zijn. Gebruik achtergehouden attributen en kwantitatieve beoordeling, en controleer of clusters voornamelijk geografie, gegevensbron of gevoelige eigenschappen reproduceren. Kleine clusters kunnen anomalieën of artefacten zijn. Het benoemen van een cluster maakt niet dat elk lid bij het label past.
Implementatie en onderhoud
Sla schaling, kenmerkvolgorde, centrioden, afstandsdefinitie en cluster‑labels samen op. Voor nieuwe punten, monitor de afstand tot het toegewezen centroid en de fractie die ver buiten de trainingsondersteuning valt; bied een onbekende status in plaats van elke case in een cluster te dwingen. Volg cluster‑groottes, centrioden en relevantie van uitkomsten in de loop van de tijd. Hertraining verandert cluster‑identiteiten, dus map of versie downstream‑regels in plaats van stilzwijgend oude namen te hergebruiken. K-means is een nuttige compressie‑ en segmentatie‑basislijn wanneer de geometrie overeenkomt met de vraag, niet een universele ontdekkingsmachine.
Voorbeeld: klantsegmentatie met k-means
Een abonnementsbedrijf standaardiseert gebruikskenmerken over een vaste periode, verwijdert account‑identificatoren en test k over verschillende seeds. Stabiliteit, silhouet en achtergehouden zakelijke uitkomsten worden beoordeeld, maar productteams inspecteren ook representatieve en grensaccounts. Ze ontdekken dat één cluster simpelweg nieuwe klanten met een kortere observatieperiode is, dus wordt diensttijd expliciet behandeld. K-means wordt vergeleken met hiërarchische en dichtheidsgebaseerde alternatieven in plaats van als vanzelfsprekend passend te worden beschouwd. De oefening wordt behandeld als onbegeleid leren, niet als labelontdekking.
Segmenten sturen onderzoek en berichtgevingsexperimenten, niet in aanmerking komen of prijs. Nieuwe accounts die ver van elk centroid liggen, krijgen een onbekende toewijzing. Schaling, kenmerken, centrioden en namen worden ge‑versioneerd, en hertraining map nieuwe clusters alleen naar oude met bewijs. Monitoring volgt cluster‑grootte, afstand en relevantie van uitkomsten. Gevoelige attributen en proxy’s worden geaudit, en het team vermijdt het beschrijven van clusters als natuurlijke persoonlijkheidstypen wanneer ze wiskundige partities van geselecteerd gedrag zijn.
Implementatie‑bewijs en operationele gereedheid
Een productie‑beslissing vereist meer dan een succesvolle demonstratie. Definieer de beoogde gebruikers, operationele omgeving, invoer, uitvoer, afhankelijkheden, eigenaar en de consequentie van elke belangrijke fout. Stel een reproduceerbare basislijn en een ge‑versioneerde evaluatieset op vóór afstemming. Test gewone gevallen, grenscondities, misvormde of ontbrekende invoer, distributieverandering, afhankelijkheidsuitval, misbruik, en de groepen of omgevingen die waarschijnlijk onderbediend worden. Meet taakkwaliteit samen met kalibratie of onzekerheid, latency, doorvoersnelheid, resource‑kosten, toegankelijkheid, privacy en beveiliging. Leg elke transformatie en drempel vast zodat een onafhankelijke beoordelaar het resultaat kan reproduceren en bewijs kan onderscheiden van een aantrekkelijk prototype.
Voor de lancering wijs je autoriteit toe voor release, uitzonderingen, wijzigingen, rollback en beëindiging. Gebruik een gefaseerde uitrol, behoud een veilige fallback, en verifieer monitoring met opzettelijk ingevoegde fouten. Operationele telemetrie moet de invoerkwaliteit, output‑gedrag, model‑ of regelversie, afhankelijkheidsgezondheid, menselijke overrides en bevestigde uitkomsten onthullen zonder onnodige gevoelige gegevens te verzamelen. Definieer alarm‑drempels en een verantwoordelijke, en evalueer vervolgens real‑world bewijs na implementatie in plaats van aan te nemen dat offline prestaties behouden blijven. Her‑evalueer telkens wanneer gegevensbronnen, gebruikers, modellen, leveranciers, beleid, hardware of doelstellingen veranderen. Een onderhouden systeem heeft ook gedocumenteerde herstel‑, incident‑leer‑, verwijder‑ en retentieprocedures nodig, en een duidelijk punt waarop het moet worden uitgeschakeld of vervangen.
Veelgestelde vragen
Is K-means begeleid of onbegeleid?
Het is onbegeleid omdat het kenmerken en een gekozen aantal clusters ontvangt, geen doel‑labels.
Classificeert K-means nieuwe data?
Na het fitten kan een nieuw punt aan het dichtstbijzijnde centroid worden toegewezen. Dat is een cluster‑toewijzing, niet per se een begeleide klasse‑voorspelling.
Primaire referenties












