
AI-basisprincipes
Wat is een KNN (K-Nearest Neighbors)?

 Voeg Unite.AI toe aan je voorkeursbronnen op Google
K-nearest neighbors (KNN) voorspelt een uitkomst op basis van de gelabelde trainingsexemplaren die het dichtst bij een querypunt liggen. Voor classificatie stemmen de buren over de klasse. Voor regressie worden hun doelwaarden gemiddeld of op andere wijze gecombineerd.
KNN is een instantiegebaseerde, niet‑generaliserende methode: fitting slaat voornamelijk de trainingsexemplaren en een optionele zoekindex op. Dat verwijdert niet de noodzaak voor train‑, validatie‑ en test‑splits. Evaluatie op gereserveerde data is essentieel voor het kiezen van k, de afstandsmetriek, feature‑verwerking en stemregel.
Belangrijkste conclusies
- KNN voorspelt lokaal; het verdeelt de dataset niet eerst in clusters.
- Feature‑scaling is cruciaal omdat afstand bepaalt welke voorbeelden als buren tellen.
- Kleine k kan ruisig zijn, terwijl grote k de lokale structuur kan wegvagen.
- Hoge dimensies, irrelevante features, klasse‑onevenwichtigheid en trage zoekacties kunnen de prestaties beperken.
Hoe KNN‑classificatie werkt
- Stel de query en trainingsexemplaren voor in dezelfde feature‑ruimte.
- Bereken de afstand van de query tot de trainingsexemplaren.
- Selecteer de k dichtstbijzijnde exemplaren.
- Voorspel de meerderheidsklasse of gebruik afstand‑gewogen stemmen.
Afstand‑gewogen stemmen geeft dichterbijzijnde buren meer invloed. Gelijke stemmen vereisen een gedocumenteerde regel, en buren op gelijke afstand met verschillende labels kunnen ervoor zorgen dat resultaten afhangen van de volgorde of implementatiedetails.
KNN‑regressie
Voor regressie is de voorspelling doorgaans het gemiddelde van de doelwaarden van de buren. Afstand‑gewogen stemmen kan de invloed van verder gelegen observaties verminderen. Mediaan of robuuste aggregatie kan nuttig zijn wanneer lokale doelwaarden uitschieters bevatten.
Afstandsmetriek
Euclidische afstand is gebruikelijk voor continue features, Manhattan‑afstand telt absolute verschillen op, en cosinusafstand richt zich op richting in plaats van magnitude. Andere metriekën zijn toepasbaar op binaire, categorische, geografische, sequentie‑ of geleerde embed‑data.
Het noemen van KNN “non‑parametrisch” betekent dat het geen vaste eindige‑dimensionale functionele vorm voor de beslissingsgrens aanneemt. Het gaat er wel van uit dat de gekozen representatie en metriek nabije punten relevant voor elkaar maken.
Waarom schalen belangrijk is
Als één feature varieert van 0 tot 1 en een andere van 0 tot 100.000, zal de gewone Euclidische afstand gedomineerd worden door de tweede feature. Standaardisatie, normalisatie of domeinspecifieke transformaties moeten worden getraind op de training‑partition en toegepast op validatie‑, test‑ en productiedata.
Irrelevante features vervormen ook buurten. Feature‑selectie, dimensionaliteitsreductie of geleerde representaties kunnen helpen, maar elke keuze moet worden gevalideerd zonder datalekken.
K kiezen
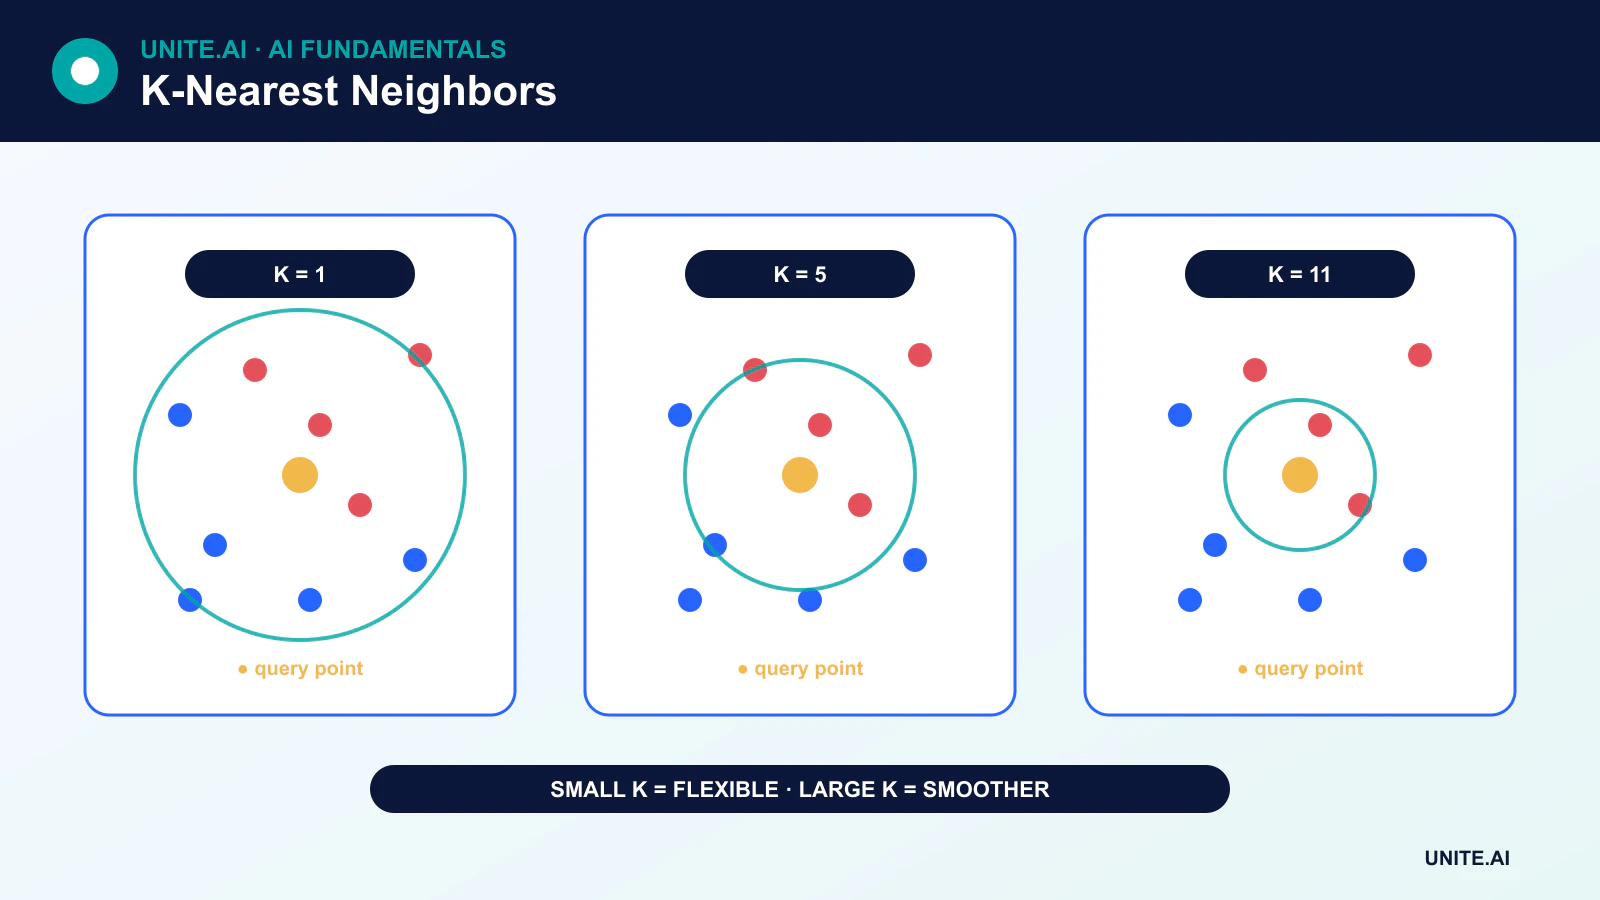
Met k = 1 kan het model ruis en verkeerd gelabelde voorbeelden volgen. Naarmate k groeit, worden voorspellingen vloeiender en minder gevoelig voor één punt. Als k te groot wordt, domineren verre klassen of regio’s en onderfit het model.
Kies k via cross‑validatie op de trainingsdata. Voor binaire classificatie vermindert een oneven k gelijke stemmen, maar elimineert ze niet volledig. Klassen‑gewichten, gestratificeerde splits, drempelkeuze en passende metriek zijn belangrijk wanneer klassen onevenwichtig zijn.
De vloek van de dimensionaliteit
In hoogdimensionale ruimtes kunnen afstanden minder informatief worden omdat voorbeelden schaars zijn en de dichtstbijzijnde en verste afstanden relatief gelijk worden. KNN kan enorme hoeveelheden data vereisen om betekenisvolle lokale buurten te behouden. Dit is de vloek van de dimensionaliteit.
Dimensionaliteitsreductie of taak‑specifieke embeddings kunnen helpen, maar de geometrie van een embedding moet worden gevalideerd voor het beoogde begrip van gelijkenis.
Zoekprestaties
Een brute‑force query vergelijkt het nieuwe punt met elk opgeslagen voorbeeld. KD‑bomen en ball‑bomen versnellen sommige exacte zoekopdrachten, hoewel hun voordelen afnemen in hoge dimensies. Approximate nearest‑neighbor indexen ruilen een kleine hoeveelheid recall in voor grote snelheids‑ en geheugenwinst. Dit idee vormt ook de basis van vector‑similariteitszoekopdrachten.
Kracht en beperkingen
KNN is eenvoudig, ondersteunt onregelmatige beslissingsgrenzen en biedt een intuïtieve voorbeeld‑gebaseerde uitleg. Het kan echter ook veel geheugen vereisen, gevoelige trainingsexemplaren blootleggen, langzaam voorspellen en slecht presteren wanneer afstand niet betekenisvol is. Het is een nuttige basislijn — geen methode die standaard zeer accuraat is voor de meeste problemen.
Afstand, buurten en hyperparameter‑gedrag
K‑nearest neighbors slaat trainingsexemplaren op en voorspelt op basis van de k dichtstbijzijnde volgens een gekozen afstand. Classificatie gebruikt een meerderheids‑ of afstand‑gewogen stemming; regressie neemt het gemiddelde van de doelwaarden van buren. Schalen is essentieel omdat een feature met een groot bereik de Euclidische afstand kan domineren. Categorische, sparse, sequence‑ of geografische data kunnen Hamming, cosinus, bewerkings‑, great‑circle‑ of geleerde afstanden vereisen. De metriek is een model‑aanname over gelijkenis en moet worden gevalideerd tegen de werkelijke betekenis van nabije gevallen.
Kleine k creëert flexibele, hoge‑variantie grenzen en gevoeligheid voor ruis; grote k maakt voorspellingen vloeiender en kan minderheidsstructuren uitwissen. Oneven k voorkomt alleen sommige binaire gelijke stemmen en is geen algemene regel. Kies k, afstand, weging, feature‑set en preprocessing binnen cross‑validatie. Klassen‑onevenwichtigheid kan lokale meerderheidsstemming laten negeren van zeldzame uitkomsten, dus inspecteer per‑klasse recall en samenstelling van de buurt. Hoogdimensionale afstanden neigen te concentreren, en irrelevante features verslechteren buurten; selectie, dimensionaliteitsreductie of geleerde embeddings kunnen helpen.
Indexering, onzekerheid en productie‑operatie
Naïeve inferentie vergelijkt een query met elk training‑punt. KD‑bomen en ball‑bomen helpen in geschikte lage dimensies; approximate nearest‑neighbor indexen ruilen nauwkeurigheid in voor snelheid en schaal. Meet recall van de buurzoektocht apart van de voorspellende kwaliteit. Geheugen omvat opgeslagen features, labels en indexstructuren. Updates zijn conceptueel eenvoudig maar kunnen herbouw van indexen, versie‑consistentie en propagatie van verwijderingen vereisen. Bescherm gevoelige trainingsexemplaren omdat het teruggeven van buren of afstanden records kan blootleggen.
KNN kan voorbeelden naar voren brengen die een voorspelling begrijpelijk maken, maar nabijheid is geen oorzaak of rechtvaardigheid. Geef afstand, stemmarge en een afwezigheidsregel wanneer buurten schaars of conflicterend zijn. Monitor query‑afstand, buren‑labels, feature‑drift, latency en bevestigde uitkomsten. Houd preprocessing‑ en indexversies gesynchroniseerd, en test exacte versus approximate resultaten na wijzigingen. KNN is een effectieve lokale basislijn en opzoekmethode wanneer afstand betekenisvol is; het worstelt wanneer gelijkenis niet kan worden weergegeven door de beschikbare features.
Voorbeeld: KNN voor productvervanging
Een retailer vertegenwoordigt producten met gestandaardiseerde numerieke attributen, categorische compatibiliteit en een geleerde tekst‑embedding, waarna een gewogen afstand wordt gedefinieerd die door merchandisers wordt beoordeeld. K en gewichten worden geselecteerd op basis van latere productlanceringen, niet willekeurige artikelrijen. Evaluatie controleert relevante substituut‑recall, incompatibele aanbevelingen, afstand, categorie‑dekking en resultaten voor zeldzame items. Een populariteits‑basislijn toont of lokale gelijkenis waarde toevoegt.
Een approximate index wordt gebenchmarkt tegen exacte buren voor recall en latency. Queries zonder een dichtbijzijnde compatibele item geven geen suggestie terug in plaats van een geforceerde buur. Productverwijderingen en attribuutcorrecties worden via versie‑updates naar de index doorgevoerd. Monitoring volgt afstandsdistributies, lege resultaten, overrides en commerciële uitkomsten zonder verkoop te verwarren met echte compatibiliteit. Gevoelige leveranciersvoorwaarden worden uitgesloten van verklaringen, en geretourneerde voorbeelden blijven bewijs van gelijkenis — geen bewering dat producten gelijk zijn.
Implementatie‑bewijs en operationele gereedheid
Een productie‑beslissing vereist meer dan een succesvolle demonstratie. Definieer de beoogde gebruikers, operationele omgeving, inputs, outputs, afhankelijkheden, eigenaar en de consequentie van elke belangrijke fout. Stel een reproduceerbare basislijn en een versie‑gebaseerde evaluatieset vast vóór afstemming. Test gewone gevallen, randvoorwaarden, misvormde of ontbrekende input, distributieverschuiving, afhankelijkheidsuitval, misbruik, en de groepen of omgevingen die waarschijnlijk onderbediend worden. Meet taak‑kwaliteit samen met kalibratie of onzekerheid, latency, doorvoersnelheid, resource‑kosten, toegankelijkheid, privacy en beveiliging. Leg elke transformatie en drempel vast zodat een onafhankelijke reviewer het resultaat kan reproduceren en bewijs kan onderscheiden van een aantrekkelijk prototype.
Voor de lancering moet autoriteit worden toegewezen voor release, uitzonderingen, wijzigingen, rollback en pensionering. Gebruik een gefaseerde uitrol, behoud een veilige fallback, en verifieer monitoring met opzettelijk geïnjecteerde fouten. Operationele telemetrie moet input‑kwaliteit, output‑gedrag, model‑ of regel‑versie, afhankelijkheids‑gezondheid, menselijke overrides en bevestigde uitkomsten onthullen zonder onnodige gevoelige data te verzamelen. Definieer alarm‑drempels en een verantwoordelijke, en beoordeel vervolgens real‑world bewijs na implementatie in plaats van aan te nemen dat offline prestaties blijven bestaan. Her‑evalueer telkens wanneer gegevensbronnen, gebruikers, modellen, leveranciers, beleidsregels, hardware of doelstellingen veranderen. Een onderhouden systeem heeft ook gedocumenteerd herstel, incident‑leren, verwijder‑ en retentieprocedures nodig, en een duidelijk punt waarop het moet worden uitgeschakeld of vervangen.
Veelgestelde vragen
Heeft KNN een trainingsfase?
Het heeft weinig parameter‑afstemming, maar er is toch een ontwikkelingsproces: preprocessing wordt geleerd van trainingsdata, er kan een index worden gebouwd, en k, metriek, gewichten en features worden geselecteerd met validatie.
Is KNN hetzelfde als K-means?
Nee. KNN is voornamelijk een gesuperviseerde lokale‑voorspellingsmethode. K-means is een unsupervised clustering‑algoritme waarbij K het aantal clustercentra is.
Primaire referenties












